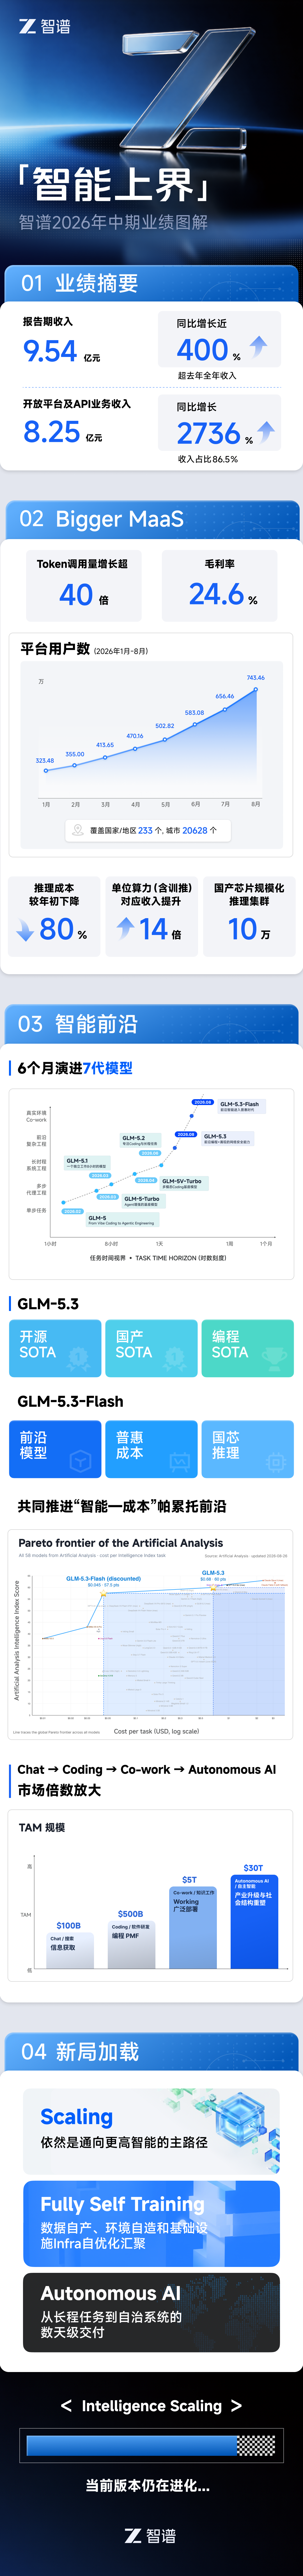
9月1日消息,8月31日傍晚,智谱在港交所披露2026年中期业绩,这是其今年1月上市后的首份中报。上半年收入 9.54 亿元,同比增长 399.7%,超过2025年全年;期内亏损 20.72 亿元,同比收窄 12.1%。
比增速更关键的是结构变化。开放平台及 API 业务收入 8.25 亿元,是去年同期的 27 倍以上,占总收入的比例从去年同期的 15.2% 升至 86.5%。一家过去七成收入来自政企本地部署项目的公司,在半年内把收入重心换到了按调用计费的云端业务上。
从卖项目到卖调用
本地部署业务上半年的收入是 1.62 亿元,同比下降 20.5%。据《科创板日报》报道,董事会秘书肖磊在业绩会上表示,相较收入增速,收入构成的切换更值得关注。
管理层把公司业务分成三个阶段:2025年之前以本地部署模型为主,客户买的是需要集成和定制的工具;2025年初进入编码阶段,API 与 CodingPlan 订阅产品快速增长;今年开始进入智能体与协同工作阶段,业务重心从模型调用转向任务交付。在此过程中,公司主动收缩了本地部署的软件授权业务。本地部署收入的下滑,是战略收缩与模型能力提升共同作用的结果:当模型能够独立完成更完整的任务,客户购买的东西更接近最终结果本身,收入的计量单位也随之改变。
量与价同时上涨
涨价通常会抑制用量,智谱上半年的数据反了过来。截至8月底,MaaS 平台 Token 调用量较年初增长 40 倍以上,其中 CodingPlan 的增长超过 23 倍;注册用户超过 740 万,较年初增长 144%,仅过去两个月就增加 160 万;付费日活用户增长 603%。同一时期,API 平均售价上涨约 101%。量价同时上升,把开放平台及 API 业务的毛利率从去年上半年的 -0.4% 推到了 24.6%。
按收入计,前十大客户的平均日使用量是年初的 98 倍。核心客户没有因为涨价离开,反而把更多真实任务交给了模型。管理层据此判断,客户付费的驱动力是模型能力,而不是价格弹性。这个判断目前只有智谱自己的平台数据支撑,但它指出了一个与行业直觉相反的可能:当模型能完成高价值任务时,价格未必是第一竞争变量。
11个月6代模型
调用量的增长由模型迭代驱动。GLM 系列在约 11 个月内完成六次迭代,按公司引用的 Artificial Analysis 智能指数,从 32 升至 60,单次任务成本维持在 0.20 美元左右。
8月14日发布的 GLM-5.3 沿用了 GLM-5.2 的基座模型,即一个 7450 亿参数、年初就完成训练的底座,全部能力提升来自后训练:任务环境规模扩大数十倍,官方口径下端到端任务完成率提升 50% 以上。在网络安全方向,GLM-5.3 在漏洞发现测试 CyberGym 的官方自测得分为 84.5;自 GLM-5.2 以来,公司与国内安全团队合作,在真实代码库中累计识别约 2436 个漏洞,其中超过 1000 个为高风险,涉及 269 个项目。
随后上线的 GLM-5.3 Flash 走了另一条路线。它采用专为降成本设计的新架构,总参数 3200 亿、激活参数 180 亿,定价只有 GLM-5.2 的十分之一,单次任务成本约 0.045 美元。发布前,它以匿名身份在 OpenRouter 和 OpenCode 接受真实调用测试,上线首日登顶 OpenRouter 调用量榜首,六天内处理超过 62 万亿 Token,带动平台整体用量增长超过 20%,身份揭晓当天以 MIT 协议开源。 成本线握在自己手里
Flash 的低价来自算力结构。智谱披露,已在约 10 万张国产加速卡上实现大规模、低成本推理,每 Token 推理成本较年初下降 80%;通过重构推理引擎与服务栈,相同国产硬件上的端到端服务性能较初始基线提升约 3 倍。GLM-5.3 Flash 是公司首个在超大规模真实流量下完全由国产芯片集群提供服务的模型,匿名发布期间的平台历史最高流量就跑在这套集群上。
推理引擎的优化本身也由模型参与完成:基于 GLM-5.3 的 Infra Agent 可以自主修改国产芯片的优化方案,把算子开发周期缩短一半。在算力供给持续紧张的背景下,成本曲线的控制权比单次 benchmark 排名更实际。
亏损没有消失,但亏损的性质在变
期内亏损 20.72 亿元,仍然不小,结构却在变化。上半年研发开支 21.31 亿元,同比增长 33.6%,高于 19.64 亿元的经调整净亏损。按管理层的说法,业务产生的毛利在初步覆盖行政和销售费用后,已开始支撑研发投入。上半年的亏损,主要亏在了训练下一代模型上。经调整亏损率较去年上半年收窄了 3.5 倍。
管理层的框架,和还没验证的部分
业绩会上,管理层给出了一套完整的叙事:AGI 的商业价值等于智能前沿乘以 Token 消耗规模;模型能力沿 Chat、Coding、Agent、Cowork 到自主 AI 的阶梯演进,每一级之间有明确的技术门槛,公司当前处于 Coding 与 Cowork 之间。管理层同时明确,在国内训练数据普遍处于 30 万亿至 50 万亿 Token 的约束下,单纯堆参数的边际回报正在递减,榨取每个基座模型的能力上限比追逐大参数更重要。
这套框架里已经被财报验证的是 Coding 一环。Cowork 所代表的网络安全、法律、金融、教育等场景中,目前只有网络安全进展最快,其余方向尚未产生规模化收入,公司在业绩会上承认了这一点。收入结构的切换用半年完成了,任务交付的商业模式能否在编码之外成立,要留给下一份中报回答。
自训练:下一代 GLM 要如何参与制造自己
这场业绩会上密度最高的技术表态是自训练(Fully Self-Training)。管理层把这个方向拆成三条线索,并称每条都已出现早期迹象。
第一条是数据的自我生成。模型对模型的自博弈流程意味着,数据质量的上限不再取决于人工标注的速度,而取决于模型验证自身结果的能力。管理层在问答环节补充了背景:2022年 ChatGPT 发布前后,智谱已建立数百人规模的数据标注团队,长期投入训练环境建设;GLM-5.3 相对 GLM-5.2 的提升,一个重要原因就是数据环境规模扩大了数十倍。其判断是,互联网新增文本数据正在减少、合成数据占比上升,这时比扩大参数更重要的是建设可验证的数据环境和真实任务环境。
第二条是环境的自动制造。按管理层的描述,研究智能体负责收集任务模式,判断智能体负责尝试每项任务,验证器和环境被自动合成,逐渐变成流程中的标准化产品。第三条是基础设施的自我优化,理由是推理系统优化本身就是一项代码工程任务,而代码正是模型能力最强的领域。前文提到的 Infra Agent 自主修改国产芯片优化方案,就是这条线上已经落地的部分。
三条线指向同一个终态:模型参与自身的改进,形成递归式自我提升,即海外讨论的 RSI。董事长刘德兵给出的落点是,下一代 GLM 将在由上一代 GLM 构建的环境中进行自训练。管理层对难点的表述同样直接:关键不是把模型做大、继续训练,而是让模型能自我评估、知道何时停止、出错时自主纠正。这些能力目前尚不具备,自训练仍是愿景与局部实践的组合,不是已交付的能力。
承载这一愿景的下一代基座模型已在训练中,方向包括更大的有效规模、更长的原生上下文和统一的多模态建模,推理研发同步提前启动。管理层提出的工程目标是,新模型发布第一天就支撑全量用户需求,开源后企业可以直接部署使用。这一目标与自训练一样,要等模型实际发布才能检验。
 AI 速览