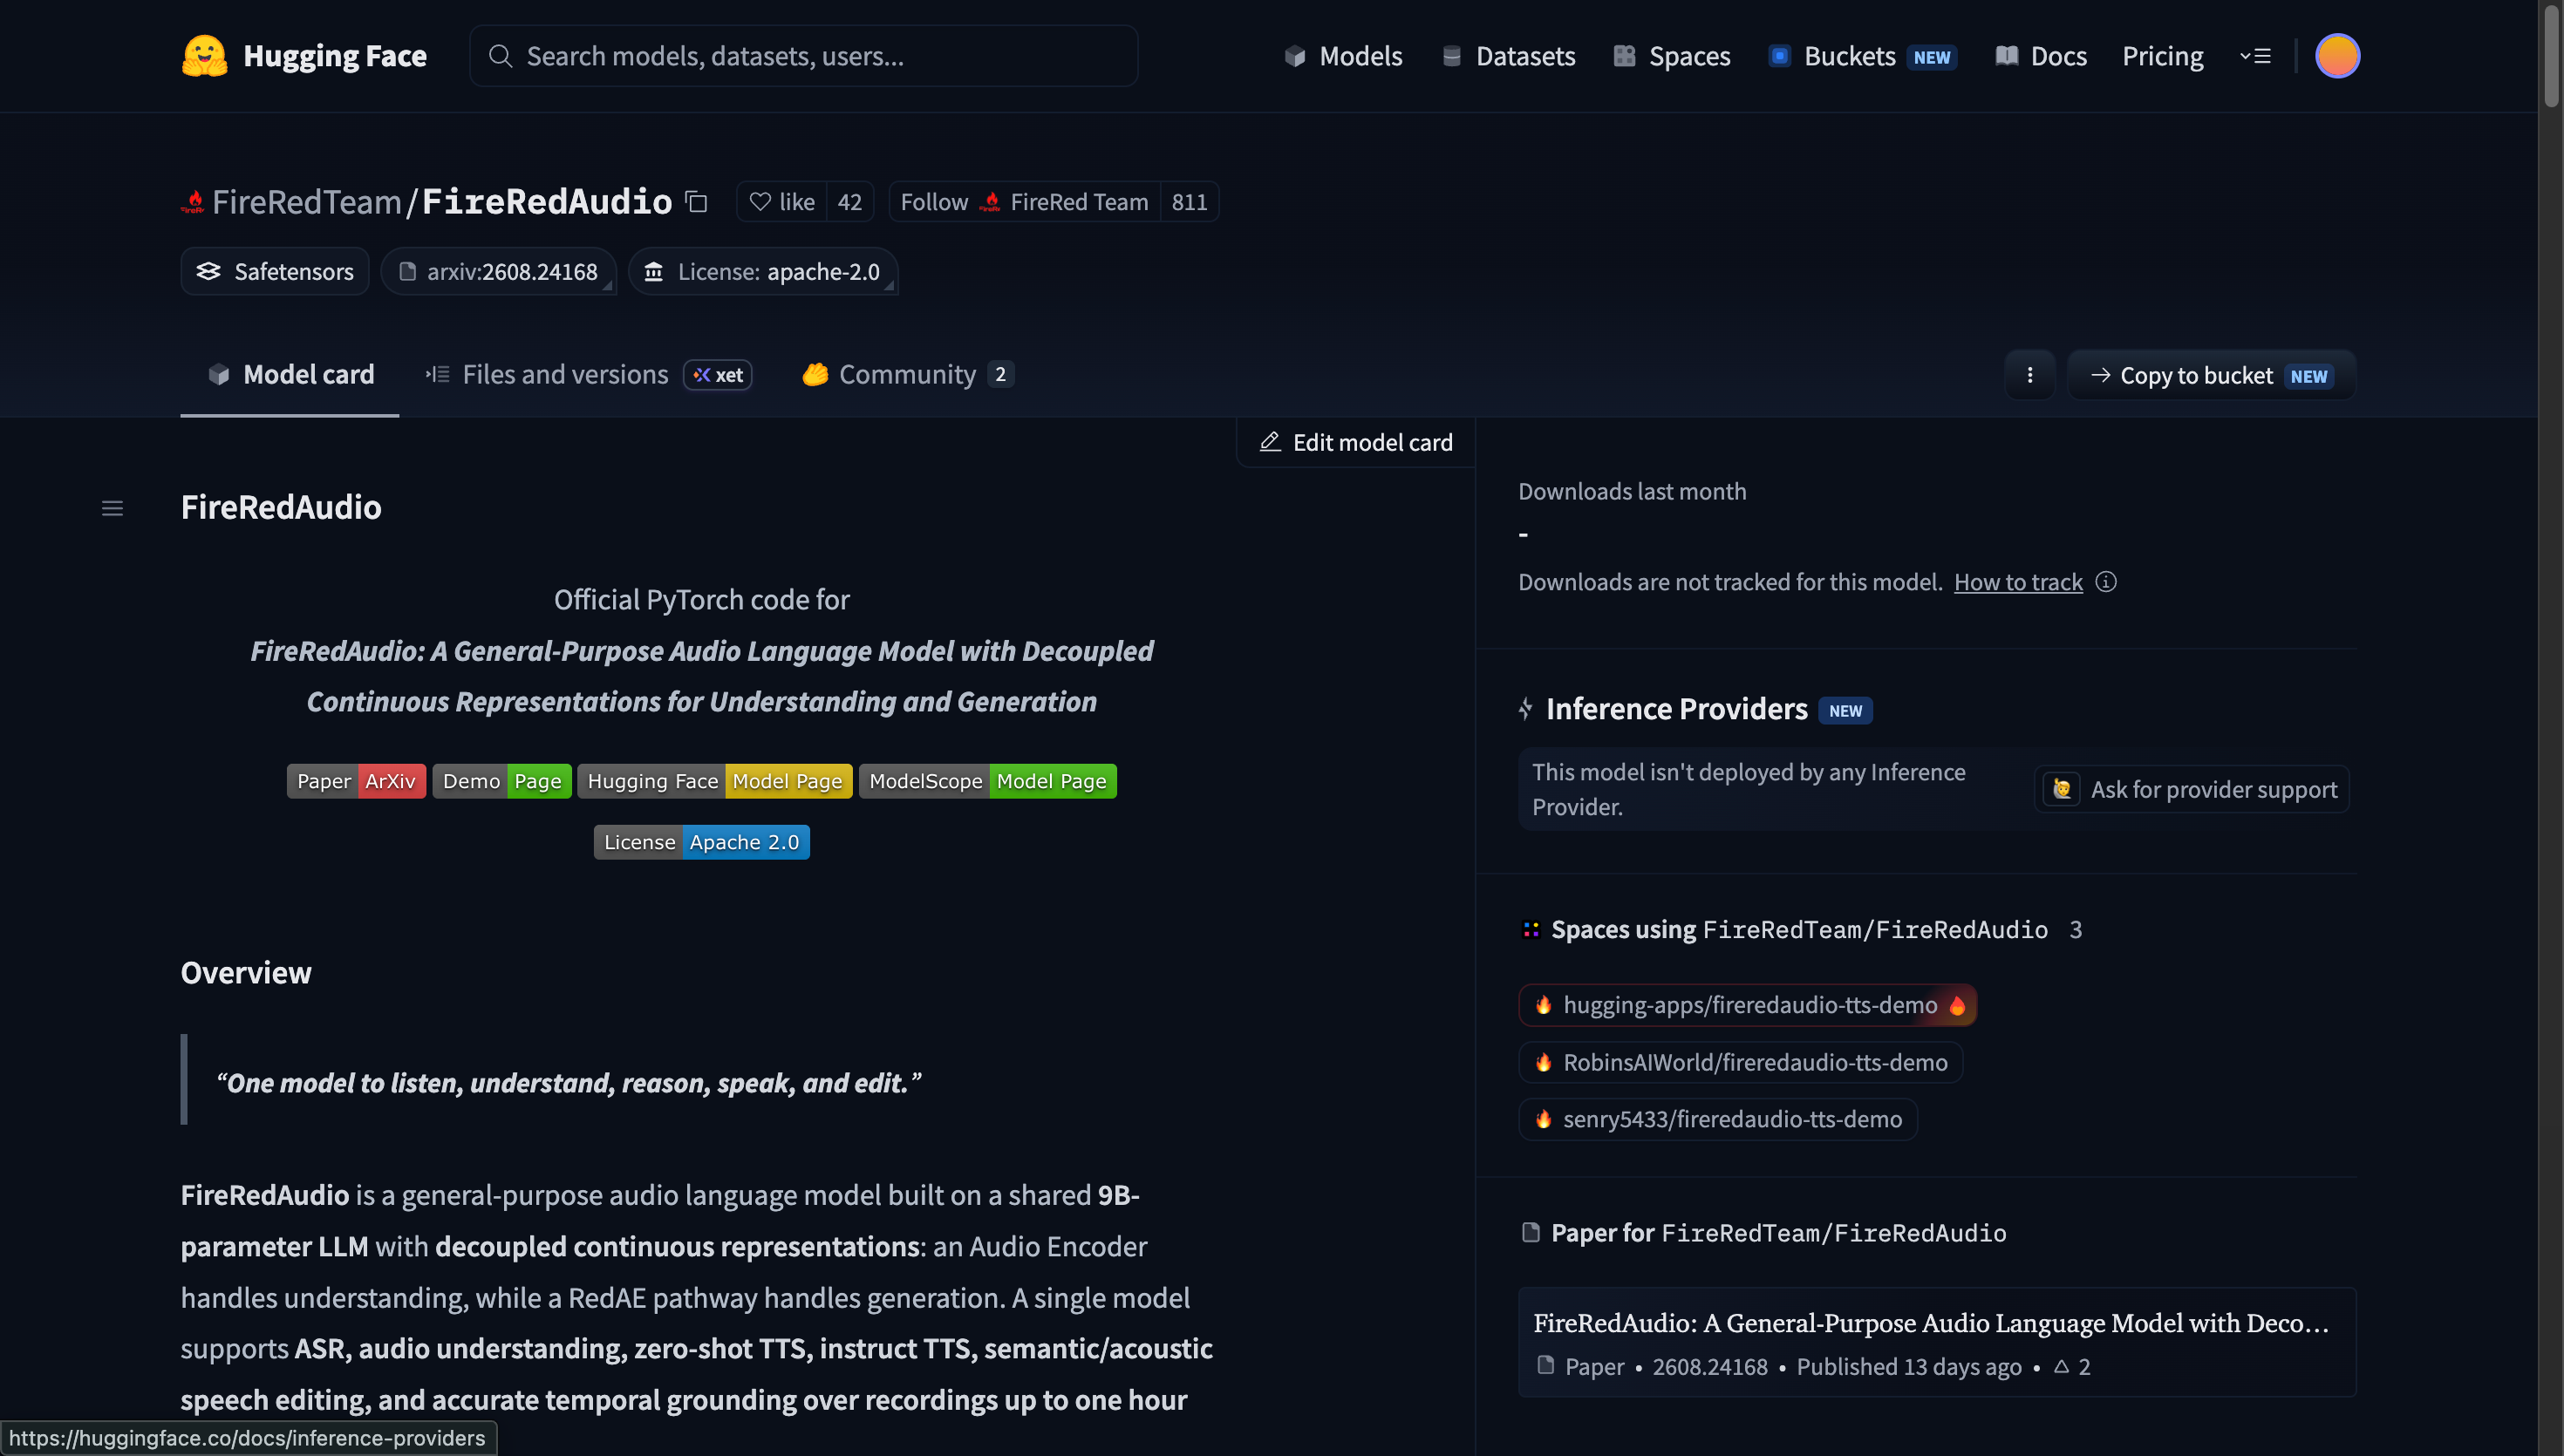
- FireRedAudio 是小红书 FireRed 团队于 2026 年 8 月 21 日开源的通用音频语言模型,代码与权重发布在 GitHub 与 Hugging Face,Apache-2.0 协议。
- 模型基于 9B 参数的 Qwen3.5 语言模型,用一套主干覆盖 ASR、音频理解、零样本 TTS、指令 TTS、语义与声学语音编辑五类任务。
- 官方 Benchmark 中,FireRedAudio 在 MMAU test-mini 得 82.0、MMSU 得 83.3,高于表内 Gemini 3.1 Pro 与 Qwen3.5-Omni-Plus 的自评成绩。
- 零样本 TTS 在 Seed-TTS-Eval 中文 CER 0.83,低于官方对比表中的其他模型;音色相似度 SIM 平均 0.71,低于 Seed-TTS 的 0.78。
- 除 ASR 外,生成与理解任务限中文和英文;长音频理解支持一小时以内录音,可输出秒级时间戳。
- 上手需要 Python 3.10、uv、CUDA 显卡与 ffmpeg,模型经 Hugging Face 或 ModelScope 下载。
FireRedAudio 是什么
FireRedAudio 的输入是音频加文本指令,输出是转写文本、理解结论或合成语音。它把「听、理解、推理、说、编辑」放进同一个模型:给它一段录音,它能转写内容、回答关于录音的问题、产出带时间戳的结构化摘要;换成一段参考音频加文字,它克隆音色朗读新文本;用自然语言下指令,它改动一段话的内容、音高、语速或音量。
项目来自小红书 FireRed 团队(GitHub 组织 FireRedTeam),该团队此前发布过 FireRedASR、FireRedTTS 等音频项目。2026 年 8 月 21 日,团队在 GitHub 与 Hugging Face 放出 FireRedAudio 的代码与模型权重;技术报告于 8 月 25 日挂上 arXiv(编号 2608.24168,8 月 27 日更新 v2)。模型以 9B 参数的 Qwen3.5 为语言主干,采用 Apache-2.0 许可证,允许商用。
核心技术:理解与生成用两套连续表征
统一音频模型有个老矛盾:理解任务偏好紧凑的语义特征,方便长上下文建模;生成任务需要能还原声音细节的声学特征。强迫两类任务共用同一种音频表示,一边丢语义,一边丢细节。
FireRedAudio 的解法是把表示拆开、把主干留下。理解侧的录音走 Audio Encoder(以 Whisper-large-v3 初始化),产出紧凑语义特征;生成侧的参考语音走 RedAE-Patch 通路,保留可重建的声学细节。两路表征进入同一个 9B LLM:理解任务输出文本 token,生成任务由 LLM 驱动 flow-matching DiT 产出连续声学 latent,解码为 24kHz 波形。可以把它想象成一名同声传译配了两副耳机:一副听内容、做笔记,一副听音色、做模仿,思考和输出用的是同一个大脑。
团队在论文中称,这是首个公开披露的、在统一音频语言模型内为理解与生成配备独立连续输入表征的设计。注意这一「首个」属于团队自述,尚无第三方考证。
Benchmark:理解、ASR、TTS、编辑四张成绩单
以下数字来自官方 GitHub 仓库与论文(2026 年 8 月),其中带 * 的对比项为 FireRed 团队自行评测,口径与第三方复测可能存在差异。
音频理解:MMAU test-mini 82.0、MMAU test 80.9、MMSU 83.3。同一表格中,Gemini 3.1 Pro 为 80.7*、78.8*、82.7*,Qwen3.5-Omni-Plus 为 81.4*、79.9*、80.7*,Step-Audio 2 在 test-mini 上为 78.0。
ASR:多语种 FLEURS-102 平均错误率 14.94,低于表内其他模型;LibriSpeech clean 0.67,FLEURS 中文 3.14。中文 AISHELL-1 为 0.71,高于 Kimi-Audio 的 0.60 和 Step-Audio 2 的 0.63,单项不占优。 零样本 TTS(Seed-TTS-Eval):中文 CER 0.83、英文 WER 1.56,平均 CER/WER 1.20,低于表内其他模型;音色相似度 SIM 平均 0.71,低于 Seed-TTS(0.78)、DiTAR(0.75)和 CosyVoice 3-1.5B(0.75)。内容准确率领先、音色还原居中,这是表格呈现的真实取舍。
指令 TTS(InstructTTSEval):APS、DSD、RP 三项指标在中英文两组上排第一,该表全部数字为团队自评。语音编辑(Ming-Freeform-Audio-Edit):与 Ming-UniAudio-Edit 对比,语义编辑与声学编辑的多数指标占优,例如开放设置的语义替换任务,中文 WER 2.45 对 4.56,英文 4.41 对 7.64;变速任务中文 WER 2.00 对 5.88。
能力边界与已知限制
官方 Limitations 写得清楚:
- 语言范围:生成类任务(TTS、编辑、声音设计)与音频理解限中文、英文,ASR 支持多语种。
- 可复现性:零样本 TTS 的 flow-matching 解码器每次采样随机噪声,同一输入两次运行的输出有差别;复现实验需固定 --seed,不同 seed 之间质量有波动。
- 长音频上限:一小时以内录音经过验证,超出后时间对齐质量可能退化。
- 使用约束:团队声明零样本声音克隆功能供学术研究用途,禁止用于违法用途。
硬件门槛有讲究:推理需要 CUDA 显卡,安装时要编译 causal-conv1d 与 flash-attn 内核,官方 wheel 默认匹配 CUDA 12.8,CPU-only 环境不在支持范围内。社区侧,发布两周内出现了第三方 ComfyUI 插件(RH-RunningHub/ComfyUI_RH_FireRedAudio)和 B 站体验视频,但成体系的第三方复现评测目前缺位,上表成绩应按官方口径看待。
快速上手
前置条件:Python 3.10、uv、CUDA 工具链(GPU 推理与内核编译)、ffmpeg。wheel 默认 CUDA 12.8(cu128),其他版本需修改 pyproject.toml 中的 pytorch-cu128 索引地址后重装。
安装与下载:
跑一条 ASR:
零样本 TTS 需加载 RedAE 解码器权重:
声学编辑的指令限定为训练时的固定模板,例如 "shift the pitch by 3 steps"(音高 ±6 档)、"adjust the speed to 1.5"(0.5—2.0 区间)、"adjust the volume to 0.8"(0.3—2.0 区间),自由表述的指令不在训练分布内。Python API 与更多示例见官方 README。
生态定位与行动清单
音频模型赛道里,Qwen3-Omni、Step-Audio 2、Kimi-Audio、MiMo-Audio 各有侧重。FireRedAudio 的差异点是 9B 中等规模加 Apache-2.0 加理解与生成同体:需要私有化部署、且要覆盖「转写—理解—合成—编辑」全链路的团队,一套权重就够,免去串联多个专用模型的麻烦。对小红书,它是内容生产基础设施;对开发者,它给出一个可商用、可改动的全栈音频底座选项。
行动清单:
- 有 GPU 环境:按上文命令跑通 ASR 与 TTS 示例,确认显存占用匹配你的卡。
- 做中文语音产品:用自有语料测一遍音色相似度,官方 SIM 数字不是它的强项。
- 做长音频场景(会议纪要、播客整理):用一小时以内的真实录音测时间戳精度,这是官方主打能力。
- 需要可复现结果:固定 --seed 并记录版本,flow-matching 采样会带来输出波动。
- 观望生产采用:等第三方独立复测的 Benchmark 数据公布,拿到复测数字后做决策,当前数字以官方口径为准。
 AI 速览