GPT-6 Astra已经替大家测试过了,推理能力强悍,但烧Token的速度也让人肉疼。与其肉疼,不如换套思路:调档位、开实验功能、重写AGENTS.md和Skills,体感上能省下一半成本,还能让模型跑得更顺。以下是我实测有效的配置心得。
选对档位,钱就省了一半
Tibo大佬说过一句话:GPT-6 Astra开low档,效果已经盖过GPT-5.6 Sol开high档。
我平时拿Astra干不同活,档位选择有个习惯:
你看max和high那一档,其实只要牺牲1%到3%的准确率,成本直接砍半。效果上,6 Astra-low稳赢5.6 Sol-high。我现在大部分活儿都在medium和high之间切。省钱,效果还不打折。
扔掉无脑塞上下文的旧习惯
Astra厉害就厉害在能精准抓重点、做细致思考。但老办法是用ChatGPT那一套,恨不得把所有相关资料全塞给它,超了就压缩。
这在Astra上纯属给自己挖坑。冗余信息一多,一来憋屈了它的最大潜力,二来Token哗哗往外漏。
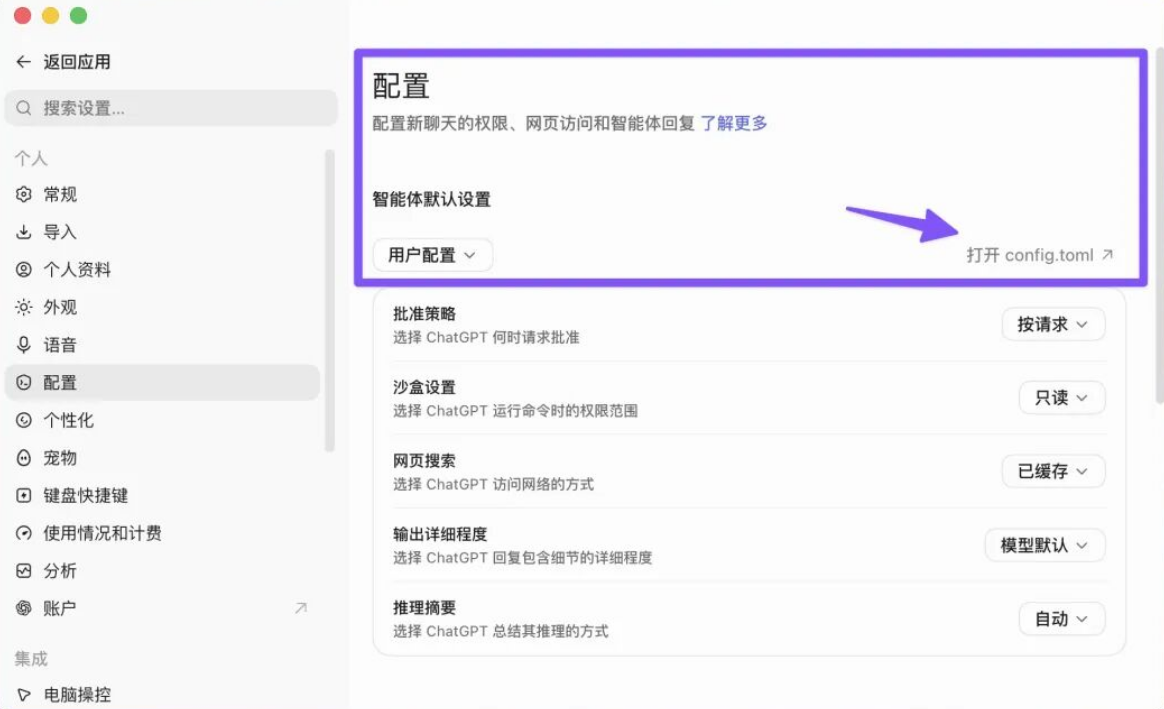
解决办法是开Codex里的实验功能。打开 ~/.codex/config.toml 文件,在下面加上:
存盘就行。这功能一开,Token消耗大概能再降三分之一。
原理也简单:它用笔记加窗口的方式管上下文,能跨窗口保留笔记,搜同一任务里更早的消息和工具结果。比起传统的压缩总结,细节丢得少,省Token,表现还更好。虽然官方说这功能还在实验阶段,几周后会正式更新,但早用早享受。
AGENTS.md得顺着它的脾气改
用Astra这几天,发现它挺有个性:爱提问,爱列长清单,有时候停在一堆计划上就是不干活。对Skills和AGENTS.md的指令也变得极其敏感。
敏感到什么程度?一旦思考过程跟AGENTS.md里的要求撞车,它要么不理你只听话,要么直接罢工,卡在计划阶段不动弹。
顺着它的脾气,AGENTS.md得这么写:
把它贴到设置里的个性化板块。改完之后,Token又能省下一截。
为旧模型写的Skills现在全成累赘
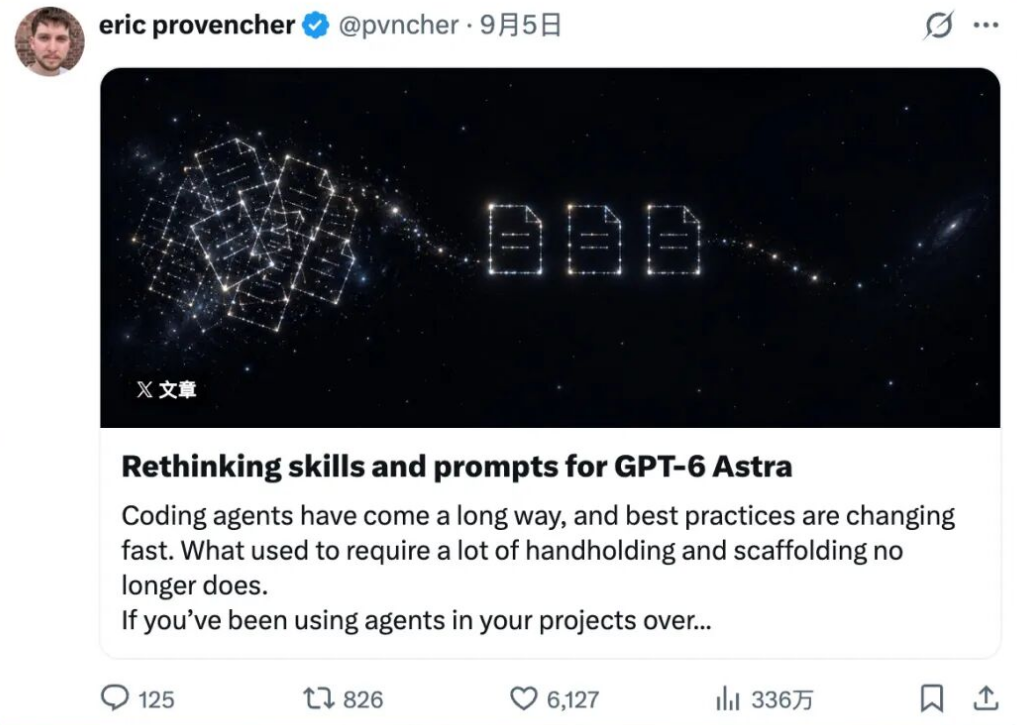
9月5号,OpenAI Codex团队的Eric Provencher写了一篇文章,专门聊Astra下Skills该怎么改。官方模型指南页也是一样的意思。
核心就一句话:过去一年为了管住弱模型写的那些条条框框,Astra读了反而碍事。以前无伤大雅,现在直接锁死了Astra的顶级能力。
有两个点很要命。
一是没有“渐进披露”。读一份Skill就占上下文,把你推向压缩边缘。处理多工作流的Skill,根文档应该是个极简路由器,指明去哪找脚本和文档,别逼它读无关内容。
比如别写“编辑前必须读完architecture.md、database.md、deployment.md”。要写“处理服务边界看architecture.md,改DB结构看database.md,准备部署看deployment.md”。按需加载。
二是写成了死板的菜谱。Astra自己懂细微差别,指令太具体反而束缚手脚,结果缺斤少两。
你可以在Codex里直接发送下面这段指令,让模型自己帮你审查和优化现有的Skills:
请逐一审查本项目内的所有技能文件(包括 SKILL.md 及相关指令文件)和 AGENTS.md 文件,参照 OpenAI Codex DX 团队在评审 GPT-6 Astra 最佳实践时总结的以下六类问题,检查其中的指令是否仍然必要、准确且有效。
本轮只做审查并提交报告,不修改任何文件。
一、技能描述过长或过于宽泛 标记冗长、含糊,或适用范围过大的技能描述。 加载大量技能时,过长的描述可能被截断;描述不够明确,则可能导致模型在不适合的任务中误用该技能。检查描述是否简洁、准确,能否清楚说明技能的用途和触发条件。
二、缺少按需加载的分层结构 标记将多个工作流程全部堆进同一份长篇技能文件的情况。 合理的组织方式应当是:主文件提供简短的说明和导航,将不同工作流程的详细内容拆分到独立的配套文档中,仅在任务需要时加载。
三、操作步骤过于僵化 标记将技能写成繁琐、过度具体的固定操作脚本的情况,例如要求模型无论面对什么任务,都必须依次执行一长串预设步骤。 检查这些步骤是否确有必要,还是仅仅限制了模型根据实际情况选择处理方式的能力。对于可以交由模型判断的执行细节,不应强制规定唯一的操作路径。
四、每次修改前都强制读取完整上下文 标记 AGENTS.md 中要求模型在每次修改前,都必须通读整个代码仓库或大量文档的指令,尤其是连微小改动也必须如此的要求。 判断所要求的阅读范围是否与当前任务有关、是否与改动规模相称,以及是否存在不必要的重复阅读。
五、已经过时的测试或验证要求 标记那些仅为弥补旧模型能力不足而设置、如今模型已经能够主动完成的测试提醒或重复核查要求。 区分真正必要的项目验证规则与已经失去作用的额外督促。不要仅因一条指令涉及测试或验证,就将其判定为冗余。
六、过度谨慎的请示与审批措辞 标记过于宽泛或强硬的“执行某项操作前必须先询问用户”之类的要求。 重点检查这些要求是否导致模型过早停下,或对本可安全继续、且已在授权范围内的操作反复请求批准。
审查报告要求 对于每一项需要调整的指令,请使用以下格式: 【需调整】 所属类别:六类问题中的哪一类 原文与位置:引用相关指令,并注明所在文件;可定位时附上行号。 原有目的:这条指令原本试图解决旧模型的什么问题。 标记理由:为什么它如今已经过时、造成冗余,或妨碍有效执行。 处理建议:删除、精简、拆分为导航主文件与按需加载的配套文档,或改写。说明建议方向,本轮不要实际修改。
对于应当保留的指令,请使用以下格式: 【应保留】 原文与位置:引用相关指令,并注明所在文件。 保留理由:说明它描述了什么真实、持续有效的项目事实、约束或要求。
判定原则 不要仅仅因为一条指令写得具体,就将其标记为问题。如果它描述的是本项目真实且长期有效的事实、安全边界或团队规范,就应当保留。 只标记那些纯粹为了弥补旧模型局限而存在、如今已无必要的指令。不要将项目本身的要求误判为模型能力不足的补丁;没有充分依据时,也不要臆断某条指令已经过时。
最后用一行给出粗略占比:以本次审查的指令条目为基数,分别列出六类问题各自所占的比例,以及应当保留的比例。若同一条指令涉及多个问题,按主要问题归类,避免重复计算。
应当保留的比例。若同一条指令涉及多个问题,按主要问题归类,避免重复计算。
发完之后,跟着它给的报告一步步优化。弄完你再试试,Skills跑得比以前快多了,效果也干净利落。
折腾完这些配置,再跑几个任务,你会真切感受到Astra那种颠覆性的强。连我们习惯了的那套系统提示词范式都得跟着变,变得更轻巧。希望这些实操经验能帮你省点Token,把好钢用在刀刃上。
推荐阅读:
 AI 速览