人们常常把性能和成本看成一种权衡:想少花钱,就得接受更差的结果。但实践中 Anthropic 发现,许多使用 Claude Platform 的应用,只需做三件事,就能在不损失性能的前提下降低成本:最大化提示词缓存命中率、在升级到前沿 Claude 模型时清除提示中的反模式,以及根据任务校准 effort。这些指南已写入 claude-api skill。配合 claude-api skill 的 Claude Code,常常能找到既降成本、又保持甚至提升性能的方法。 提示词缓存(Prompt cache)
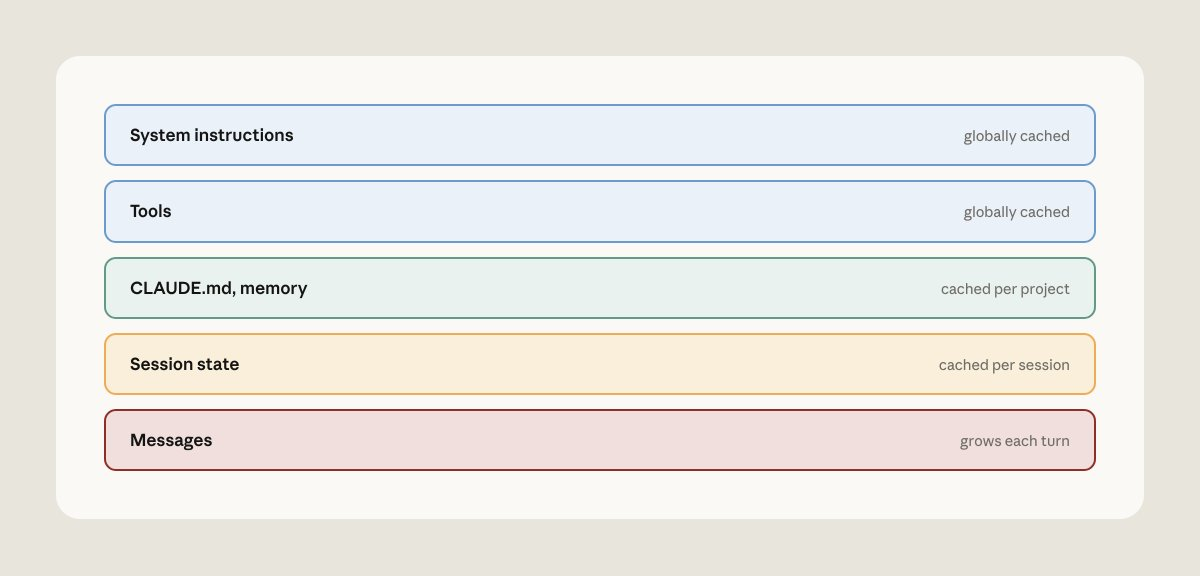
Claude 在生成回复之前,会先把提示处理成内部工作状态。这一步叫 prefill,是处理输入中最贵的部分。提示词缓存会保存这个状态(即 key–value / KV 缓存):当新请求以相同前缀开头时,Claude 直接读回缓存,而不是重新计算。缓存读取的计费远低于完整输入价格——以 Fable 5.1 为例,缓存读取为每百万 token 0.25 美元,普通输入为 10 美元。 要有效使用提示词缓存,有几点实际注意事项:
基于这些,有几条实用建议:
- 不要在对话中途随意改 effort 设置。 这些设置会渲染进提示、位于内容之前,因此属于被缓存的前缀。只有部分 Claude 模型(包括 Opus 5 和 Fable 5.1)允许在对话中途更新 effort 而不破坏缓存。
- 不要把易变值放进前缀。 系统提示里的动态时间戳或 ID 会在多次调用间变化,从而破坏缓存。
- 避免会自行重排的工具定义。 使用 Claude messages API 时,提示按固定顺序组装,工具定义渲染在最前面。工具定义任何改动都会破坏缓存。
- 分叉对话时要小心。 子代理和分支只有在前缀字节完全相同、同一模型、同一 effort 时,才能共享父对话的缓存。
如何修复
Anthropic 总结的提示词缓存管理经验:
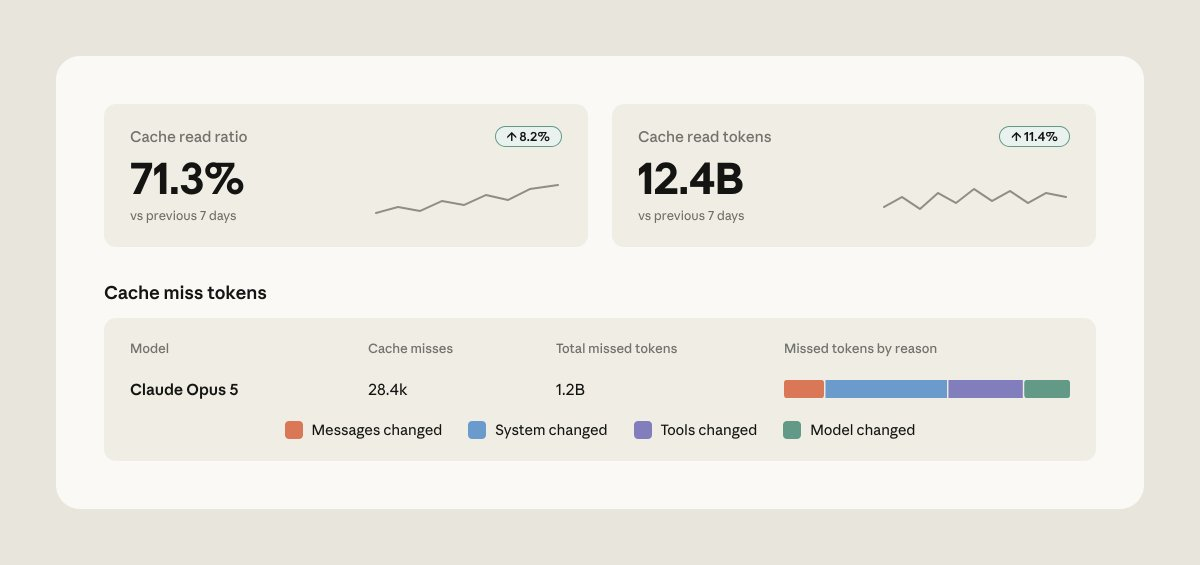
- 仔细监控提示词缓存命中率。 Claude Console 和缓存诊断 API 会提供诊断信息,包括缓存未命中的原因,以及两次请求具体在哪里分叉。
- 推迟很少使用的工具。 可以先声明全部工具,但把很少用的标为 defer_loading:它们不会进入被缓存的前缀,只有当 Claude 通过 tool search 查找时才追加进对话,从而保护缓存。
- 把系统提示更新做成消息。 部分 Claude 模型允许在对话中途以消息形式追加系统指令,而不是直接改系统提示,这样可以保住缓存。
- 把请求布局成:稳定部分始终稳定。 先放静态上下文(工具定义和系统提示),再放不断增长的对话。
- 在缓存本来就会被打破时再改模型或 effort。 某些操作(如 compaction)本来就会大量改写缓存的对话部分,这时切换模型或 effort 比较合适,因为反正已经要为一次未命中付费。
- 随着对话增长移动缓存断点。 在 Claude Platform 上,可以设置自动缓存,把缓存断点应用到最后一个可缓存块。
- 预热缓存。 为降低延迟,可发送 max_tokens: 0 且带显式缓存断点的请求,effort 与真实流量相同。这会处理提示并写入缓存,但不生成任何内容。若在会话开始时(例如用户正在打字时)运行,第一次真实请求就能打中已预热的缓存。
- 不要超过提示词缓存 TTL。 5 分钟 TTL 从请求开始计时。如果智能体因工具调用或子代理请求阻塞超过 5 分钟,父缓存会在结果返回前过期。这种情况下,可考虑给前缀设置 1 小时 TTL。
指令(Instructions)
提示会不断堆积用来修补模型弱点的指令,这些指令可能和最新 Claude 模型的能力脱节。以下是常见的提示「反模式」,会拖累前沿 Claude 模型,并可能无意中增加成本:
- 验证仪式。 诸如「再检查一遍工作」或「回复前验证两次」的指令,前沿模型往往会字面执行,浪费 token。
- 彻底性和强调助推器。 「尽可能彻底」「CRITICAL: YOU MUST ALWAYS…」在前沿模型上可能导致啰嗦和多余工具调用。
- 强制流程和草稿脚手架。 固定步骤流程(例如「在草稿本里一步步思考」)或推理模板,是前沿模型不再需要的仪式。这类脚手架会叠在原生推理之上,消耗不必要的 token。
- 过时示例。 针对旧模型失败模式调好的 few-shot 示例,可能教会前沿模型在不需要的请求上也模仿很长的推理链。
- 互相矛盾的规则。 前沿模型更擅长遵循指令。互相矛盾的指令(「始终按政策退款」vs「未经升级绝不退款」)会被更字面地执行,导致性能下降。
- 过时配置。 为更早一代 Claude 写的设置(例如手动思考预算)可能被较新模型的 Claude Platform 拒绝。
如何修复
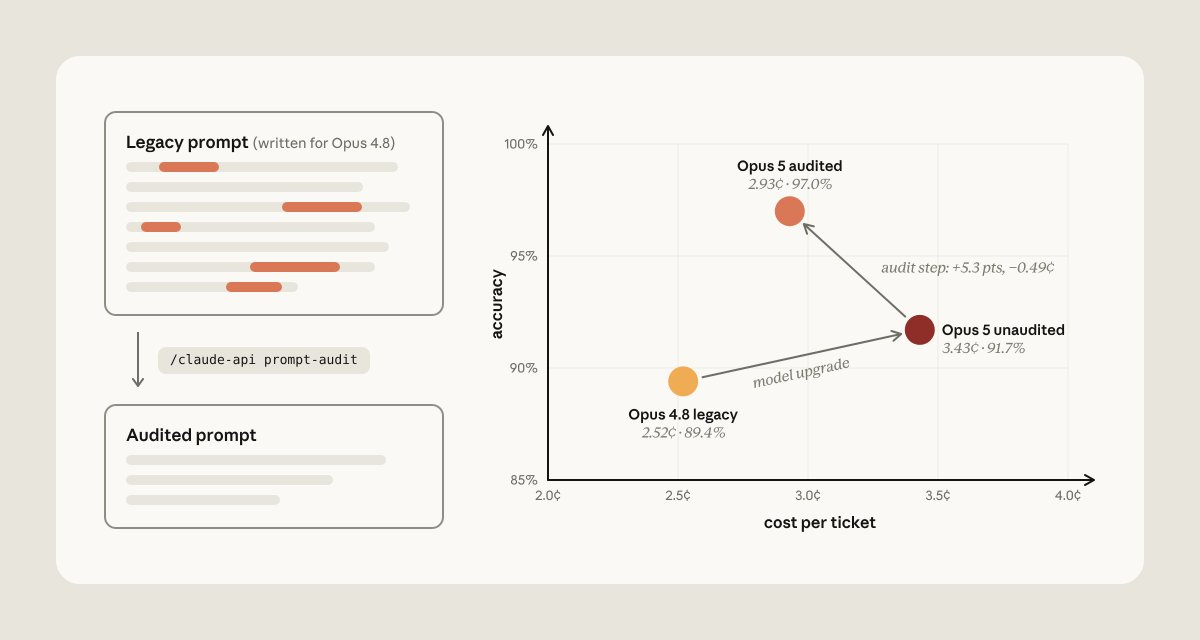
Anthropic 已更新 claude-api skill,新增一条命令来发现这些反模式。在 Claude Code 中,对提示、skills 或工具描述运行 /claude-api prompt-audit。审计范围包括工作目录中的一切:调用 Claude API 的应用代码,以及 Claude Code 自身配置(例如 CLAUDE.md 或 skills)。 Anthropic 在一个客服基准上测试了从 Opus 4.8 迁移到 Opus 5。从一个干净提示开始,每次只植入一种反模式(已淘汰的 thinking 设置、一对矛盾退款规则、手动草稿本、「验证两次」、「尽可能彻底」、强制六步流程),得到六个遗留提示,并分别在 Opus 4.8、仅改模型 ID 的 Opus 5,以及运行一次 /claude-api prompt-audit 后的 Opus 5 上跑这些提示。
在 Opus 5 上,验证仪式(「验证两次」)会在每次退款时重复订单查询,浪费 token;强调助推器(「尽可能彻底」)变成了几十次不必要的知识库搜索。运行 prompt-audit 清除这些反模式后,平均成本下降 14.6%,准确率上升 5.3 个百分点。
成本下降是因为去掉了多余工具调用和重复推理。准确率上升有三个原因:已淘汰的 thinking 设置会让 API 直接拒绝所有路由请求;矛盾的退款规则让 Opus 5 在本该退款的四个案例中扣住退款、要求客户确认;手动草稿本与 Opus 5 内置思考冲突——有三张工单把工具调用写进了推理里,却从未真正执行。
努力程度(Effort)
Effort 告诉 Claude「要多努力工作」。低 effort 时,Claude 通常更快得出结论;高 effort 时,Claude 会先深思、验证、探索替代方案再回答。
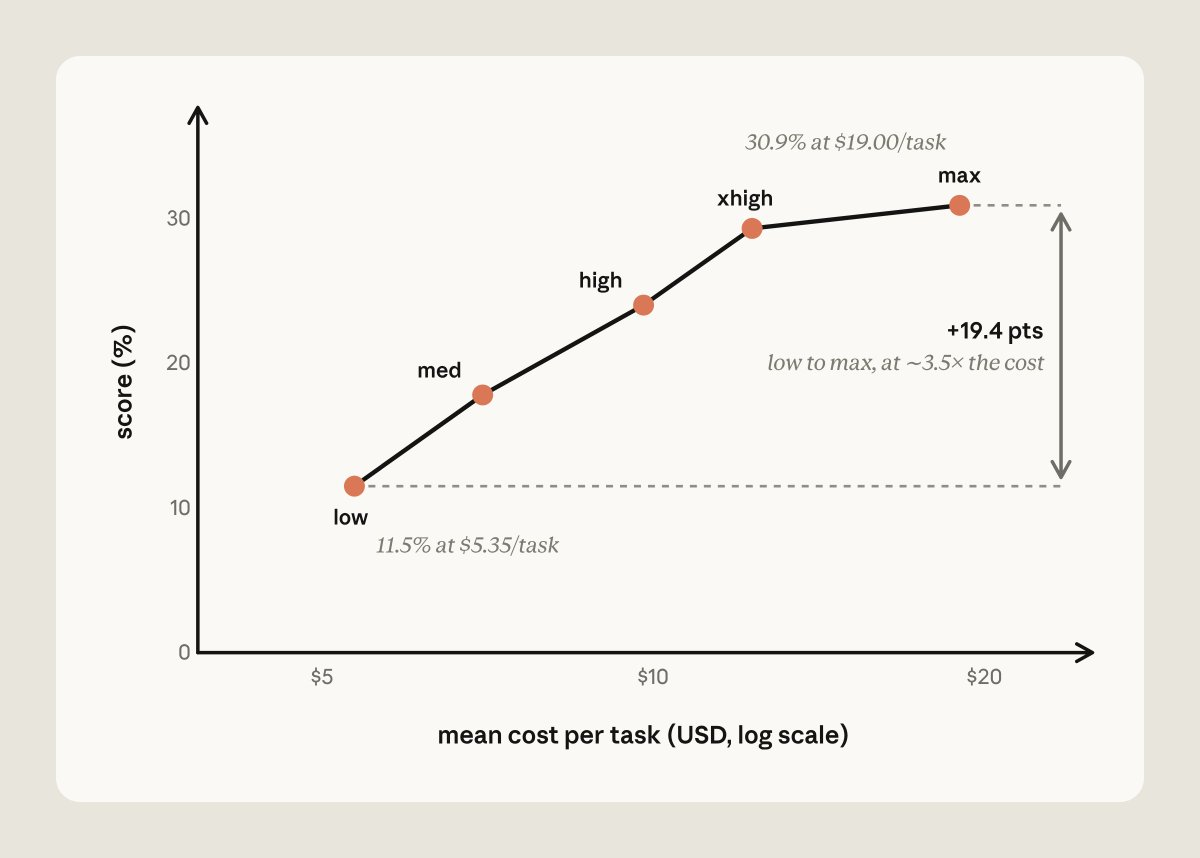
同一模型在不同 effort 下的成本-性能会有差异。例如,Claude Fable 5 在 FrontierCode Diamond(最难的 50 个任务)上,低 effort 得分 11.5%、每任务 5.35 美元;max effort 得分 30.9%、每任务 19.00 美元。提高 effort 大约把分数提高 2.7 倍(+19 个百分点),成本约提高 3.5 倍。
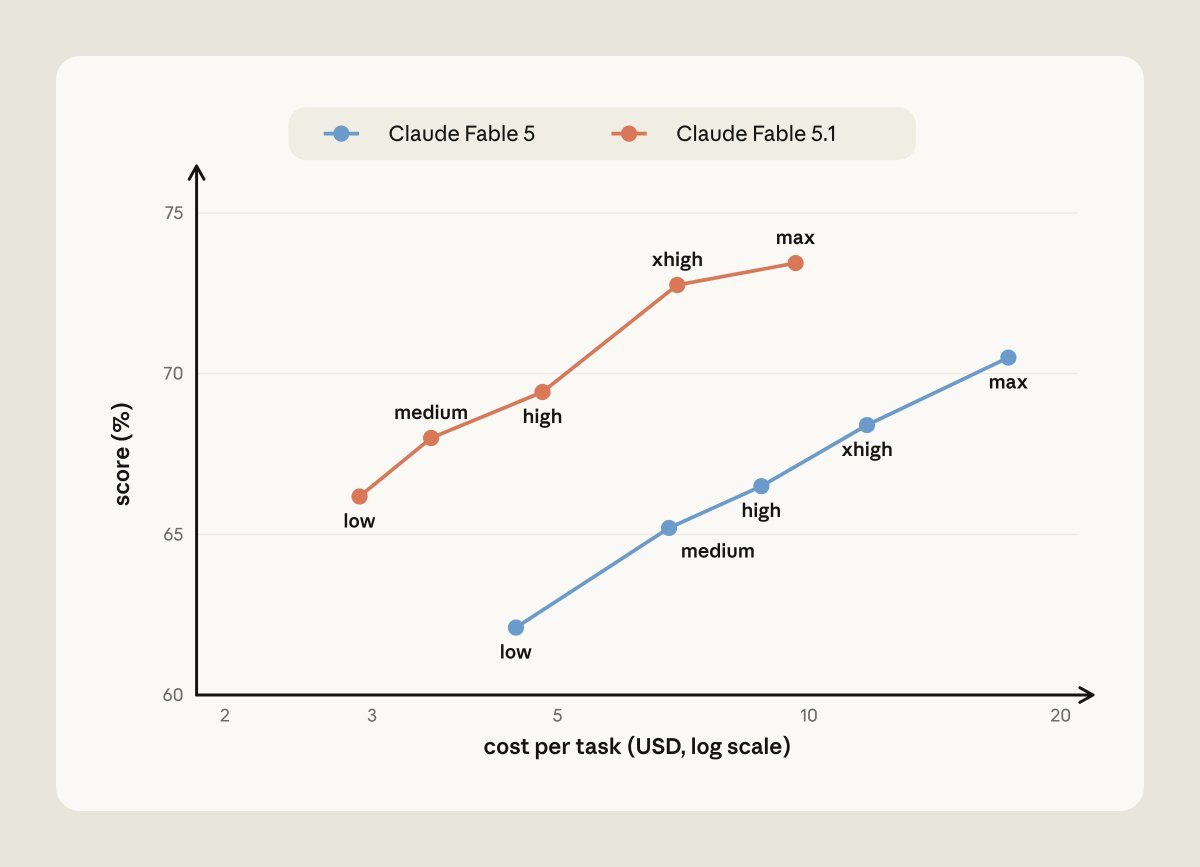
在 Claude Fable 5.1 上,Humanity's Last Exam(无工具)呈现陡峭曲线,但最后一步收益递减:低 effort 约 53 分、每题约 0.30 美元;max effort 约 61 分、每题约 2.23 美元。从 xhigh 升到 max 大约只多半分,成本却多 46%。这个增益落在基准的多次运行噪声范围内,等于多花钱却没有可测收益。
Effort 可能往两个方向校准失误:
- 默认以为越高越好。 高 effort 可能导致过度思考。Claude 花的时间超过任务所需,既增加成本和延迟,还可能降低答案质量。只有还有证据可找时,深思才有帮助。
- 偏向过低 effort。 设太低时,Claude 会在证据不足时就停:工具调用更少,可能只根据第一次搜索结果回答,而不是第三次;在困难步骤上想得更少,并跳过它本来会自己做的检查。答案看起来完成了,但建立在不完整信息上。
如何修复
校准 effort 的实用方法:
- 用更强模型配更低 effort 做测试。 更强模型在低 effort 下,可能比更弱模型拼命工作(高 effort)更便宜。例如在 CursorBench 3.2 上,Claude Fable 5.1 低 effort 的表现可匹配 Fable 5 高 effort,成本却只有约三分之一。新模型更便宜有两点原因:低 effort 下每个任务做的工作更少;Fable 5.1 的提示缓存读取定价为每百万 token 0.25 美元,而 Fable 5 是 1.00 美元。即便按 Fable 5 的价格算,Fable 5.1 低 effort 也大约便宜 40%。
- 理解你的任务形态。 在一系列 effort 水平上测量应用性能,有助于看清该任务的成本-性能权衡。在未饱和的评测上,如果成本-性能曲线在不同 effort 间几乎平坦,说明任务并不受思考算力约束,提高 effort 没有好处。
这种校准通常需要在多个模型和 effort 水平上跑评测。在 Claude Code 中,/claude-api hillclimb 会替你做这次搜索:把评测分成训练集和测试集,提出配置改动,并阅读失败的训练样本来修复问题。
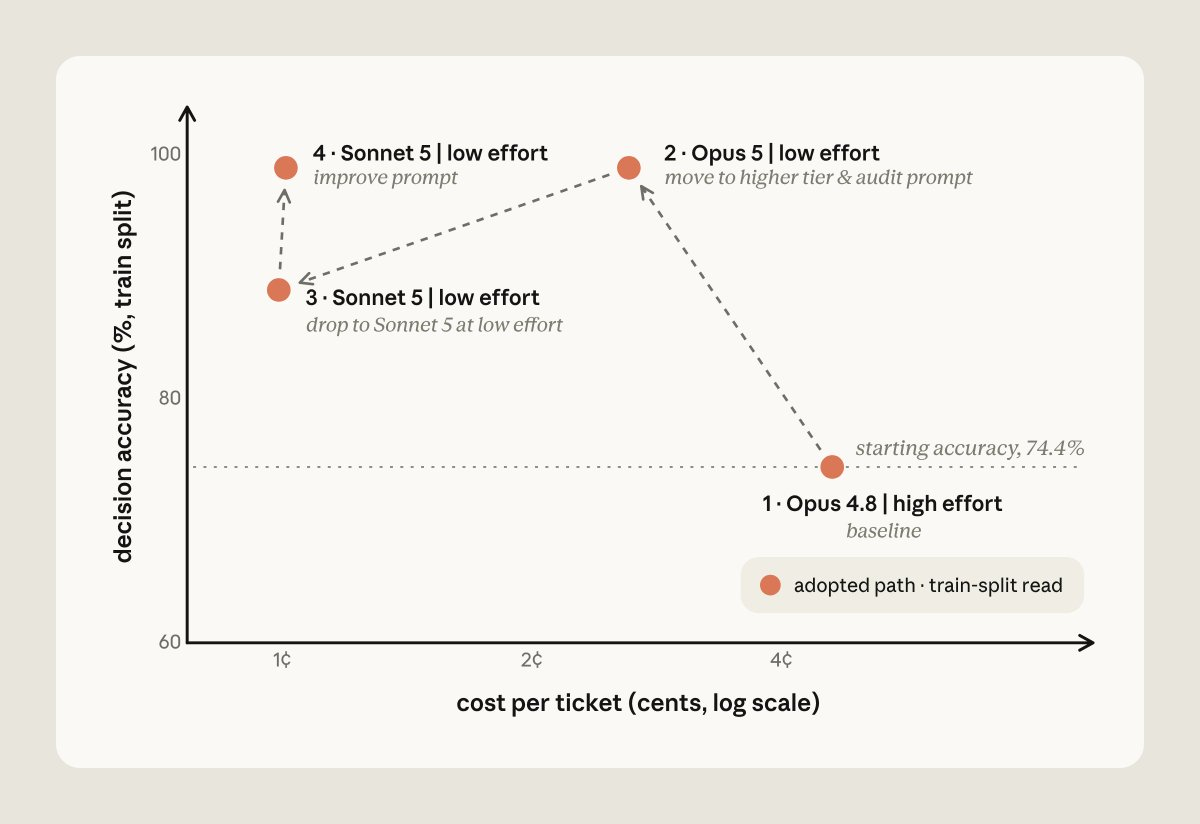
Anthropic 在一个客服基准上跑了它,起点是 Opus 4.8 的默认(高)effort。爬山器先尝试 Opus 5 低 effort,并用 prompt-audit 去掉强制工具调用仪式、草稿步骤和矛盾规则。这超过了 Opus 4.8 基线,训练准确率 98.9%,成本降到每张工单 2.6 美分。
接着它降到 Sonnet 5 低 effort,更便宜,每张工单 1 美分,但准确率掉到 88.9%。阅读失败的训练工单后,Claude 向提示中加入了路由规则和退款上限交叉引用,使 Sonnet 5 在相同成本下回到 98.9%。
在从未见过的 14 张留出工单上,最终配置得分 90.5%,原配置为 78.6%,成本约为原来的五分之一。
自动化降本
提示词缓存、指令和 effort 是常见的降本杠杆。为了对使用 Claude API 的应用代码做整体成本审计,Anthropic 新增了 /claude-api cost-optimize:它分析支出去向、应用降本措施,若你提供评测,还会展示节省与性能之间的权衡。
cost-optimize 先找出 token 花在哪里:若有 Claude Admin API key,则用来自组织的用量与成本报告;若应用记录了每次 API 响应上的 usage 对象,则用它;两者都没有,就读取构建请求的代码并估算。
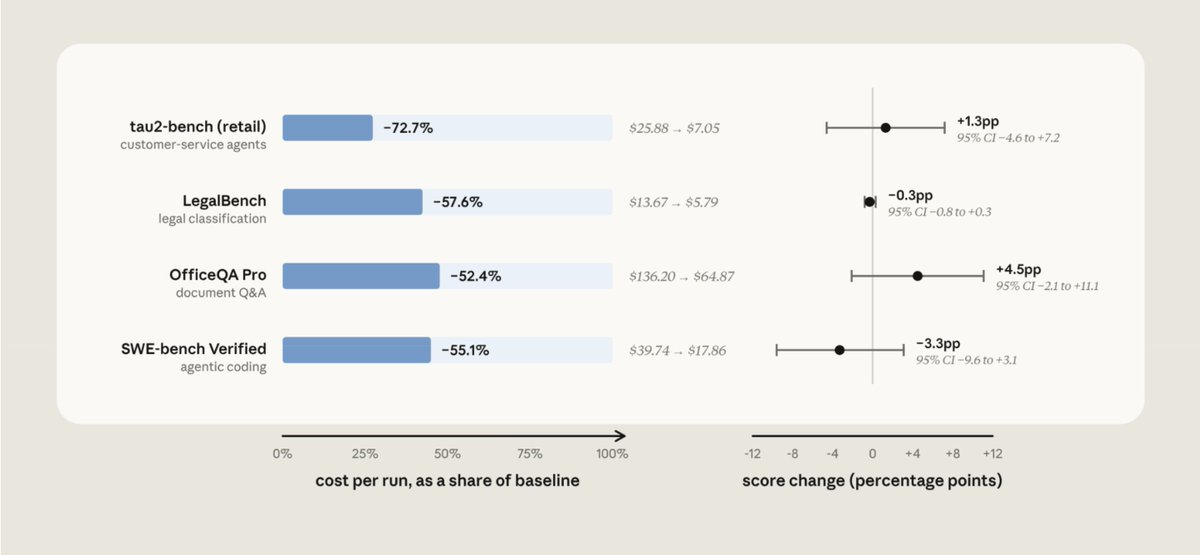
然后它会按可用节省排序:从提示词缓存开始,削减每次请求携带的内容(包括一次 prompt-audit)、限制输出,以及对无人值守工作做批处理。若你提供评测,它会进一步计算不同 effort 和模型选择下的成本与性能。Anthropic 以 Sonnet 5 为基线,在四个公开基准上跑了它:
- LegalBench(成本约降 58%): cost-optimize 建议跨任务缓存共享前缀、设低 effort,并用 Batch API 处理任务。思考 token 从 102,779 降到 8,284,通过率在噪声范围内,成本约降 58%。
- tau2-bench retail(成本约降 73%): 通过实现带显式断点放置的提示词缓存,cost-optimize 把支出降了 72%,通过率保持平稳。
- OfficeQA Pro(成本约降 52%): cost-optimize 加入批处理和文档缓存,成本从 136.20 美元降到 64.87 美元。
- SWE-bench Verified(成本约降 55%): cost-optimize 发现默认配置已经正确缓存。节省来自把 effort 设为 medium,并把智能体输出限制为几句简洁句子。每任务中位步数从 29 降到 17,提示 token 从 75.2M 降到 33.7M。
如何开始
- 迁移到前沿 Claude 模型、想检查现有提示时:先用 /claude-api prompt-audit。它会扫描工作目录中的提示、skills 和工具描述——可以是调用 Claude API 的应用代码,也可以是 Claude Code 的配置(CLAUDE.md、skills),并清除拖累前沿模型的常见反模式。
- 应用使用 Claude API、想做一次成本审计时:用 /claude-api cost-optimize。它分析 token 支出,然后测试不同杠杆:应用 prompt-audit,检查提示词缓存、批处理无人值守工作或限制输出的降本空间。若提供评测,它会衡量 effort 和模型选择的权衡。
- 最后,用 /claude-api hillclimb 在成本和性能上做搜索。给定评测后,Claude 会把它分成训练集和测试集,提出应用更新,目标是在保持基线性能的同时降本。Claude 会阅读失败的训练样本来指导搜索,最终配置在留出测试集上打分。
来源:Anthropic 官方博客,2026 年 9 月 8 日。
 AI 速览