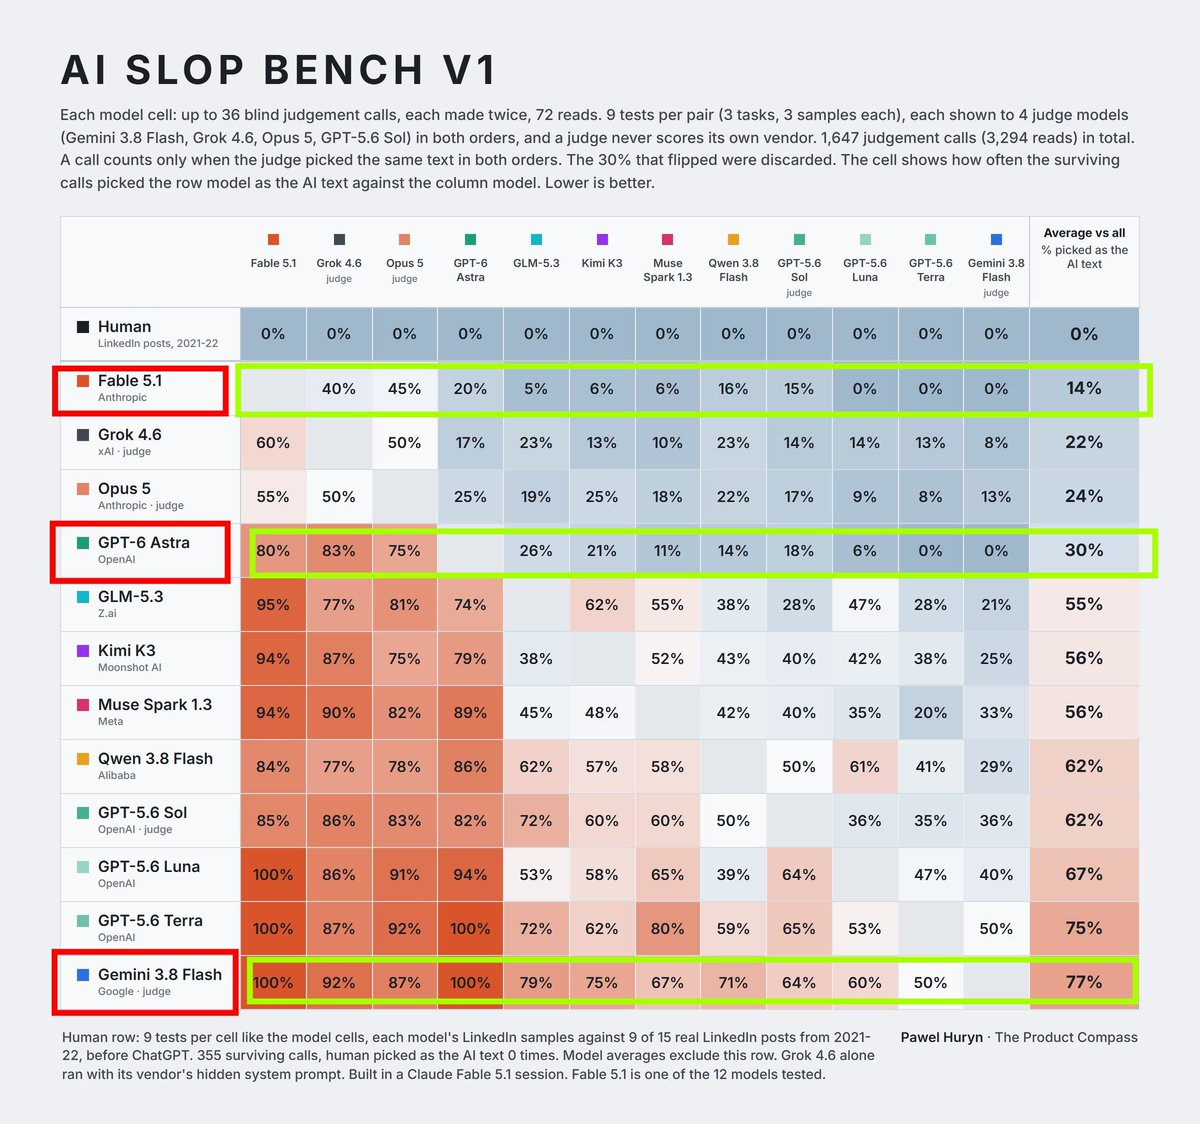
一个 AI 模型写出来的文章有多重的「AI 味」,现在有了一组可量化的数字。产品分析通讯《The Product Compass》作者 Pawel Huryn 完成了一次大规模盲测:让 12 个主流大模型完成同样的写作任务,再把文章两两配对交给 4 个 AI 评委辨认哪篇出自 AI 之手。结果,Anthropic 的 Fable 5.1 只有 14% 的文本被判定为 AI 所写,排名垫底的 Gemini 3.8 Flash 被识破率高达 77%,相差超过 5 倍。最刺眼的一组数字来自人工对照:模型写的 LinkedIn 帖子被评委选中 355 次,真人写的帖子被选中 0 次。 实验怎么做:108 篇文本,1,647 次盲判
方法决定了这组数据能不能信。Huryn 的做法分四步。
第一步,12 个模型各领 3 个写作任务:一篇关于为什么大多数产品路线图会失败的文章、一份帮助台功能的上线公告、一条关于「一个无人使用的功能带来的教训」的 LinkedIn 帖子。每个任务写 3 次,每篇控制在 500 词以内,全部不给系统提示。
第二步,把所有文章两两配对盲测。每对文本以两种顺序提交给 4 个 AI 评委——Gemini 3.8 Flash、Grok 4.6、Opus 5、GPT-5.6 Sol,让评委选出哪篇「更像 AI 写的」。评委不给自己同厂商的模型打分。 第三步,清洗数据。如果评委在顺序调换后改了答案,这次评判作废——这类「翻转」占全部评判的 30%。剩下的有效评判共 1,647 次,覆盖 108 篇文本。当两位评委看到同一对文本且都维持原判时,他们的一致率在 89% 到 97% 之间。
第四步,统计每个模型被选为「AI 味文本」的频率。数值越低,说明它的文字越不像 AI。
完整排名:三个梯队,差距超过 5 倍
12 个模型的「AI 味」被识破率排名如下,数值越低越好:
排名呈现清晰的三层结构。头部是 Fable 5.1、Grok 4.6、Opus 5 和 GPT-6 Astra,被识破率在 14% 到 30% 之间;中段是 GLM-5.3、Kimi K3、Muse Spark 1.3、Qwen 3.8 Flash 和 GPT-5.6 Sol,挤在 55% 到 62% 的窄带里;尾部是 GPT-5.6 Luna、GPT-5.6 Terra 和 Gemini 3.8 Flash,全在 67% 以上。
两个细节值得单独看。OpenAI 家族内部的分化最夸张:GPT-6 Astra 是 30%,同门的小型号 GPT-5.6 Terra 是 75%,相差 2.5 倍——「AI 味」重不重,同一个厂商的不同型号可以完全是两个档位。头部三强里 Anthropic 占了两席(Fable 5.1 和 Opus 5),但两者之间也差了 10 个百分点。
人工对照:355 比 0
整个实验里最有力的数字不在模型排名里,而在人类对照组。
Huryn 从自己 2021 年和 2022 年——ChatGPT 出现之前——的 LinkedIn 帖子里选出 9 篇,与每个模型写的 LinkedIn 帖子按同样的规则配对盲测。360 次判断里(355 次有效,5 次翻转剔除),模型写的帖子被判定为「AI 味文本」355 次,真人写的帖子被选中 0 次。
也就是说,这 4 个 AI 评委在分辨「人写的」这件事上没有一次看走眼。所谓「AI 味」不是玄学,它是一种真实存在、可被稳定识别的文本特征——至少对另一个 AI 来说是这样。
这次实验的三个争议点
这组数据在引用之前,有三个方法论问题需要摆在台面上。
第一,实验系统是用 Fable 5.1 搭建的,而 Fable 5.1 拿了第一。Huryn 自己把这称为「尴尬的部分」。辩护的一方可以说:Fable 只由 Google、xAI 和 OpenAI 的模型评分,同门回避规则在它身上反而执行得最严格,它是在「对手裁判」手里赢的。
第二,评委全部是 AI,而且四位评委本身都是参赛选手。AI 评委识别的是不是和人类读者识别的是同一种「AI 味」,实验无法回答。
第三,xAI 的 API 会附加自家的隐藏系统提示,Grok 4.6 是 12 个模型里唯一没有在空系统提示下运行的,它的 22% 与其他模型的数据不完全同质。
还有一层更根本的限定:这个实验测的是「被 AI 评委辨认成 AI 的频率」,不是写作质量排名。一篇被频繁认出的文章不一定差,一篇没被认出的也不一定好——它只说明前者的文本模式更接近当前模型产出内容的统计特征。
对内容创作者意味着什么
对靠内容吃饭的人,这个实验有三条可直接引用的结论。
选模型就是选「AI 味」。同一批写作任务,不同模型的被识破率相差 5 倍以上。如果目标是被 AI 检测工具或熟练读者当作人写的内容,模型选择的权重大于提示词技巧——至少这个实验没有测提示词,它测的全是模型的裸输出。
「AI 味」是统计特征,不是道德标签。排名靠后的模型写出的东西被同类模型一眼认出,说明它们的输出高度收敛于某种模式:这既是检测的依据,也是同质化的证据。
真人经验的识别度无可替代。355 比 0 的对照说明,基于真实经历的写作(哪怕只是几年前的 LinkedIn 帖子)携带着模型模仿不到的信号。对被「AI slop」(低质量批量 AI 内容)稀释的内容生态来说,这是个体创作者最难被替代的部分。
全部评判数据和 108 篇文本已发布在作者的 GitHub 仓库,方法可复核,结论可自行检验。
常见问题
这次盲测里 AI 味最重的模型是哪个?
Gemini 3.8 Flash,77% 的有效评判把它选为 AI 写的文本,12 个模型中排名第一。GPT-5.6 Terra(75%)和 GPT-5.6 Luna(67%)分列二、三位。
AI 味最轻的模型是哪个?
Anthropic 的 Fable 5.1,被识破率只有 14%。xAI 的 Grok 4.6(22%)和 Anthropic 的 Opus 5(24%)紧随其后。需要注意 Grok 是唯一带厂商隐藏系统提示运行的模型。
这个实验能证明哪个模型写作水平最高吗?
不能。它测的是文章被 AI 评委辨认出「AI 生成」的频率,与写作质量、信息准确性和读者偏好都不是一回事。低「AI 味」意味着文本模式更像人类作者,不意味着内容更好。
「AI slop」是什么意思?
指 AI 批量生成的低质量、高度同质化的内容。这个词被用来描述社交平台和搜索结果里大量模式雷同的机器文本。这次实验测量的「AI 味」,本质上就是一篇文本在多大程度上带有这类模型共性特征。
 AI 速览