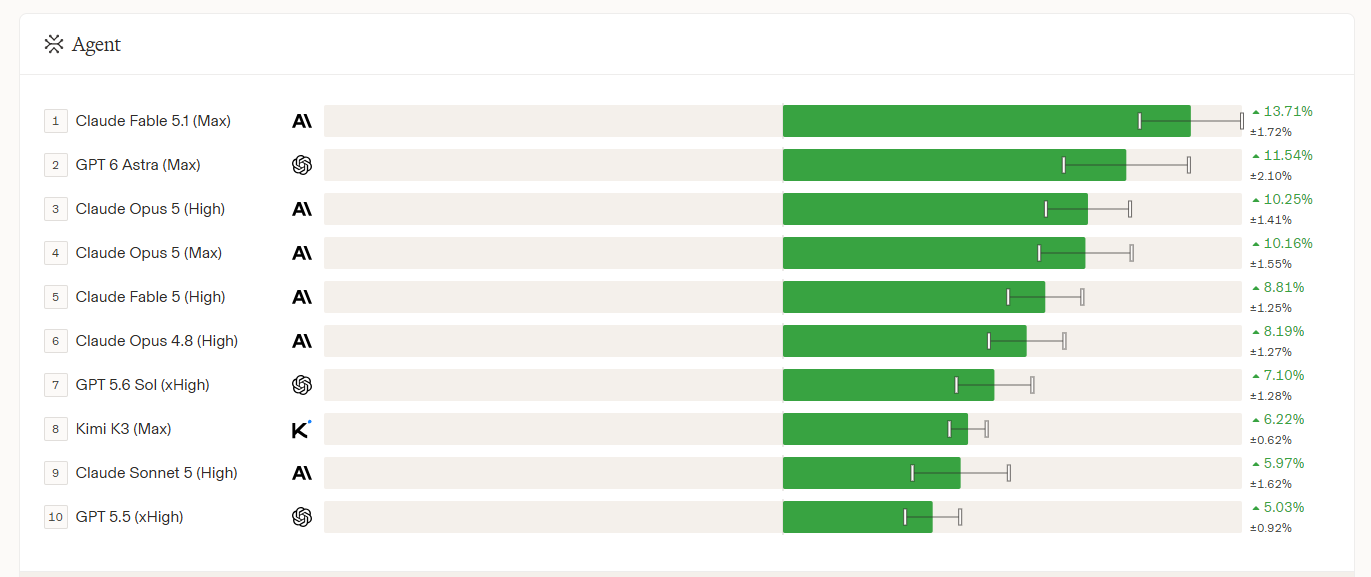
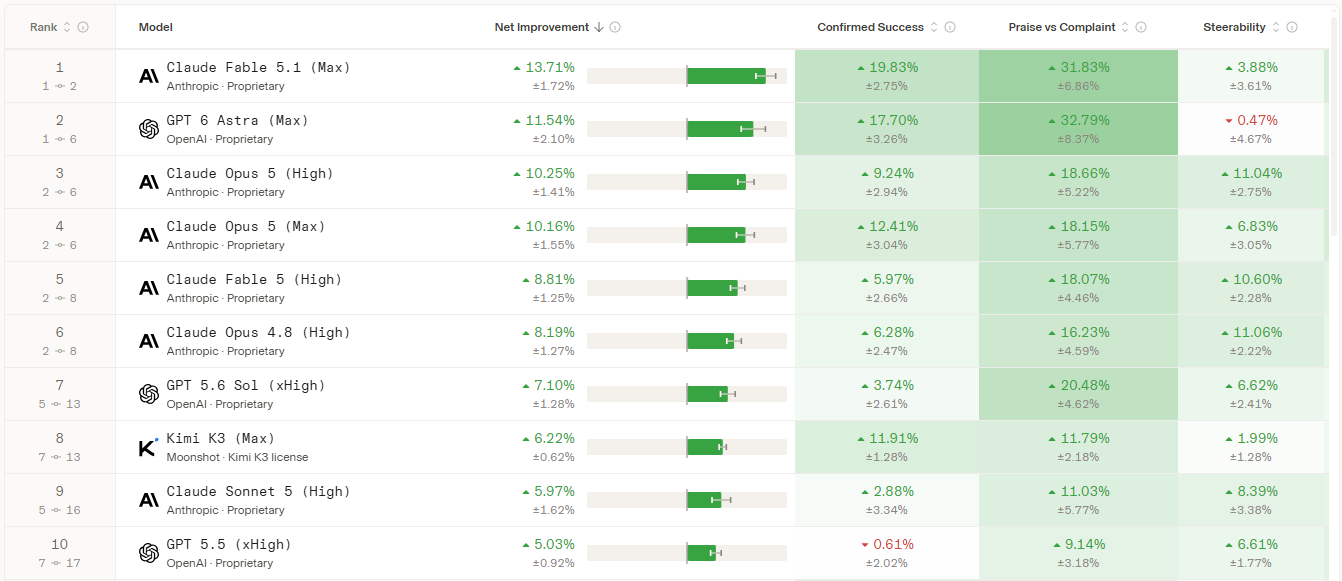
Agent Arena 是一份用真实 Agent 会话算出来的模型榜单,官方入口为 arena.ai/leaderboard/agent。它不看两两对战投票,而是把每一个真实会话随机分配给一个模型,观察它实际干活的结果。目前最新一期更新于 2026 年 9 月 16 日,覆盖 46 个模型、1,850,083 个会话,第一是 Claude Fable 5.1 (Max),净提升 +13.71%。 2026年9月AI大模型排名(46 个模型)
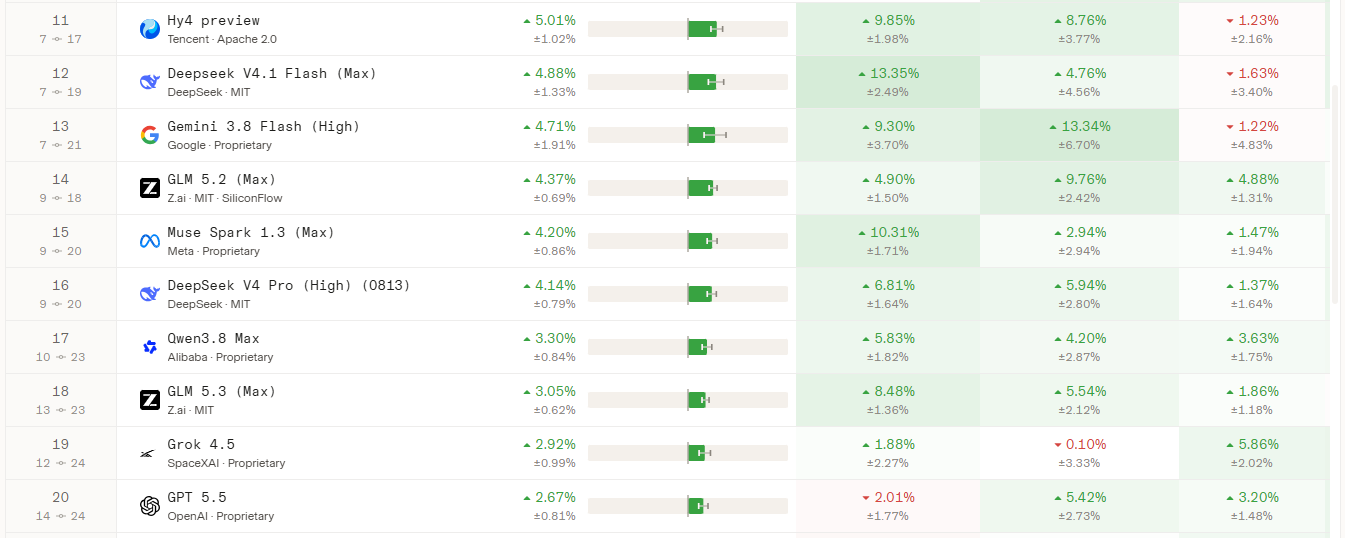
下表是 2026 年 9 月 16 日这一期的前 20 名,按净提升降序排列。置信区间与成本都取自官网原值。
| | | | | | | |
|---|
| | | | | | | |
| | | | | | | |
| | | | | | | |
| | | | | | | |
| | | | | | | |
| | | | | | | |
| | | | | | | |
| | | | | | | |
| | | | | | | |
| | | | | | | |
| | | | | | | |
| | | | | | | |
| | | | | | | |
| | | | | | | |
| | | | | | | |
| DeepSeek V4 Pro (High) (0813) | | | | | | |
| | | | | | | |
| | | | | | | |
| | | | | | | |
| | | | | | | |
这张表里有三个值得大家注意的地方:
前 10 名被两家包揽了九席。Anthropic 占 6 个(第 1、3、4、5、6、9 名),OpenAI 占 3 个(第 2、7、10 名),剩下一个是 Moonshot 的 Kimi K3(第 8 名)。国产模型里排名最高的是 Kimi K3,其后是腾讯的 Hy4 preview(第 11 名)和 DeepSeek 的 V4.1 Flash(第 12 名)。
负值不是"帮倒忙"。46 个模型里有 21 个净提升为负,第一个负值出现在第 26 名(Qwen3.8 Flash Next,−0.07%)。但按官方定义,净提升衡量的是"比平均模型好还是差",而平均值本身就在这批模型中间——所以一半左右为正、一半左右为负是这套算法的数学结果,不能读成"有 21 个模型在拖后腿"。负值只说明它低于这批模型的中位水平。
成本差距远大于能力差距。排第一的 Claude Fable 5.1 (Max) 每次任务成本 $4.25,排第 12 的 Deepseek V4.1 Flash (Max) 是 $0.05,相差约 85 倍;而两者的净提升是 13.71% 与 4.88%,相差不到 3 倍。全场最便宜的几档落在 $0.04(Hy3、Mimo V2.5 Pro),与最贵的 $4.25 相差超过 100 倍。如果你是拿它跑批量任务,这个数量级的差异通常会比名次更影响决策。
成本列标注的是 P50,也就是中位数而非平均值,因此不会被少数超长任务拉偏。输出 token 列同样是 P50。
榜单怎么查:入口、分类与筛选
| | |
|---|
| | Ranking 是常规名次表;Pareto 视图把能力与成本放在一起看,适合选型时权衡 |
| Overall / Code / Chat / Work | |
| All / Proprietary / Open source | 只看向开源模型时用,开源阵营里 Kimi K3、Hy4 preview、DeepSeek 系列都在前列 |
| | 想知道某家实验室整体水平而非单模型表现时切换到 Labs |
页面上每个列头旁边的信息图标可以点开,官方在那里给出了该指标的定义,这是核对口径最直接的方式,比看二手转述可靠。榜单底部还挂着五个信号的单项领先者,和总名次是两回事,建议一起看。
Agent Arena 榜单的注意事项
- 负值不等于能力差,只等于低于这批模型的平均。因为所有分数都是相对平均模型算出来的,一半左右为正、一半左右为负是算法结构的必然结果。把它读成"接近一半的模型在帮倒忙"是最常见的误读。
- 不能跨期比较分数。官方原话是:平均模型变强时平均值就上升,任何模型的净提升反而会下降。所以上个月的 +6% 和这个月的 +6% 不是同一件事,不同日期的分数不能直接对比。
- 新模型加入会改变所有人的分数。官方用了一个比喻:就像一场国际象棋比赛,更强的对手加入后,你的水平没变,但你的对手变了。你的分数会因为竞争环境变化而移动,哪怕你自己的行为一点没变。
- 引用名次必须带日期和会话数。这份榜单是持续更新的活数据,官方明确写着会随新会话刷新。只写"某模型排第几"而不写期次,结论不可引用。
- 必须连置信区间一起读。± 是 95% 置信区间,官方明确说区间重叠很多的两个模型应当视作大致相当。当期数据里第 3 名与第 4 名的区间几乎完全重合,第 1 名与第 2 名也明显重叠——按名次宣布胜负是不成立的。
- 注意会话量差异带来的区间宽度差异。会话数越多区间越窄。当期 Kimi K3 有 108,615 个会话,区间只有 ±0.62%;GPT 6 Astra 只有 10,372 个会话,区间是 ±2.10%。拿一个窄区间的模型去压一个宽区间的模型,结论要谨慎。
- Tool hallucination 的方向是反的。其余四个信号都是越高越好,只有它是越低越好。横向读表时别把这一列当成"越高越强"。
- 总分里不含全部信息。官方在 FAQ 里说明,另外还有若干已经跟踪但尚未计入总分的信号,包括 clean continuation、disapproval、会话内重试次数和工具错误率。也就是说当前的总分是这套框架的起点,不是全部。
- 名次是五个信号的等权平均。官方说明每个信号各占一票。但如果你的场景只关心其中一项——比如你只在意工具幻觉率——那么直接看那一列比看总分更准。
- 榜单不能直接拿来做选型决策。它衡量的是通用 Agent 场景下的编排表现。你的工具栈、任务类型、延迟要求和预算都不在评测范围内。这份榜能把候选集缩小,最终还是要拿自己的任务抽测。
Agent Arena 榜单常见问题解答
Q:Agent Arena 是什么?
A:Arena 的 Agent 榜单。它把每一个真实 Agent Mode 会话随机分配给一个模型,观察该模型作为编排者的实际表现,覆盖 bash 执行、网页搜索、页面抓取、写文件等工具调用场景。当期收录 46 个模型、1,850,083 个会话。
Q:它和其他 Arena 榜单有什么区别?
A:官方列了三点。一是采用单线程会话而非两两对战;二是显式反馈与隐式行为信号混用,而不只用投票;三是会话随机分配,因此可以从行为差异中推断因果效应。整体衡量的是"把平均模型换成某个模型后,各指标会变化多少"。
Q:净提升(Net improvement)是什么意思?
A:模型相比平均模型表现好多少或差多少,把每个信号列的分数折成一个数。正值表示高于平均,负值表示低于平均。因为它是相对值,平均模型变强时这个分数会缩水。
Q:为什么有负值?是不是说明模型不管用?
A:不是。负值表示低于这批模型的平均水平。由于分值以平均模型为基准,一半左右为正、一半左右为负是算法结构的必然结果。当期 46 个模型中有 21 个为负。
Q:数字后面的 ± 是什么?
A:95% 置信区间,表示基于目前已收集数据的确定程度。官方举例说明:+5% ±2% 的实际含义是"大约在 3% 到 7% 之间"。两个模型区间重叠较多时应视作大致相当。
Q:名次是怎么算出来的?
A:官方说明总名次是各信号净提升的等权平均,每个信号各占一票。每个信号的分数则是相对随机基线的百分点对比。
Q:榜单多久更新一次?
A:持续更新。官方称它是"活的测量"而非一次性静态分数,会随新会话数据刷新,页面上会显示最后更新日期和当期会话数。本文数据为 2026 年 9 月 16 日那一期。
Q:为什么同一个模型的名次会变?
A:两种情况。一是新会话积累让置信区间收窄,接近的名次会逐渐清晰;二是新模型加入抬高了或拉低了平均基准,导致所有模型的分数同时移动,即使它自身行为没变。
Q:怎么用它来选 Agent 模型?
A:先按场景切到对应的分类(Code、Chat 或 Work),再按预算筛掉成本/任务超出上限的模型,然后只在置信区间不重叠的模型之间比名次。如果特别在意某一项行为,直接看那一列。最后拿自己的真实任务抽测一遍。
这份榜单真正的价值不在于给出一个第一名,而在于它把"用了模型之后任务变好还是变差"变成了可量化、带误差棒的数字。看的时候盯住三样东西:期次日期、置信区间、以及你真正在意的那一列。想持续跟进 Agent Arena 的期次更新与信号变化,可以关注本站的 AI 工具栏目,那里也会同步 AI大模型排名 口径调整的记录。
 AI 速览