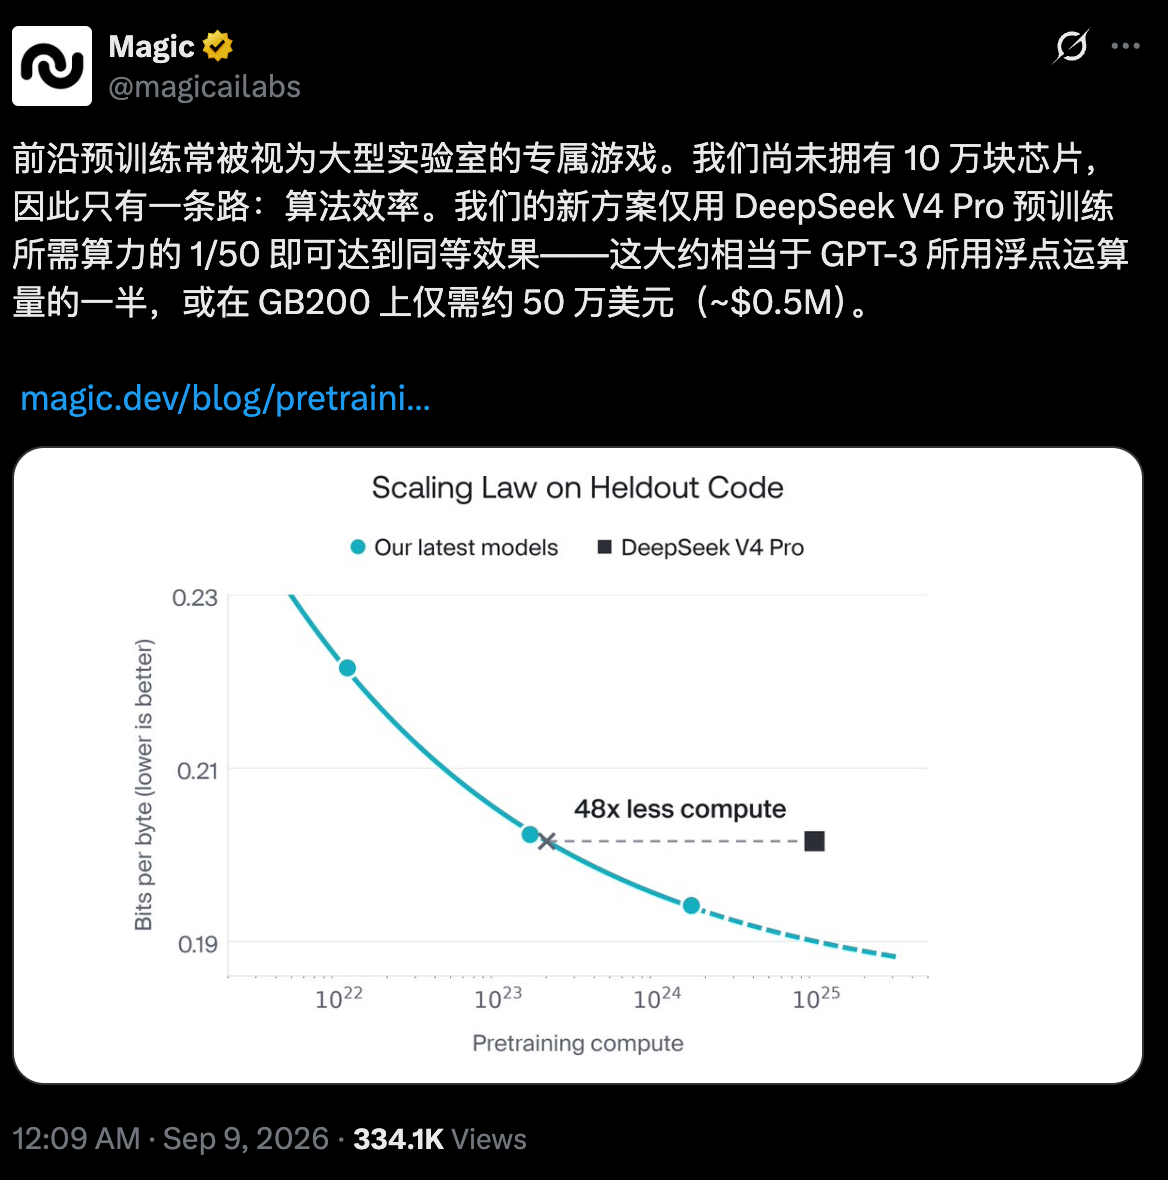
- Magic.dev 称其预训练配方用约 1/50 的 FLOPs 匹配 DeepSeek V4 Pro 基座模型,约合 GPT-3 预训练算力的一半,折 GB200 算力约 50 万美元
- 放大 10 倍(约 400 万美元)后,官方称模型在困惑度评测上超过所有公开开源基座模型
- 评测指标是 heldout 数据上的 bits-per-byte,对照对象为 DeepSeek V4 Pro/Flash、Kimi K2、Nemotron 3 Ultra 四个开源权重基座
- 官方一个意外发现:Nemotron 3 的预训练损失全面优于 DeepSeek V4 Pro,提示其 RL 后 benchmark 偏弱可能是后训练问题
- 模型未发布、不开源、无 API,全部数据为官方自测,无第三方独立复现
一句话说清楚:谁、做了什么、为什么值得关注
Magic.dev 是一家 2022 年创立的 AI 编程公司,创始人 Eric Steinberger 与 Sebastian De Ro,累计融资约 4.65 亿美元,投资方包括 Eric Schmidt、CapitalG、Atlassian 和红杉。公司目标是用自研模型做编程与自动化 AI 研发。
9 月 8 日,Magic 在官方博客发布预训练研究更新,核心主张是:前沿预训练不是只有大厂才能玩的游戏,算法效率可以补上算力差距。按官方给出的数字,其配方与领先开源权重基座模型相比,算力效率高出一个数量级以上。
需要先说明可用性状态:这是一篇研究博客,不是产品发布。Magic 的模型没有发布、没有开源、没有 API,博客结尾的原话是「期待发布这个东西」。读者能验证的只有论文级别的数字与口径,无法上手试用。
对照基线与评测口径
Magic 的评测对象是四个公开可得的开源权重基座模型,闭源模型(Claude、Gemini、GPT 系列)因基座不可得而没有进入对照。衡量指标是 heldout 数据上的 bits-per-byte(bpb),这个指标归一化了不同分词器的差异,数值越低越好。算力统一按 6·N·D 估算,N 为激活参数量,D 为预训练 token 数。 数据来源:Magic 博客脚注,称各模型的参数量从 HuggingFace 权重的 safetensors 头读出,token 数取自各家技术报告。
按这张表,Magic 当前代模型的训练算力约为 DeepSeek V4 Pro 的六分之一,而官方称其在三个 heldout 评测集(私有代码库、研究论文、heldout 数学题推理)上的 bpb 都与 V4 Pro 持平或更优。分领域看,效率倍数从数学论文的 21 倍到 heldout 数学推理的 127 倍不等。
为防数据污染,Magic 称评测集剔除了与训练语料有 96 字符窗口重合或高 Jaccard 相似度的文档,知识类评测用第三方前沿模型改写原文,且评测集的解析器与训练管线所用的解析器不同。基线模型的 logprobs 在 vLLM 与 SGLang 两个引擎、GB200 与 GB300 两种硬件上交叉测过,另与 Fireworks 合作在其自有推理引擎中复核。污染处理只能在自家模型一侧做,官方承认这一点,并指出基线侧若有污染只会让基线占优。
技术路径:没有单点突破,是几十项改进的乘积
博客对方法的自述可以归纳为三件事。第一件是地基:2024 年底的早期放大尝试反复失败,公司先解决了收敛稳定性、等价于 FP32 的低精度训练质量、基础设施和超参缩放规则。第二件是评估纪律:每一项模型、优化器或数据改动,都用横跨两个数量级算力的三个模型做幂律拟合,外推有帮助才保留;每隔几周做一次十分之一规模训练,每隔几个月跑一次全量 hero run,内部代号从 V2(2024 年底)迭代到 V5(2026 年 9 月)。第三件是累积方式:效率提升来自架构、优化器、训练目标、数据筛选四个方面数十项改动的乘性叠加,官方提到,NanoGPT speedrun 里有效的小模型技巧很多在大模型上失效。
按官方 Figure 4,V5 配方的算力效率是 V2 的 505 倍;同图给出的参照线是 Nemotron 3 约 24 倍、Kimi K2 约 10 倍、DeepSeek V4 Pro 约 5.6 倍。
关键成果与成本
官方的核心数字有三个。匹配 DeepSeek V4 Pro 基座水平用约 1/50 的 FLOPs,约合 GPT-3 预训练算力的一半,折 GB200 约 50 万美元。放大 10 倍、成本约 400 万美元后,模型在困惑度评测上超过所有公开开源基座。按官方拟合的 scaling law 外推,用 V4 Pro 的配方达到同等能力需要超过 1 亿美元。
为检验预训练损失能否转化为下游表现,Magic 从基座直接做了一段低算力数学 RL(无 SFT、无蒸馏)。在 400 道难于 AIME 的私有 heldout 竞赛题上,e24 的 pass@1 达到 72%;官方称该模型在 AIME26 上达到 90% pass@1 时只用了预训练算力的 0.2%,并说明改用 heldout 集是因为发现 AIME 在部分第三方模型中存在污染。
| 低算力 RL 数学 pass@1(官方图中对照线) |
|---|
| |
| |
| |
| |
| |
| |
| |
| |
需要标注的边界有三个。图中超过最大训练量的曲线段是投影,不是实测;所有数字来自 Magic 自测,无第三方独立复现;困惑度与 bpb 衡量的是预训练质量,不等于编程等下游任务的最终表现,官方自己也只把 RL 实验称为 sanity check。
对行业的启示
原文的观点是:预训练、agentic RL 和长上下文三件事足以造出超人编程代理并自动化 AI 研发,Magic 自称可能是世界上训练万亿参数模型的最小团队,下一步是长周期 RL、对齐训练和发布模型。
编辑判断:如果 1/50 的效率比成立,前沿基座预训练的准入成本从亿美元级降到百万美元级,有算法能力的小团队可以入场,这是成本叙事真正的分量。但成立与否取决于两个未验证前提:bpb 优势能否在发布后的真实编程任务中兑现,以及投影曲线外推是否站稳。在模型发布或第三方复现之前,这篇博客的恰当读法是一份口径透明的工程自证,不是成本结论。博客中另一条容易被忽视的信息是 Nemotron 3 的意外发现:其预训练全面优于 DeepSeek V4 Pro,若经复核成立,说明基座层的竞争格局与 benchmark 排名给出的印象不一致,后训练正在掩盖预训练的真实差距。
 AI 速览