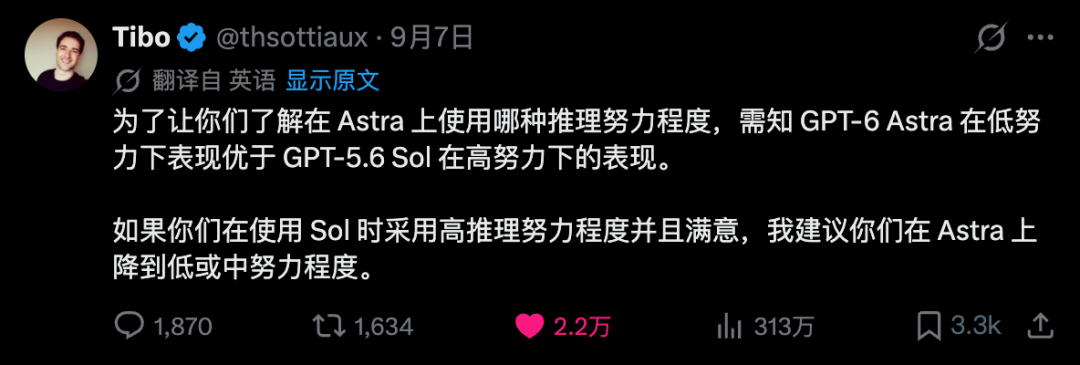
GPT-6 Astra 全面开放后,全网讨论的焦点很快从模型能力转向了 “额度烧得太快”“推理档位怎么选”。从低、中、高、极高、最高到 Ultra,多数用户对档位差异、适用场景、成本控制存在明显误区。本文结合实测体验,拆解推理等级的本质,给出不同订阅用户的选型方案与省额度技巧。
一、核心认知:推理等级不是模型分级,是思考预算
很多人会把推理等级(Reasoning Effort)理解为 “不同能力的模型”,这是最常见的误区。
本质上,所有档位用的都是同一个 GPT-6 Astra 模型,推理等级决定的是模型愿意为任务投入的思考时间、验证次数、工具调用量。就像让同一个人解题,思考 1 分钟和思考 1 小时,人没有变,只是投入的精力与严谨度不同。 档位越高,模型越倾向于反复检查边界条件、验证假设、排查风险、调用更多工具,对应的 Token 消耗与耗时也会同步上升。但对于简单任务,开到最高级也不会让答案更准确,只会平白消耗额度。官方也明确表示,GPT-6 Astra 的 “低” 档位能力,已经超过前代 GPT-5.6 Sol 的 “高” 档位。
二、档位拆解:从低到 Ultra,到底有什么区别
常规推理档位分为低、中、高、极高、最高五级,核心差异是思考深度与验证强度:
- 低 / 中:快速响应,适合日常问答、简单代码、基础信息整理,模型凭已有知识直接输出;
- 高:增加边界检查与基础验证,适合常规开发、文案撰写、普通方案设计,是多数场景的性价比之选;
- 极高 / 最高:增加多轮验证、替代方案推演、风险排查,适合复杂系统、高风险任务、核心方案规划。
最容易混淆的是Ultra 档位,它和普通档位不是同一个维度。普通最高档是 “让一个人全力思考”,而 Ultra 是 “成立专项工作组”,模型会自主调度多个子任务、调用多类工具、拆分协同工作,因此 Token 消耗会成倍上涨,并非单纯的 “更聪明”。
三、分人群选型:Plus 与 Pro 用户的最优档位策略
不同订阅的额度差异极大,选型策略完全不同。 Plus 用户:额度总量有限,核心原则是 “能省则省”。首先明确:ChatGPT 聊天模式与 Codex 额度相互独立,日常聊天、搜索、分析优先用网页版聊天模式,不占用 Codex 额度。Codex 内日常任务推荐常驻 “中” 档位,稍复杂的任务临时开到 “高”,不建议继续往上,避免额度快速耗尽。
Pro 用户(100 美元 / 200 美元档):额度更充足,可根据任务阶段动态切换。日常开发、常规任务推荐常驻 “高” 档位,兼顾效果与成本;复杂项目、架构规划、风险排查类任务,先用 “最高” 档位完成方案调研与整体规划,输出执行计划后,再切回 “高” 档位落地执行,是兼顾质量与成本的最优策略。 “极高” 档位定位尴尬,普通任务用不上,复杂任务直接开 “最高” 更高效,实际使用场景很少。Ultra 仅推荐在额度即将重置、且有大量任务待处理时短期拉满使用,日常常驻性价比极低。
四、避坑总结:别迷信高等级,匹配任务才最省
使用推理等级的核心原则是:档位与任务难度匹配,而非越高越好。很多时候反复调试低档位导致的多轮对话,反而比一次开高档位跑完消耗更多 Token。
从投入产出比来看,200 美元 Pro 档的单位 Token 成本最低,适合高频使用的创作者与开发者。但比 Token 成本更贵的,是错误的方向和被浪费的时间 —— 比起一味节省额度,选对档位、让任务一次跑通,才是更高效的成本控制。 整体而言,推理等级不是能力分级,而是精力预算。理解这一点,才能既用好 GPT-6 Astra 的能力,又避免额度快速见底。
 AI 速览