9月10日消息,DeepSeek 正式发布 DeepSeek V4.1 Flash 模型,同步上线 API 并开源。这是一次换代而不是新增:V4 Flash 与 V4 Flash Vision Exp 已下线,调用名统一为 deepseek-flash;V4 Pro 也定了退场时间点,北京时间 2026 年 9 月 14 日 12:00 之后至未来 V4.1 Pro 上线之前,访问 deepseek-v4-pro 的请求会全部路由到 V4.1 Flash,并按 V4.1 Flash 的价格计费。新价格已在 9 月 10 日 12:00 生效。 552B 的 MoE 模型,输入和输出不对称
V4.1 Flash 是 552B 参数的 MoE 模型,MoE 指推理时只激活部分参数。按官方说明,它采用全新的 Causal-Encoder-Decoder 结构,输入和输出不对称,输入激活 8B,输出激活 16B,成本显著低于已知的同尺寸模型。它具备原生多模态视觉理解能力,API 文档的功能表里也把图像理解列为支持,而 deepseek-v4-pro 一项为不支持。
官方说这套新结构的出发点是能力上限更高、推理速度更快、吞吐更大,并且可以扩展到更大参数的模型,V4.1 Flash 是这个系列里尺寸最小的一个。模型同时换了预训练方式,并经过更大规模的强化学习后训练。
技术报告补上了发布稿没写的规格。语言主干 40 层,前 20 层是 causal encoder、后 20 层是 decoder,前两层用滑窗注意力,其余层用压缩稀疏注意力(CSA2);除 552B 主干参数外还有 196B 的 Engram 参数,支持的上下文长度到 100 万 tokens。预训练用 45T tokens 的多模态语料,稀疏注意力在 64K 序列长度上从头训练,没有稠密注意力的预热阶段。报告说后训练环节没有算法创新,沿用监督微调、强化学习与在策略蒸馏的常规流程,改动集中在数据合成与环境构建的管线。
V4 Pro 也定了退场时间
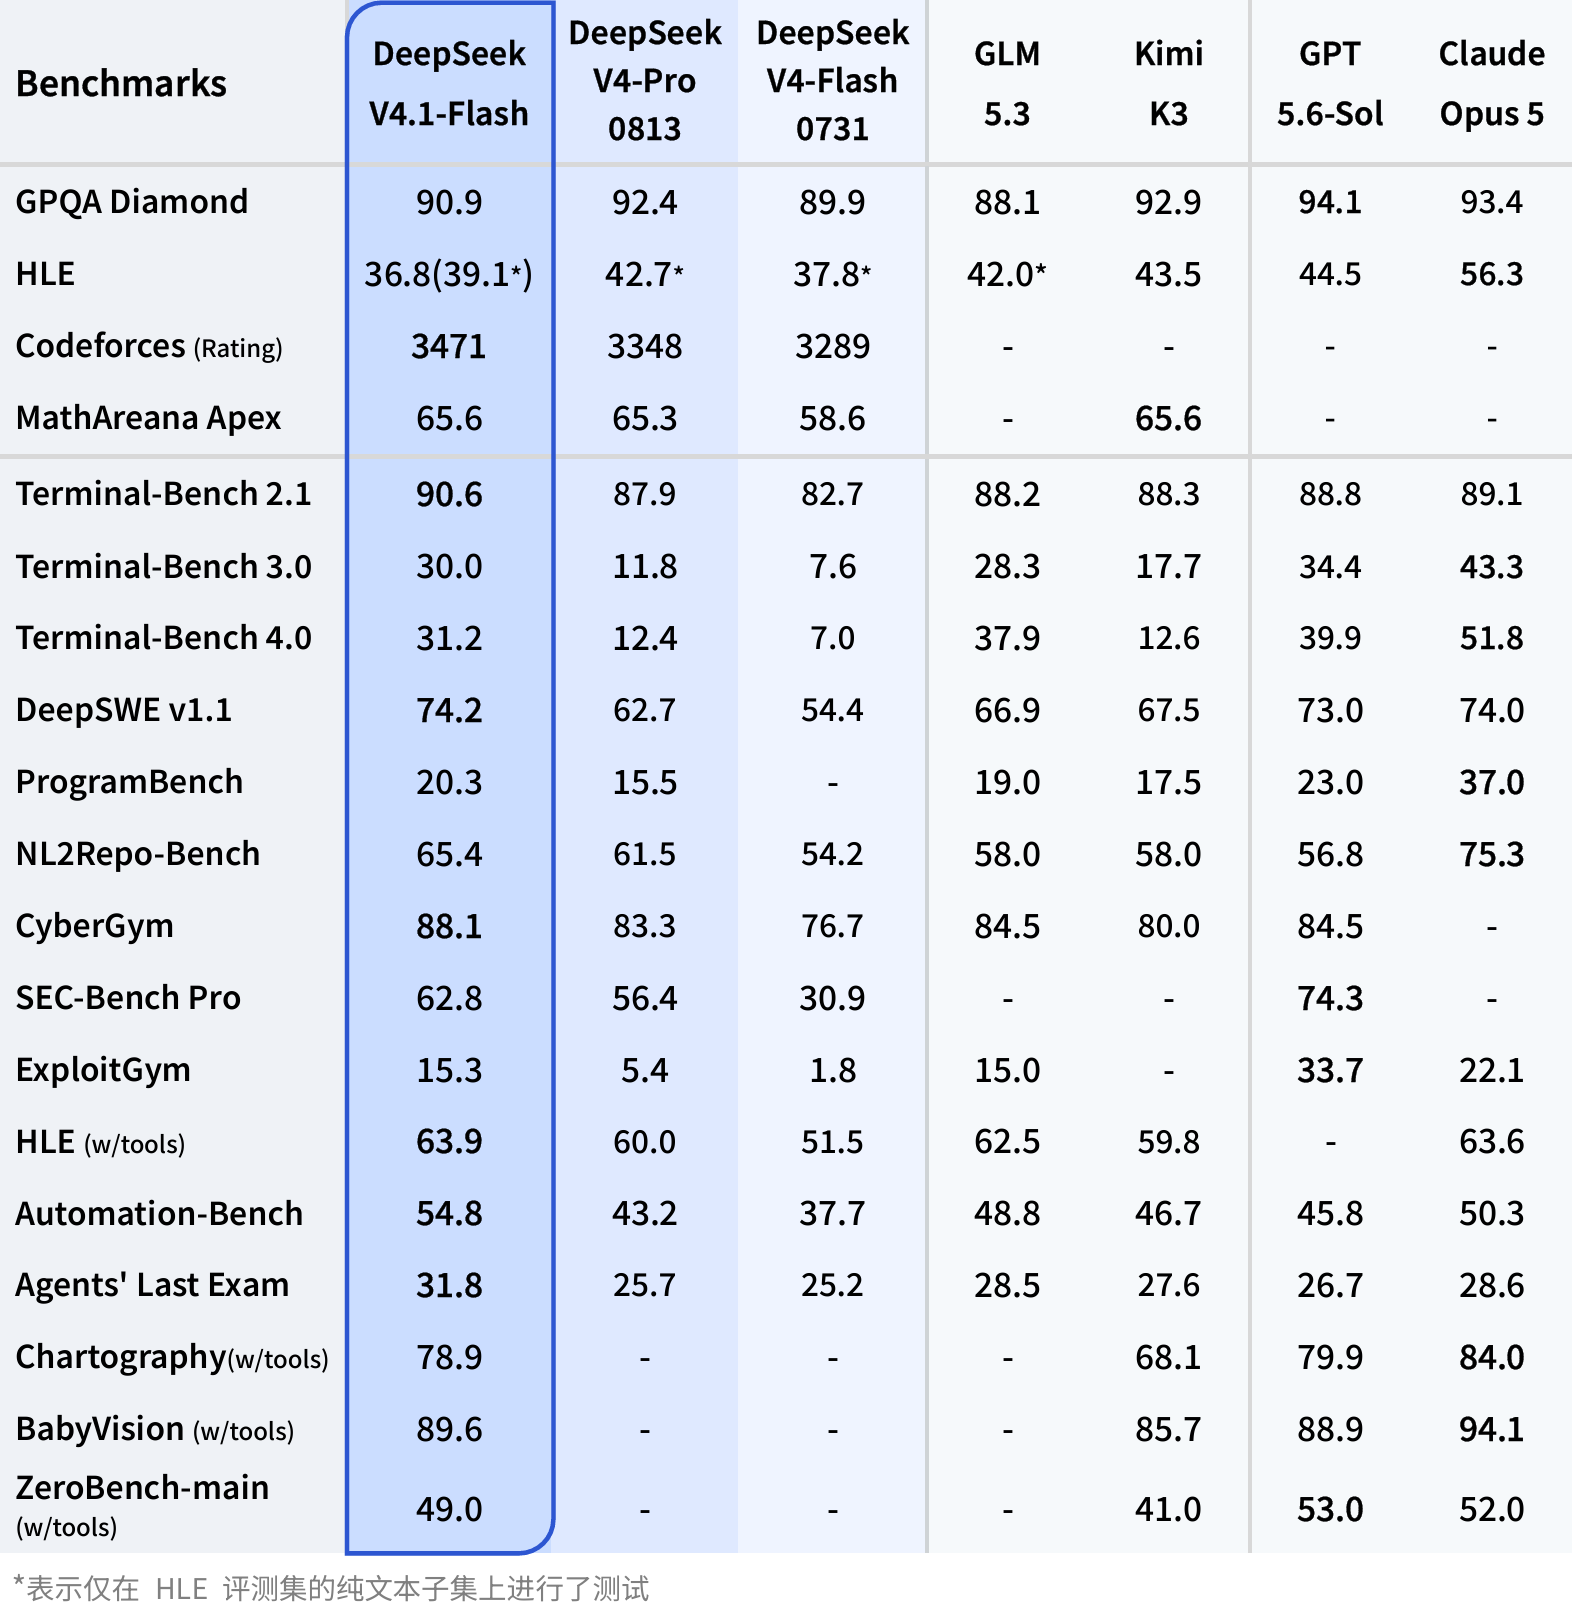
发布稿称 V4.1 Flash 在基准测试中超越了包括 V4 Pro 在内的一众旗舰模型;API 文档的脚注补了一句,经多方测试,它在性能、费用、速度、总用时等各项指标上全面超越 V4 Pro,因此 V4 Pro 将被有序下线。
发布稿的对比图把 7 个模型放进同一张表,比较 19 项基准:V4.1 Flash、DeepSeek V4-Pro 0813、DeepSeek V4-Flash 0731、GLM 5.3、Kimi K3、GPT 5.6-Sol 与 Claude Opus 5。16 项给出 V4.1 Flash 与 V4 Pro 的分数,前者在 14 项上高于后者,Terminal-Bench 2.1 为 90.6 对 87.9,DeepSWE v1.1 为 74.2 对 62.7,CyberGym 为 88.1 对 83.3,Codeforces 为 3471 对 3348。低于 V4 Pro 的两项是 GPQA Diamond 的 90.9 对 92.4 和 HLE 的 36.8 对 42.7,HLE 一行的星号注释写明该分数只在评测集的纯文本子集上测试。Chartography、BabyVision 与 ZeroBench-main 三项只给出 V4.1 Flash 的分数,V4 Pro 一栏为空。 技术报告提供了另一组对比,对象是未做后训练的基础模型。V4.1-Flash-Base 是 552B 主干参数、8B/16B 激活,对照的 V4-Pro-Base 是 1.6T 参数、49B 激活。16 项可比基准里,V4.1-Flash-Base 高于对手的只有 MMLU-Pro、BigCodeBench、HumanEval、GSM8K 四项,HumanEval 为 79.4 对 76.8;其余 12 项都低于对手,其中 Simple-QA verified 为 42.3 对 55.2,LongBench-V2 为 45.2 对 51.5。报告把差距不超过 0.3 分算作同一水平,这 12 项的差距都超过该阈值。它把这类结果表述为「相当」与「部分任务更好」,并写明在需要专家级领域知识的科学类 Agent 任务(Terminal-Bench 4.0)上与巨型模型仍有差距。
报告的局限一节提醒两点:基准分数接近饱和,分数接近不等于在最难的推理与边缘案例上达到闭源前沿水平;新引入的架构改动也带来尚未完全刻画的鲁棒性边界,CSA2 的 Top-K 选择错误与 SWA Bounded Replay 的近似状态重建,在未测试的边界场景下仍可能造成能力下降。
价格表上两款模型的差别很直观。同一档闲时价格下,V4.1 Flash 缓存未命中的输入是 1 元/百万 tokens,V4 Pro 是 4.5 元;输出是 4 元对 13.5 元。并发上限也有差别,V4.1 Flash 为 2500,V4 Pro 为 500。
API 价格同日中午生效,闲时是高峰的一半
得益于架构创新,V4.1 Flash 的成本更低,所以定价随之下调。现在的价格是:缓存命中的输入,闲时 0.02 元/百万 tokens,高峰 0.04 元;缓存未命中的输入,闲时 1 元,高峰 2 元;输出闲时 4 元,高峰 8 元。高峰时段为北京时间工作日的 9:00 至 12:00、14:00 至 18:00,其余时段为空闲,周末休息日算在空闲时段内,闲时价格是高峰的一半。新价格从 9 月 10 日 12:00 起执行。
发布稿提到,Agent 场景里缓存命中的费用占比往往较高,而新模型压缩了 KV Cache,也就是上下文缓存。给出的数据是:对 HBM 的需求比上一代减少到 1/4,对 SSD 的需求减少到 1/8;相对初代模型,KV Cache 已经缩小 437 倍。发布稿的 KV Cache 图按每 token 占用的字节数给出这条曲线:V1 为 38.9 万字节,V3.2 为 4.8 万字节,V4 Flash 为 3514 字节,V4.1 Flash 为 890 字节,图上标出的三级降幅为 8.1 倍、13.7 倍与 3.9 倍。技术报告把这项压缩拆成三处改动:CSA2 在层间复用全局 KV、索引器 K 与 Top-K 索引,缓存精度改用 FP4,部署上用 SWA Bounded Replay 只重放最近一个窗口的 token 来近似重建滑窗 KV,代价是少量预填充重算。报告给出的口径是:常驻 HBM 的全局 KV 为每 token 890 字节,约为 V4 Flash 的四分之一;常驻 SSD 或主机内存的持久 KV 约为 V4 Flash 的八分之一,两者都在相同序列长度下比较。
旧模型名还能调,但后面已经是新模型
V4 Flash 与 V4 Flash Vision Exp 已下线。出于兼容考虑,旧模型名 deepseek-v4-flash、deepseek-v4-flash-vision-exp 暂时仍可调用,请求由 V4.1 Flash 提供服务,并按 Flash 的价格计费。调用方不改代码也能继续跑,但拿到的回答来自新模型。
已经在用 V4 Pro 的调用方有九天缓冲。9 月 14 日 12:00 之后,deepseek-v4-pro 同样会被路由到 V4.1 Flash 并按 Flash 单价计费,直到 V4.1 Pro 上线。官方没有给出 V4.1 Pro 的时间表。
开源放出了编码参考与最小推理实现
模型已开源,仓库在 Hugging Face 的 deepseek-ai/DeepSeek-V4.1-Flash,采用 MIT 许可,技术报告 DeepSeek_V41_Tech_Report.pdf 一并放在仓库里。仓库里是提示词编码参考和一套最小 PyTorch 推理实现,涵盖视觉编码器与 aligner、滑动窗口加压缩稀疏注意力及其两级索引器、engram n-gram 查表、MoE、Hyper-Connections 与 DSpark 前向路径;权重文件存放在另一个仓库。
官方表示会支持开源社区做推理适配,并扩大部署范围。大规模部署需要相应资源,发布稿给出的门槛是约 2k 卡 GPU 加存储集群。
合作方与自家框架同步接入
腾讯的 WorkBuddy、CodeBuddy 和 OpenCode 作为官方合作伙伴,官方称已全量接入 V4.1 Flash。同期发布的 DeepSeek Harness v0.1.5 候选版也把内置模型目录的第一项改成了 deepseek-flash,API 与自家 Agent 框架这次用的是同一个模型名。  AI 速览