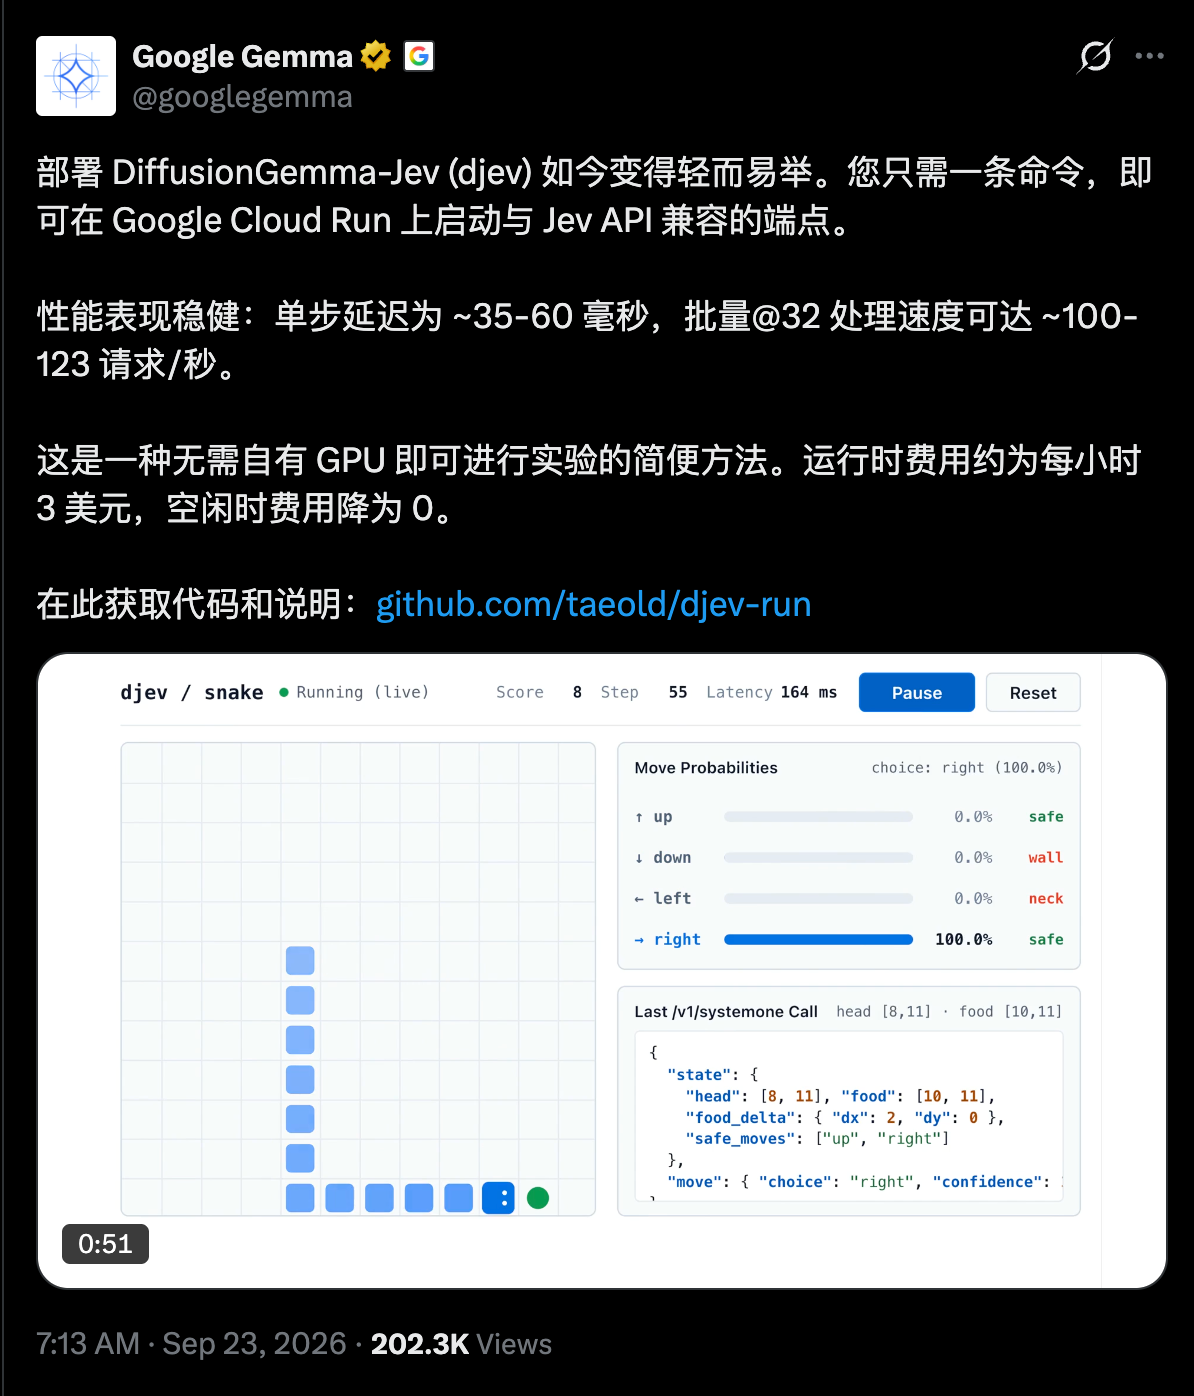
9月23日消息,Gemma 发帖推荐一个名为 djev-run 的社区项目。后者把 Google 的开源扩散模型 DiffusionGemma 包装成 Jev 兼容的决策 API,一条命令即可部署到 Cloud Run,空闲时段不收费。官方账号在帖中给出了性能数字,同时注明项目出自社区开发者之手——推荐的是别人的作品,不是谷歌的产品。
官方账号推荐的是社区作品
帖子称,用 djev-run 可以在 Cloud Run 上以单条命令启动一个 Jev API 兼容端点。性能方面,单步延迟约 35–60 毫秒,批量大小 32 时吞吐约 100–123 请求/秒。运行成本约每小时 3 美元,无请求时自动缩容到零、停止计费。发出不到一天,这条帖子获得约 20 万次浏览、3700 次点赞和 366 次转发。
Google DeepMind 今年 6 月发布了开放权重的 DiffusionGemma:基于 Gemma 4 骨干、总参数 26B、每次激活约 4B 的混合专家结构,用离散扩散而非逐词生成的方式产出文本。开发者 mmastrac 在模型上实现了 djev,把它变成 Jev 风格的决策接口;开发者 taeold 又发布 djev-run,提供 Cloud Run 的一键部署。9月20日,开发者 Daniel Lee 发帖推荐这套方案;两天后 Gemma 官方账号跟进,跟帖里把功劳指回原作者:"Credits to @mmastrac and @dylayed"。
扩散模型读的是分布,不用生成整段话
Jev 是 TypeSafe AI 的结构化决策服务,接口接收一个状态和一组问题,返回各选项的概率。djev 复刻了这套接口:问题分三类,是/否题直接返回概率,选择题返回各选项概率与置信度,打分题返回有序分值。
djev 把整张答案画布的种子固定为答案模板,只把答案槽位留作噪声,一次去噪后直接读出每个槽位的分布——不需要像自回归模型那样逐词生成。项目自述这套读取方式依赖 vLLM 的一个扩散扩展分支,djev 本身是该扩展的示例服务器。类似尝试不止一家,另有开发者用 Inception Labs 的 Mercury 扩散模型实现了 Jev 风格的结构化决策。
快速上手:三步部署
按项目 README,部署分三步:把模型权重上传到 GCS 存储桶;执行一条 gcloud 命令,挂载预构建镜像和存储桶,分配一块 RTX PRO 6000 Blackwell GPU,并把最小实例数设为零——空闲时不保留任何实例;随后向端点发送 Jev 风格的请求即可验证。完整命令与参数见 djev-run 仓库。
GPU 按需启动,项目自述繁忙时约每小时 3.19 美元,空闲时不收费。代价是冷启动:项目自述首次拉起约需 47.5 秒,不适合需要常驻低延迟的场景。服务端中位响应为 61 毫秒,JevBench 基准准确率约 81.4%——这些数字均为项目自述,目前没有第三方复测。
推荐不等于出品,数字也分两个口径
出品方是社区开发者:官方帖跟帖把 djev 和部署方案的功劳归于 mmastrac 与 Daniel Lee,Google 的角色止于发布底层的 DiffusionGemma 权重,再由官方账号下场推荐。性能数字也分口径:35–60 毫秒与 100–123 请求/秒出自官方账号的帖子,61 毫秒与 47.5 秒出自项目 README,两组指标不同,目前都没有独立测试佐证。
想用 Jev 式决策能力又不愿订阅商业 API 的团队,成本从此可以按需计费。而 TypeSafe AI 的接口定义,如今有了一个跑在开放权重上的免费实现,它刚经由 Google 官方账号获得约 20 万次浏览。模型发布三个月后,社区就交付了可一键部署的决策 API 实现——扩散模型整张画布一次去噪的特性,与决策 API 只要概率不要长文的需求,恰好咬合。至于这类实现能否在准确率上追平商业版 Jev,目前没有任何对照数据。
 AI 速览