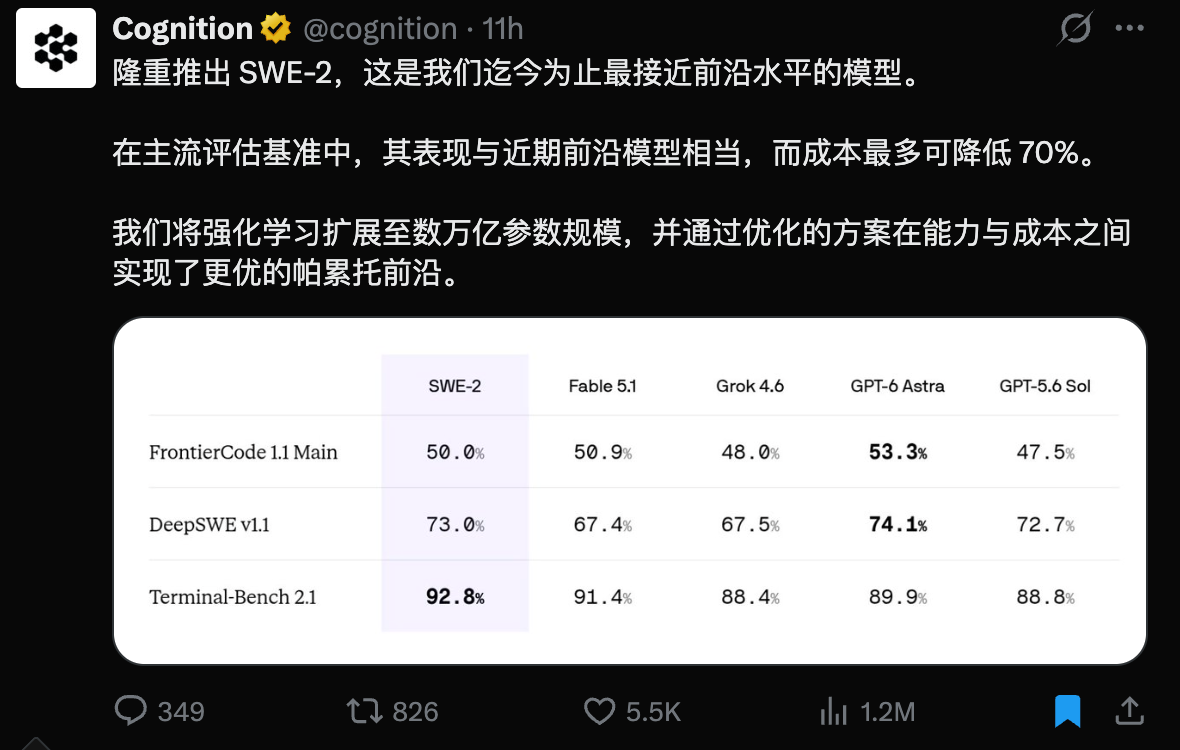
9月11日消息,Cognition 发布编码模型 SWE-2,官方称其在自研基准 FrontierCode 1.1 Main 上得分 50.0%,与 Fable 5.1 的 50.9% 相差不到 1 个百分点,平均 rollout 成本低 64%。这次训练的核心改动是让所有推理档位在同一次强化学习运行里训完,Cognition 称由此把整条成本与性能的曲线一起上推,而不是只改善其中一个点。所有分数都出自 Cognition 自研基准且尚无独立复核,模型也没有公开权重与独立 API。
SWE-2 的做法是不重训基座。Cognition 在官方博客中说明,模型后训练自 Moonshot AI 的 Kimi K3,一个 2.8 万亿参数的模型,并称这是公司首次把强化学习扩到数万亿参数规模,基座参数约为 SWE-1.7 的 2.8 到 3 倍。Kimi K3 此前已针对智能体编码做过大量强化学习,Cognition 称自己的强化学习在其上仍找到 5 到 6 个百分点的提升空间。 分数领先出现在旧基准,长周期任务落后约 28 个百分点
FrontierCode 是 Cognition 自建的编码基准,判断依据是 AI 生成的改动能否被开源仓库的人类维护者合并,出题、榜单维护与判分都在公司内部。在这张表里,SWE-2 落后 GPT-6 Astra(53.3%),高于 Grok 4.6(48.0%)和 GPT-5.6 Sol(47.5%),把上一代 SWE-1.7 的 42.0% 拉开 8 个百分点。 另外两个基准上 SWE-2 的分数也高于或接近对照模型。Terminal-Bench 2.1 上 SWE-2 得 92.8%,是表内最高分,高于 Fable 5.1 的 91.4% 和 GPT-6 Astra 的 89.9%;DeepSWE 1.1 上得 73.0%,接近 GPT-6 Astra 的 74.1%,高于 Fable 5.1 的 67.4%。
落后出现在更新的那一版基准上。Terminal-Bench 4 上 SWE-2 得 27.3%,Fable 5.1 为 55.8%,GPT-6 Astra 为 57.9%。Terminal-Bench 4 是当前版本,2.1 已被取代。
这些数字放在一起指向一个更具体的问题。相对基座 Kimi K3,SWE-2 在四个基准上的提升分别是 5.8、4.5、4.5 和 5.8 个百分点,都落在 4.5 到 5.8 之间。这次后训练抬的是整体水平,没有改变模型相对基座的能力形状:基座强的地方 SWE-2 强出大约 5 分,基座弱的地方也是大约 5 分,长周期任务上的差距因此保留下来。
基准的比较口径需要和分数一起读。据 Cognition 的评测方法说明,每个模型优先采用可得的公开成绩,其余在其原生框架中评测,Anthropic 的模型用 Claude Code,OpenAI 的用 Codex,xAI 的用 Grok Build,开放权重模型用 Devin CLI,每个模型取各推理档位中的最高分。两项说明分别出现在评测章节与附录里,它们也意味着同表分数不宜横向相减:执行框架并不相同。 便宜 64% 是自家基准上的任务成本,medium 档省在轮次
这组数字的比较单位需要写清楚。Cognition 的 64% 指的是 FrontierCode 1.1 Main 上平均每次 rollout 花的钱,比 Fable 5.1 少 64%,其中包含模型、执行框架与服务成本。SWE-2 没有独立 API,也没有按 Token 计价的价目,这个数字无法与别家厂商的 Token 单价比较。部分报道取"最多低 70%"的说法,那是这一系列对比中的最高值,官方博客给出的口径是 64%。
效率数字对应使用者能感知的部分。Cognition 称 SWE-2 的 medium 档在 FrontierCode 1.1 Main 上分数高于 SWE-1.7,同时轮次少 58%、平均成本低 81%。上一代模型被用户反馈在简单任务上过度探索,这一次平均每次运行步数从 SWE-1.7 的 127 步降到 medium 档的 53 步,high 档 80 步,max 档 98 步,首次实质代码编辑的中位步数从第 48 步提前到第 18 步。官方把档位分工描述为 medium 更快进入执行,high 与 max 在复杂任务上多做规划、扩大代码库探索范围并处理更多不确定性。
单次 RL 训完所有档位,惩罚系数对齐基座曲线斜率
方法层面的新东西集中在训练目标上。此前训练多个推理档位的常见做法是为每种组合单独训一个专家再合并,Kimi K3 采用的正是按领域与档位组合分别训练专家、再用多教师同策略蒸馏合并的路线。Cognition 改为在单次强化学习运行中把所有档位一起训完。
做法是对奖励施加按档位区分的成本惩罚,形式为 R = S − λeC:S 表示这次 rollout 是否成功,C 是 rollout 成本,包含推理费用与耗时,λe 是每个档位对应的惩罚系数。关键在于 λe 的取值方式,Cognition 把它设为基座模型在该档位点上成本与性能曲线的局部斜率,理由是当等奖励线与曲线相切时,提升奖励才会同时抬高整条曲线,惩罚过重则会让高档位模型退化成低档位行为,成本下降但能力跟着掉。
Cognition 在附录中给出推导,说明如果希望训练目标只依赖平均成本与平均成功率,而不受 rollout 分布形状影响,奖励对成本就必须是线性的。
配套改动包括把强化学习环境数量增至 3 倍、加入指令遵循数据、用 SWE-2 的早期检查点迭代加固自动验证器,以应对更强基座带来的奖励攻击。推理侧使用 NVFP4 与 FP8 内核配合量化感知训练,训练在线草稿模型把投机解码的接受长度提高 15%,并加入预填充延迟器换取单 GPU 吞吐提升 10% 到 20%。
权重不公开,目前只在 Devin 内可用
SWE-2 即日起在 Devin Desktop 与 CLI 上线,并在 Devin Web 与 Fusion 推送。权重不公开,也没有独立 API,想在 Devin 之外调用这个模型目前没有通道。
Cognition 同日更新了模型信任度评估。在 145 道政治敏感话题的评估中,SWE-2 总体通过率 98.0%,英文 99.8%、简体中文 95.2%、繁体中文 99.1%;在代码漏洞的客户身份与语言框定测试中,没有任何框定条件造成统计显著的漏洞差异。两项评估由 Cognition 自建,判分模型分别为 GPT-5.6 Luna 与 GPT-5.6 Sol-high。
与 SWE-2 发布同一天,Rust 跨平台应用框架 Dioxus 的团队宣布加入 Cognition,参与加速 Devin 的开发,同时承诺继续开发并维护 Dioxus、Blitz、Taffy 与 Subsecond。据 Dioxus 官方博客,Devin CLI 的终端渲染器就是用 Dioxus 构建的,团队由此受邀到 Cognition 演示并最终加入。Dioxus 在 GitHub 上有 24.5k 星,团队此前累计融资 350 万美元,Blitz 的主力工程师 Nico Burns 全职负责维护与改进,官方称加入之后 Blitz、Taffy 与 Parley 的开发在加速。
这两件事放在一起可以看到 Cognition 在补 Devin 这条产品线的两端:模型端用一次强化学习把成本与性能的曲线整体上推,客户端与运行时端把已经在自家产品里使用的框架团队收进来。
对 Devin 用户省在步数,在 Devin 之外无法验证
这些事实指向的结论具体。SWE-2 的省钱来自更少的绕路,而不是更小的模型:它后训练自一个 2.8 万亿参数的基座,成本作为惩罚项写进了强化学习的奖励,换来的结果是 medium 档用不到一半的步数拿到高于上一代的分数。对已经为 Devin 付费的团队,这落在账单上;对想在 Devin 之外调用的开发者,这次发布不提供选项。
分数的性质同样需要说明。基准、判分、成本口径都出自 Cognition,目前没有第三方复现,也没有按 Token 计价的价格可用于横向比较。相对基座约 5 个百分点的提升在表内四项基准上一致,这让它更像一次可预期的水平抬升。
 AI 速览