- 官方文档写明上下文窗口 512K、最大输出 65,536 tokens,输入支持文本与图像 URL,输出为文本;Artificial Analysis 的模型页按 1M 上下文统计,两处口径不同。
- 价格分两栏:刊例价输入 0.05、输出0.05、输出0.15、缓存命中 0.005(每百万token),现价三项均为0.005(每百万token),现价三项均为0。
- Artificial Analysis Intelligence Index v4.3 给出 36 分,与 DeepSeek V4 Pro 0813 的 36.28 分接近,但该分数标注为估算,独立评测仍在进行。
- 免费账号的文本模型实际执行 20 RPM,只适合调试与轻量调用;社区反馈里吐槽集中在代码生成能力,认可集中在免费与多模态。
- Hugging Face 上的 Agnes-3.0-Flash Preview 是 33B、262K 上下文的开放权重检查点,官方已明确它与 API 生产版是两个模型,榜单成绩不能互相套用。
Agnes 3.0 Flash 是什么,什么时候上线的
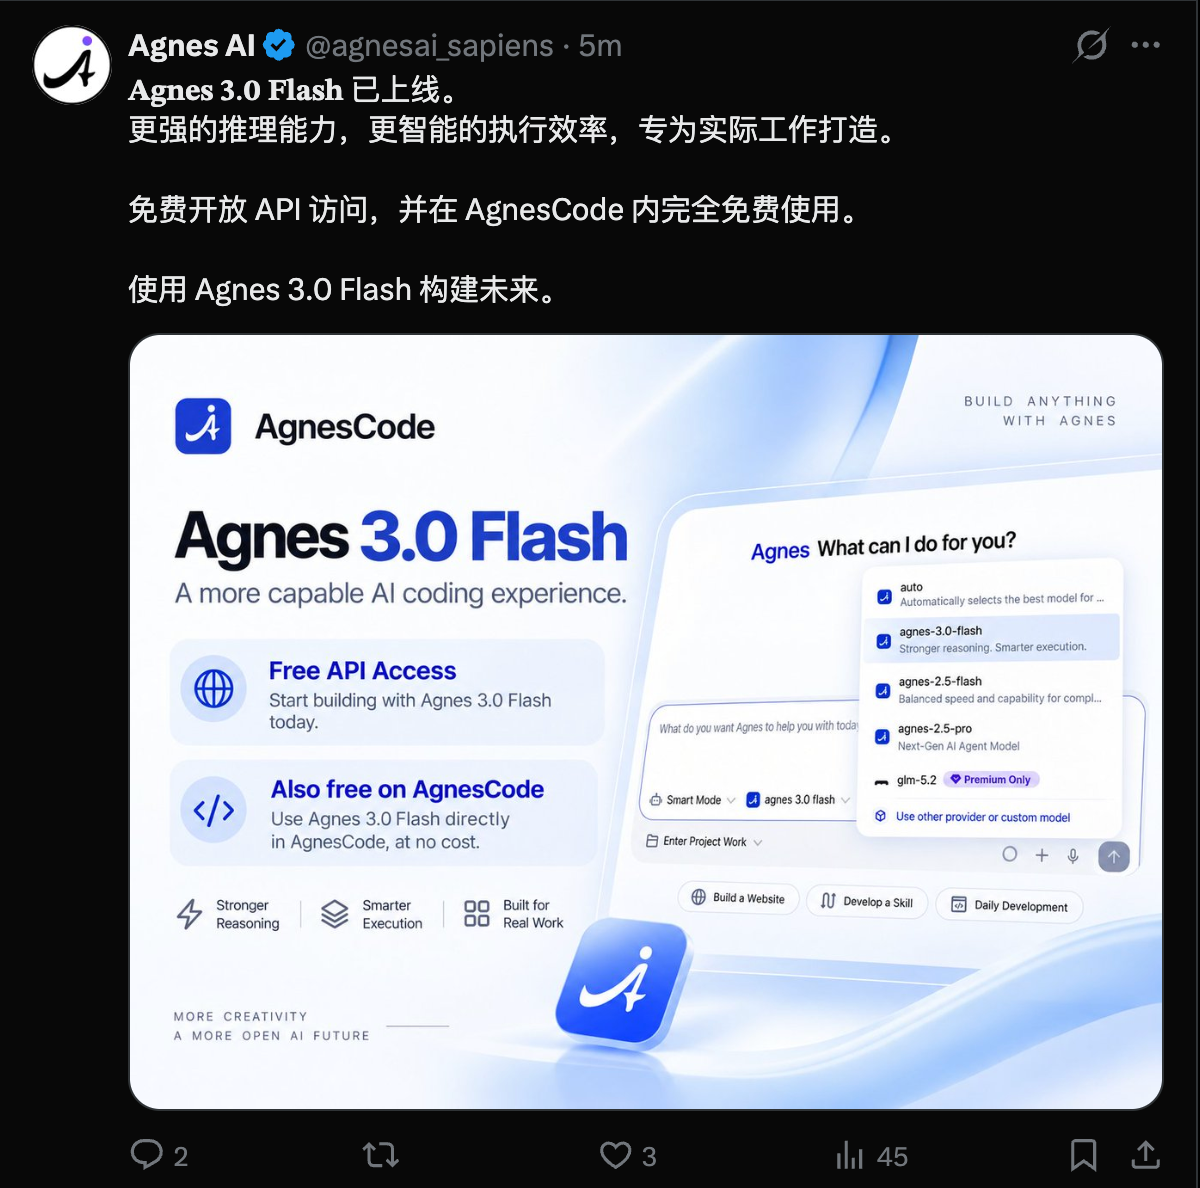
Agnes AI 是新加坡公司 Sapiens AI 的商业品牌。Agnes 3.0 Flash 面向 Agent 编程与工具驱动任务,官方文档把定位写成四件事:Agnes Code 任务执行、工具调用与编排、指令与上下文遵循、可信交付。落到功能上,就是长任务里少跑偏、少重复调工具、少在任务没做完时报告完成。 可核到的时间节点有三个。Hugging Face 仓库创建于 2026 年 9 月 11 日 15:50 UTC;同一天官方文档更新 Artificial Analysis 榜单成绩,标注日期 2026 年 9 月 11 日;模型卡在 9 月 12 日补充说明,把开放权重版本正式改名为 Preview。官方 X 账号同步发布了上线消息与免费策略。
能力边界在文档里写得很直白:输入接受文本和图像 URL,输出只有文本。它不生成图片,也不生成视频。需要图片或视频,走同一套账号下的 Agnes Image 与 Agnes Video 系列模型。这种分工意味着它更适合放进已有的 Agent 流程当执行内核,而不是当作全能的多模态工作台。
工具调用、Thinking 模式与榜单成绩
工具调用是这代模型的重点。请求体里传 tools 数组,模型返回 choices[].message.tool_calls,应用侧执行函数后再把结果追加回 messages,发起下一轮请求。文档给的建议是工具描述与 JSON Schema 保持精确、聚焦,有副作用的操作在应用侧先校验参数。这个流程和 OpenAI 的 function calling 一致,已有的工具层基本不用重写。
Thinking 模式在两个协议下分别开启。OpenAI 兼容格式用 chat_template_kwargs 里的 enable_thinking,Anthropic 兼容格式用 thinking.enabled 加 budget_tokens。需要拆解复杂任务或做多步推理时再打开,日常问答保持关闭可以省掉一部分等待时间。
榜单成绩来自 Artificial Analysis。模型页显示 Intelligence Index v4.3 为 36 分,同类模型智能指数排名 1/61,输出速度中位数 232 tokens/s。同榜的 DeepSeek V4 Pro 0813(max)为 36.28 分,Agnes 官方文档引用的输出速度数字是 252.7 tokens/s。三个数字取自不同时点,趋势一致:分数进入第一梯队,速度明显快于同档模型。
这 36 分带估算标记。Agnes AI 自己的文档也写明,Artificial Analysis 的独立评测仍在进行,榜单分数、排名与方法可能随评测更新变化。把估算值当作已经定论的成绩,容易在复现时产生落差。
用起来要注意什么:社区反馈与真实限制
社区口碑与榜单分数存在落差。技术论坛上有开发者用了一周后给出的判断是「和现在的主流模型相比还是弱一些」,另一条评论写「最基本的 curd 都写不了」,还有人总结为干小活可以、定时整理文件这类自动化可以、写代码基本不行。正面评价同样具体:免费、稳定、多模态能看图,适合薅额度做轻量任务。这些是单个论坛帖的样本,不构成评测,但方向值得留意。
反馈集中攻击的 Agent 编程,恰恰是官方宣传的重点。榜单分数衡量的是综合题目表现,不能换算成仓库级改代码的成功率。任务涉及多文件重构或复杂业务逻辑时,先用同一个任务在两个模型上跑一遍再决定,比直接迁移省钱。
免费额度是另一个容易踩的点。官方 Token Plan 文档列出三档访问类型:免费/默认用户文本模型实际执行 20 RPM,企业认证用户 40 RPM,Token Plan 用户 1000 RPM。免费账号没有周期性总配额,但 20 RPM 意味着并发高一点就会收到 429。图片模型 2K 档位免费用户实际 10 RPM,视频模型只有 1 RPM。
上下文口径的分歧也要记住。官方文档写 512K,Artificial Analysis 的模型页按 1M 上下文统计,Hugging Face 模型卡写生产版是 1M。写代码时不要按上限做硬编码假设,先按 512K 规划,再根据实际返回的错误调整。
上下文回滚在这家公司有过先例。社区技术文档记录,Agnes-2.0-Flash 曾提供 1M 上下文,后因稳定性问题回滚到 256K。这条历史对生产环境的意义是:把上下文长度当作会变动的配置项,不要写死在业务逻辑里。
三条接入路径:AgnesCode、OpenAI SDK 与 CLI 客户端
路径一,直接用 AgnesCode。这是 Agnes AI 的桌面工作台,3.0 Flash 已内置,官方宣传口径是在工作台内免费使用,不需要自己配 Key。下载安装包解压后运行可执行文件即可,macOS 用户如果启动后没有窗口,检查 ~/.config 目录是否可读写,AgnesCode 需要这个权限来创建日志目录。
路径二,用 OpenAI SDK 改 Base URL。Python 的最小写法是这样:
curl 版本把同样的三段信息放进请求头与请求体:
路径三,接入 CLI 编程客户端。AgnesCode 的 provider 文档里没有单独的 Agnes 条目,走的是自定义 OpenAI 兼容端点这条路:把 OPENAI_HOST 设为 https://apihub.agnes-ai.com,OPENAI_BASE_PATH 设为 v1/chat/completions,OPENAI_API_KEY 填 Agnes 的 Key。返回 404 通常说明 OPENAI_BASE_PATH 写错,401 说明 Key 没有正确加载。 接入前先做对的四件事
先分清 API 生产版和开源 Preview。Hugging Face 上的 Agnes-3.0-Flash Preview 是 33B 参数、262K 上下文、Apache 2.0 许可的开放权重检查点,支持文本、图像和视频理解,和 API 版用的是不同检查点与配置。官方模型卡写明,Preview 的榜单成绩不能归于生产版,反过来也一样。想本地跑,bf16 权重约 66 GB,推荐单卡 H100 80GB 或 H200 141GB。
再测最小请求,然后才谈集成。拿一个纯文本请求确认 Key、Base URL、模型名三件事都对,再去接工具调用。文档列出的错误码里,400 多是字段或参数类型问题,401 是鉴权,404 是路径或模型名,429 是限流,5xx 用 1s→2s→4s→8s 的指数退避重试。
调用节奏要按免费额度设计。20 RPM 的免费池不适合压测和批处理,重试逻辑要做,但别用紧密轮询。需要更高吞吐,Token Plan 的 Starter 档给出每 5 小时 1,500 次、每周 15,000 次的配额。
把价格变动当变量。刊例价三项现价都是 0,官方没有给免费期截止日期,文档口径是阶段性优惠的结束时间以平台公告和账户账单为准。按刊例价做成本模型,比按0,官方没有给免费期截止日期,文档口径是阶段性优惠的结束时间以平台公告和账户账单为准。按刊例价做成本模型,比按0 做更安全。等免费期结束才第一次算账的团队,会是最后知道这件事的那批人。
 AI 速览