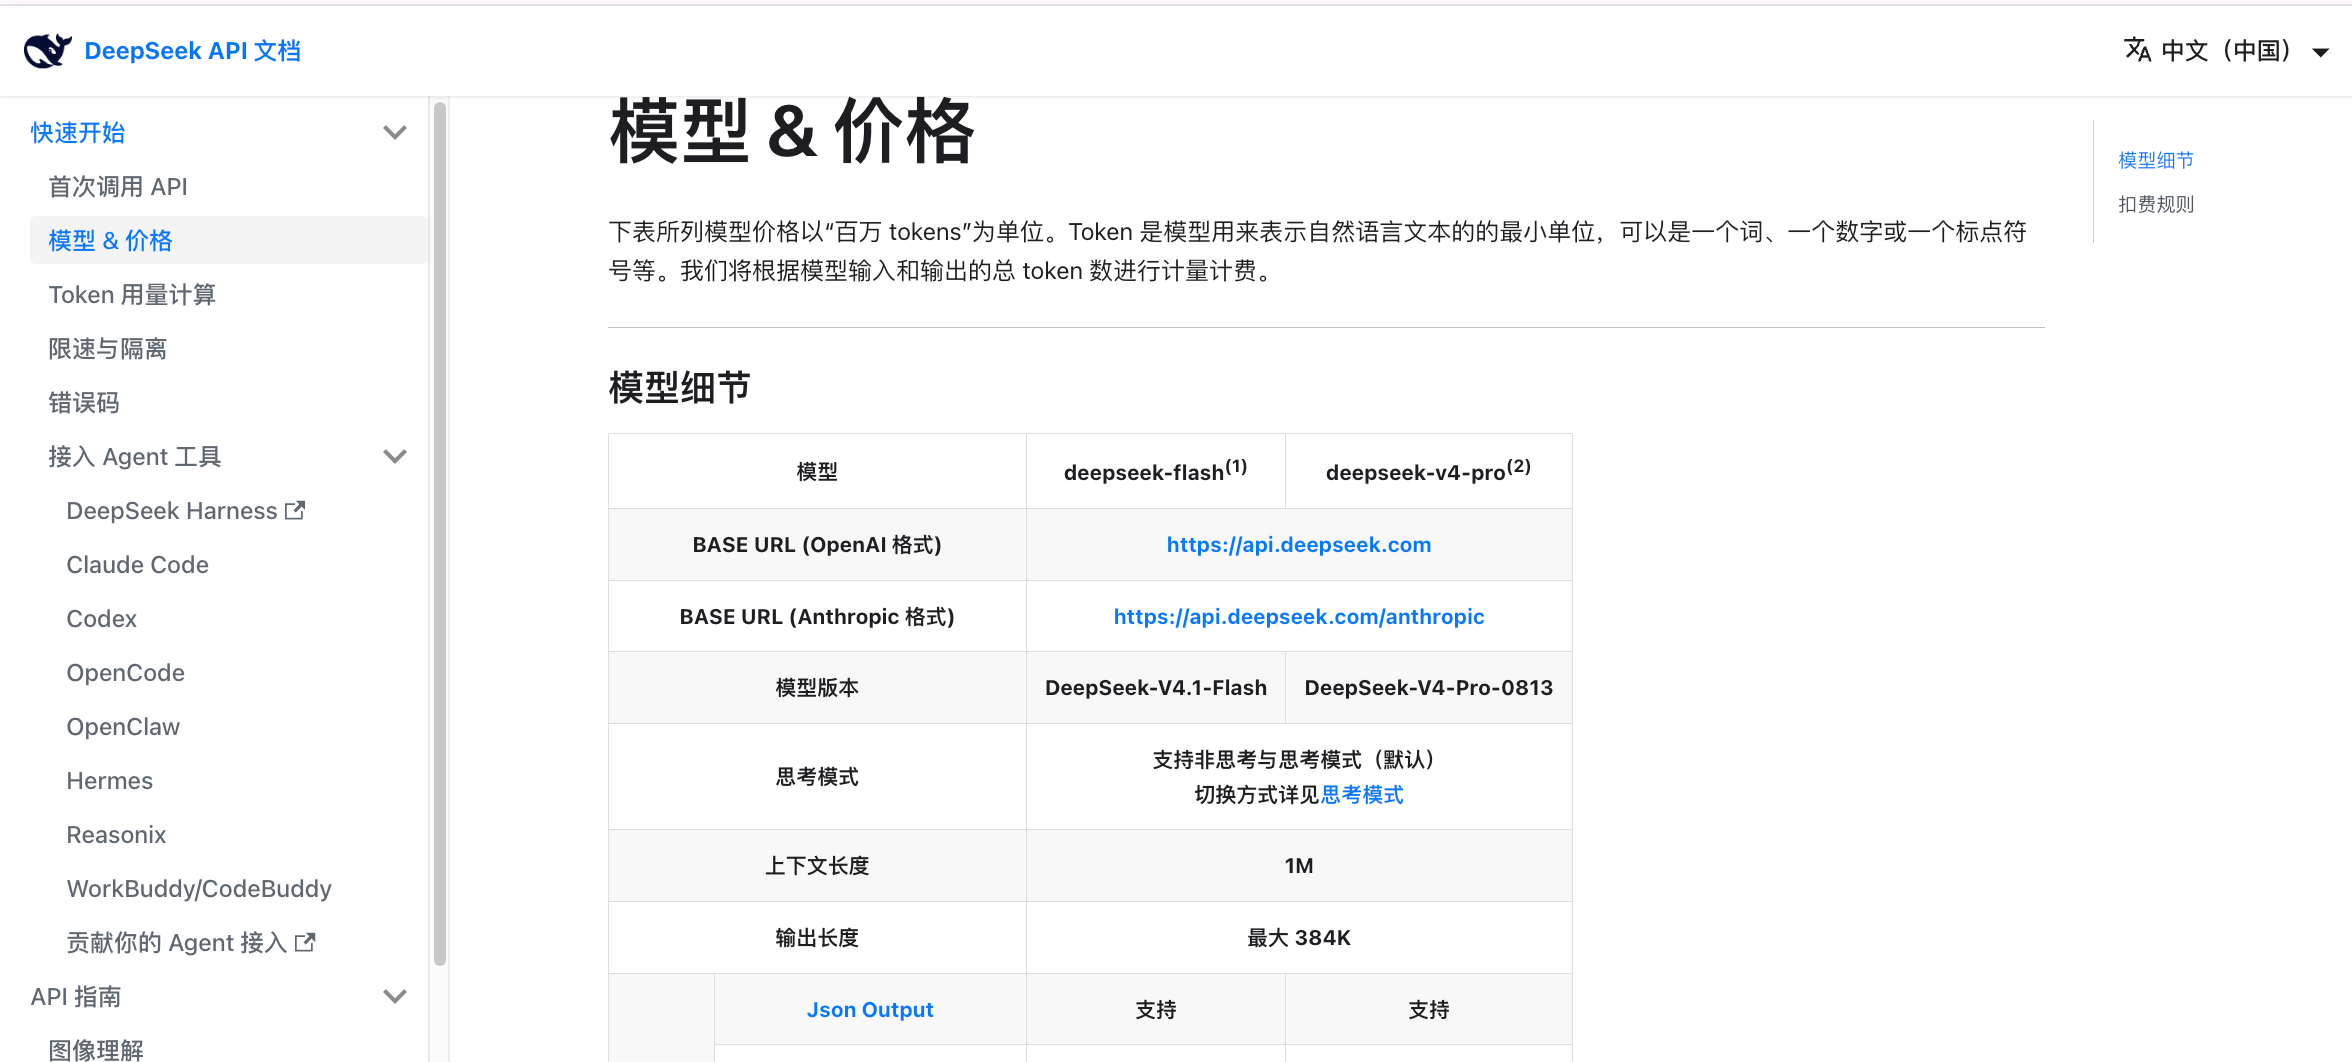
DeepSeek 的 token 上限不止一个数。按官方文档核对,单次请求的上下文总长度是 1M、单次输出最大 384K(393216)、并发上限是 deepseek-flash 2500 与 deepseek-v4-pro 500;而未设置 max_tokens 时的输出默认值是 8K、64K、128K 三档。本文把这五类上限值、三个默认值和四种撞到上限后的表现逐项列出来,并附官方自查方式。 DeepSeek token 上限分哪几层
搜索“DeepSeek token 上限是多少”的人,想要的多半是一个数字。但把官方文档读完后会发现,这个问题至少有五层答案,而且它们互相之间并不换算。
第一层是单次请求的上下文总长度,官方《模型 & 价格》页写作“上下文长度 1M”,官方模型卡英文表述为 support for contexts of up to one million tokens。第二层是单次输出的最大 token 数,也就是 max_tokens 参数的取值范围上限,官方写作“1 到 384K(393216)”。第三层是并发数,官方写作 deepseek-flash 2500、deepseek-v4-pro 500,且明确“一个请求从发出后,到模型响应完成之前记为一个并发”。第四层是单张图片折算出的 token 上限。第五层是文件与存储配额,只在 Files API 文档里出现。
这五层的关键差别在于:前两层都以 token 为单位,但不是两份额度——官方 API 参考原文写着“输入 token 和输出 token 的总长度受模型的上下文长度的限制”,也就是说 1M 是输入与输出合起来用的一个池子。第三层的 429 与 token 数量没有直接关系,只与同时在跑的请求数有关。第四、五层则分别在图片和文件这两个入口上单独设限。
5类上限值逐项对照
下表把五类上限的官方数值与出处并列,最后一列是“哪些使用场景会真的撞到它”:
| | | |
|---|
| | | |
| | API 参考 create-chat-completion | |
| | | |
| | | |
| 单文件 64 MiB、总 25 GiB、最多 10000 个 | | |
需要单独说明的是第一行的口径精度。官方在模型卡里写的是“one million tokens”,即 100 万 tokens,文档中没有给出精确到个位的数字;本文也不把第三方流传的 1,048,576 当作官方值使用。相对地,第二行的 384K 是官方唯一给出了括号精确值的上限——393216。
上下文1M与输出384K怎么共用
把“1M 上下文”理解成一个可以装满的桶,再理解“384K 输出”是这个桶的一个出水口,两句话都成立,但顺序不能倒。
官方 API 参考的原文是“输入 token 和输出 token 的总长度受模型的上下文长度的限制”。这意味着:如果你一次把接近 1M 的资料全部作为输入发过去,留给输出的空间就被压到很小;反过来,只要输入控制在合理范围,输出就可以一路用到 384K。这也是为什么“我有 1M 上下文”和“我能生成 100 万字”是两件事。
另一条容易被忽略的机制是服务端不保存历史。官方《多轮对话》指南开篇写得很直接:/chat/completions API 是一个“无状态” API,即服务端不记录用户请求的上下文,用户在每次请求时,需将之前所有对话历史拼接好后,传递给对话 API。所以多轮对话里的上下文是逐轮累加的,第 N 轮要重发的历史比第 1 轮长得多,这也是长会话最先撞上限的原因。
在思考模式下还有一处额外消耗:官方《思考模式》文档写明,思维链内容通过 reasoning_content 返回,而它“是否需要回传、是否会被拼接进上下文,取决于请求是否携带 tools 参数”——若请求携带 tools 参数,历史轮次的 reasoning_content 均应回传给 API,并会被拼接进上下文;若不携带 tools,则无需回传、传了也会被忽略。做工具调用的长会话,上下文里会持续累积思维链 token。
| | |
|---|
| | |
| | |
| | |
| 携带 tools 时历史 reasoning_content 会进上下文 | |
| | |
输出长度的3个默认值
很多人不知道自己其实设了一个输出上限——因为没传 max_tokens 时,服务端会替你定一个。官方 API 参考的原文是:未设置时,非思考模式默认 8K,思考模式默认 64K(reasoning_effort 为 max 时为 128K)。
三个默认值的排列本身就是一条可用规则:思考模式越强,默认留给回答的空间越大。原因是思维链本身也消耗输出 token,如果默认值不动,思考档位越高,实际能写进正文的字就越少。官方在 usage 返回里单独给了 completion_tokens_details.reasoning_tokens 字段,描述为“推理模型所产生的思维链 token 数量”,正是用来观察这一项的。
| |
|---|
| |
| |
思考模式且 reasoning_effort 为 max | |
| |
补充一个精度上的细节:官方只给 384K 配了括号精确值,三个默认值一律用“K”表述,没有给出换算成个位的数字。本文不替官方把它换成 8192 或 65536,需要精确值时请在请求里显式指定 max_tokens。
并发上限与429的两套口径
这是本篇最需要交代清楚的一处:官方文档对“什么情况下会收到 429”,在两个页面给出了两套表述。
| | |
|---|
| “对于一个账号,在并发限度内,您的 API 请求都会得到响应;超过并发限度时,您会收到 HTTP 429 错误码” | |
| | |
两句话指向的东西不同:一个是“同时在跑的请求数”,一个是“单位时间内的吞吐量”。官方在《限速与隔离》全页只公布了并发数,没有任何一页给出 TPM 或 RPM 的具体数值。所以遇到 429 时的正确理解是:账号级并发是官方明确公布并可以申请扩容的那一道线;而 TPM/RPM 这一道在官方文档里目前只有名称、没有数字。
配套的两条官方规则也写在同一页:并发限制以账号粒度计、与 API Key 无关;如果确有更高的并发需求,可以提交账号扩容申请工单,官方原文是“我们将根据您实际的业务需求匹配合适的并发量,扩容并不增加额外的费用”。
另外还有一套按用户切分的隔离机制:user_id 参数。对普通 API 用户,所有 user_id 合并计算并发限速;对提升了并发配额的账号,官方会在总并发之外再对每个 user_id 单独限速,每个 user_id 的额度同样是 flash 2500、v4-pro 500,空 id 视为一个特殊的 user_id。该参数须满足正则表达式 [a-zA-Z0-9\-_]+,最大长度 512,官方提醒不要在 user_id 中包含用户隐私信息。
图片与文件也有token上的硬约束
如果只按文本 token 算预算,接入图片后会出现对不上的账。官方《图像理解》页把图片折算规则写得很具体:图片会根据尺寸换算成 token,进入模型前每张图片都会被自动缩放——总像素小于约 544×544 的图片会被保持长宽比放大;更大的图片会被保持长宽比缩小,缩小后的总像素约相当于 1300×1300 的图片。
由此得出一个反直觉但仍成立的结论:每张图片消耗的 token 数存在上限(1024 个)。官方举的例子是“2000×2000 和 5000×5000 的图片,经缩放后消耗的 token 数是相同的”。也就是说,把图片做得更大不会让模型看到更多,只会多花传输和请求体的代价。
| |
|---|
| JPEG、PNG、GIF、WebP(按文件实际内容判断,不按文件名) |
| |
| |
| |
| base64 / 外部 URL 32 MiB;Files API file_id 64 MiB |
| |
| 不含 file_id 最多 64 MiB;包含 file_id 最高 200 MiB |
| 单边最长 8192 像素;单请求含 15 张及以上时降为 4096 像素 |
| 64 MiB / 25 GiB / 10000 个 |
| |
| 1 小时到 30 天;不传 expires_after 则永久有效 |
最后一行里那条“15 张及以上,单边降为 4096 像素”容易被忽略,但它是决定批量图片任务能不能跑通的直接原因:图片数量一旦上去,单张允许的边长会被砍半,原本够用的图需要先自行缩放。
自己算token的两种官方方式
官方并没有公布一张“多少字等于多少 token”的固定换算表,而是给了换算比例和一个离线工具。比例来自《Token 用量计算》页:token 是模型用来表示自然语言文本的基本单位,也是计费单元;通常 1 个中文词语、1 个英文单词、1 个数字或 1 个符号计为 1 个 token。一般情况下,1 个英文字符约等于 0.3 个 token,1 个中文字符约等于 0.6 个 token。官方同时注明,“因为不同模型的分词不同,所以换算比例也存在差异,每一次实际处理 token 数量以模型返回为准”。
按这个比例粗算,1M 的上下文约合 167 万个中文字符(100 万 ÷ 0.6)。这是量级参考,不是承诺值。
想要精确值的两种官方路径:一是下载官方文档页提供的 deepseek_tokenizer.zip,在本地运行 tokenizer 离线计算一段文本的 token 用量;二是对图片使用官方文档页的图片 Token 计算器,输入宽度和高度即可估算。官方对计算器结果也做了限定——“此处为估算值,实际处理时转换得到的 token 数量可能存在一定误差,请以接口返回的用量为准”。
线上核对则看接口返回的 usage 字段,官方把口径写得很清楚:prompt_tokens 是用户 prompt 包含的 token 数,且“该值等于 prompt_cache_hit_tokens + prompt_cache_miss_tokens”;completion_tokens 是模型生成产生的 token 数;total_tokens 是“该请求中,所有 token 的数量(prompt + completion)”。命中与未命中被拆成两个字段,是因为它们的单价差得很远——以 deepseek-flash 空闲时段为例,缓存命中 0.02 元与未命中 1 元的单价相差 50 倍。
4种超限信号与排查方向
撞到上限时,官方文档里一共出现过四种可以观察到的信号。它们长得不一样,处置方向也完全不同。
| | |
|---|
| 输出长度达到了模型上下文长度限制,或达到了 max_tokens 的限制 | 先看是 max_tokens 设小了,还是历史拼接把上下文顶满了 |
| 《限速与隔离》写“超过并发限度”;《错误码》写“请求速率(TPM 或 RPM)达到上限” | 先降同时发出的请求数,而不是降单次 token 量 |
finish_reason = "insufficient_system_resource" | | 这是服务端资源侧的信号,与你的 token 设置无关,稍后重试或换模型 |
| 图片仅支持出现在 user 消息中;system 或 assistant 消息携带图片会返回 400 | |
另外要说明一条否定性结论:官方《错误码》页共收录 7 个码(400 格式错误、401 认证失败、402 余额不足、422 参数错误、429 请求速率达到上限、500 服务器故障、503 服务器繁忙),里面没有任何一个专门对应“上下文超限”。按该页的分类,超出 max_tokens 取值范围属于参数问题、应落到 400 或 422 这一类——这是依据官方分类做的推断,官方并未就“上下文超限”单独给出报错示例。同一页对 500 与 503 的官方处置都是“等待后重试 / 稍后重试”,与上限无关。
还有一处官方未覆盖的地方:网页端与 App 端的 token 上限,官方从未公布过。官方帮助中心全库共 45 条问答,逐条读完没有一条讲 Token 上限或字数上限;唯一相关的是“历史对话内容无法加载”一条,建议“若当前对话上下文较长,建议尝试切换到网页端或性能更强的设备查看”。关于网页端图片上传失败,官方也只列了四种可能原因(格式不支持、未检测到可提取文字、图片大小超过允许的上传限制、内容不符合平台使用规范),没有给出任何具体数值。
撞到上限前的注意事项
- 1M 是输入与输出的合计池,不是两份额度。官方原文为“输入 token 和输出 token 的总长度受模型的上下文长度的限制”,只按输入估算会高估可用空间。
- 不设 max_tokens 不等于不设上限。官方默认值是 8K、64K、128K 三档,想写长文必须显式指定。
- 429 先查并发,不要先怀疑 token 太多。官方公布的唯一数值是并发数;账号级并发、与 API Key 无关。
- 图片放大无法换来更多 token。单张图片 token 上限为 1024,超出部分会在缩放阶段被削掉。
- 图片数量会影响单张允许的边长。单请求含 15 张及以上时,单边上限由 8192 像素降为 4096 像素。
- 别把第三方流传的 TPM / RPM 数值当官方值。官方《限速与隔离》只公布了并发数,未公布 TPM 与 RPM。
- 所有数值都可能随官方更新变动。本文数据取自官方文档站与官方模型卡在 2026 年 9 月 15 日的展示,请以官方页面为准。
风险提示:DeepSeek 官方文档没有公布网页端与 App 端的 Token 上限,也没有公布 TPM / RPM 的具体数值。凡第三方教程给出这两类“具体数字”的,均无法在官方文档中核到出处,做容量规划时不应采信。容量相关的数值请以官方文档站与开放平台用量页的实时显示为准。
DeepSeek token 上限常见问题
Q:DeepSeek 的 token 上限到底是一个还是几个? A:是五类互不换算的上限:上下文 1M、单次输出 384K、并发 2500/500、单张图片 1024 token、Files API 的文件与存储配额。
Q:1M 上下文等于多少字? A:按官方比例(1 个中文字符约 0.6 个 token)粗算约 167 万个中文字符。官方只写作 one million tokens,未给出精确到个位的数字。
Q:不设置 max_tokens 会发生什么? A:服务端按默认值执行——非思考模式 8K,思考模式 64K,思考模式且 reasoning_effort 为 max 时 128K。写长内容请显式指定参数。
Q:为什么输出没写完就停了? A:先看返回里的 finish_reason。若为 length,表示输出长度达到了模型上下文长度限制或 max_tokens 限制,两者要分开排查。
Q:收到 429 是不是因为我单次请求的 token 太多了? A:不是。官方《限速与隔离》把 429 对应到并发超限,并发按账号粒度计、与 API Key 无关;单次 token 量控制在限度内不等于不会 429。
Q:官方公布 TPM 或 RPM 的数值吗? A:没有。《限速与隔离》全页只公布并发数(flash 2500、v4-pro 500),TPM 与 RPM 只在《错误码》页作为 429 的成因出现,未给任何数值。
Q:并发不够可以加钱买更高的档位吗? A:官方帮助中心的原文是“目前我们实行统一的 API 收费标准,暂无分级套餐”,有更高并发需求可提交账号扩容申请工单,官方明确扩容不增加额外费用。
Q:一张图最多占多少 token? A:上限 1024 个。图片进入模型前会被自动缩放,2000×2000 与 5000×5000 的图缩放后消耗的 token 数相同。
Q:怎么核对一次请求实际用了多少 token? A:读接口返回的 usage 字段:prompt_tokens、completion_tokens、total_tokens,其中 prompt_tokens 等于缓存命中与未命中之和;离线估算可用官方 deepseek_tokenizer.zip。
 AI 速览