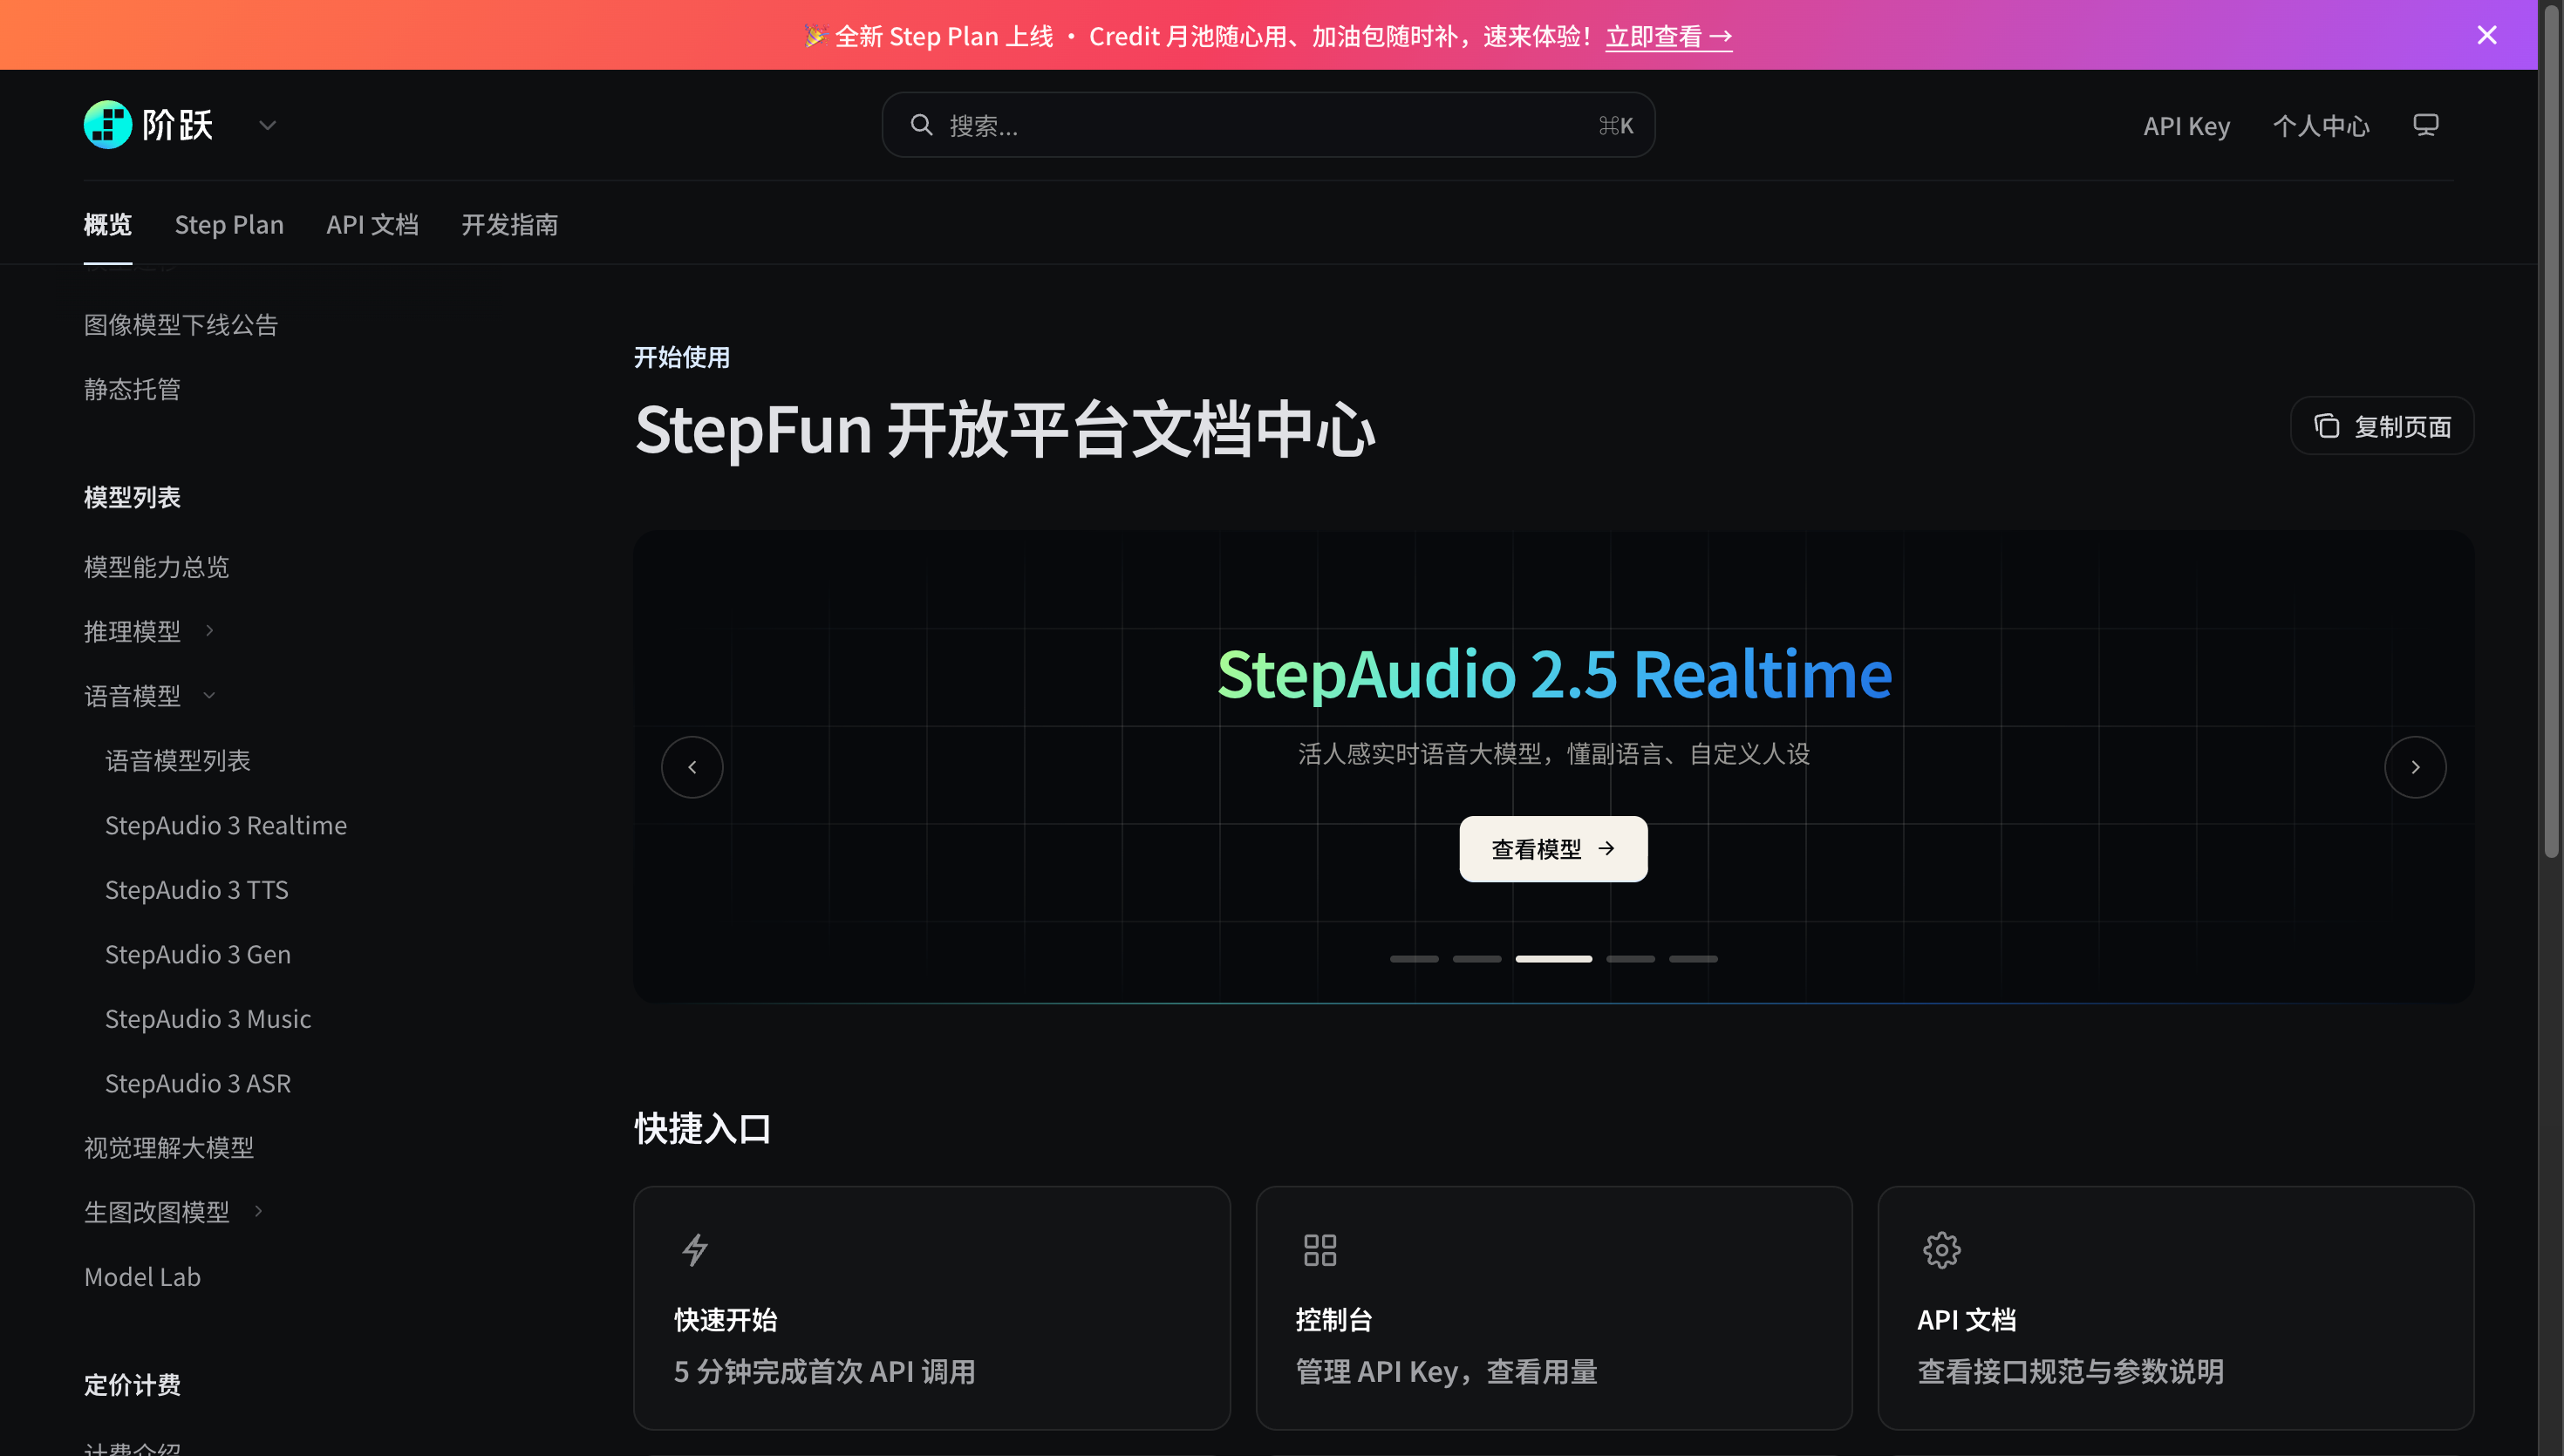
9月15日消息,阶跃星辰在开放平台上线新一代语音模型 StepAudio 3 系列,官方文档中心已列出五款:Realtime、ASR、TTS、Gen 与 Music,分别覆盖实时语音对话、语音识别、语音合成、综合音频生成与音乐生成。TTS 定价 2.5 元/万字符、音色克隆 9.9 元/音色,ASR 的 Max 型号定价 2.8 元/小时;Gen 与 Music 以预览版上线,计费限时免费。
五款模型各自覆盖什么
Realtime 是端到端全双工实时语音对话大模型,官方宣传语为「像真人一样自然地聊」「听懂话,也听懂话外之音」,支持全双工对话与「边想边说」;官方项目页介绍其具备自适应推理与 Agent 能力,官网语音体验中心提供在线体验。
ASR 为新一代语音识别模型,定价页目前可见 Max 型号,价格为 2.8 元/小时。
TTS 主打「真人级的说话表现」,文档称其在音色、语调、节奏和气口停顿上还原真实口语,包括笑声、迟疑、结巴、改口这类副语言特征;采用流式生成架构,可以对接实时对话链路。模型 ID 为 stepaudio-3-tts,计费 2.5 元/万字符,音色克隆 9.9 元/音色。
Gen 面向综合音频内容创作,把人声、音效、环境音与背景音乐统一到一个生成模型:用自然语言描述角色设定、音色风格与情绪,可以生成多角色对白,并按指令编排各声音元素的出现位置与先后顺序。模型 ID 为 stepaudio-3-gen-preview,限时免费,官方注明限免到期后预览版将下线、上线正式付费版本。
Music 是生成式音乐大模型,支持完整歌曲生成、纯音乐生成与干声智能配乐,输入可以是自然语言、歌词、人声或参考音频。官方介绍其采用 StepMusic 架构,通过自研的无监督音乐表征编码器学习旋律、和声、节奏、结构等信息,再由生成与渲染模块完成音频合成。模型 ID 为 stepaudio-3-music-preview,同为限时免费。
定价:核心链路计费,创作类限免
五款的计费策略分成两档。识别与合成这条成熟链路按量计费:TTS 2.5 元/万字符、音色克隆 9.9 元/音色、ASR Max 2.8 元/小时。两个生成类模型 Gen 与 Music 则以限时免费的预览版上线,官方注明限免到期后预览版将下线、新增正式付费版本——正式价格目前未公布。
代际脉络:语音线换代,五款一次补齐
阶跃的语音产品线在一年多里密集迭代。2025年4月,公司发布 Step-1o-Audio,官方称其为国内首个千亿参数端到端语音大模型;随后是 Step-Audio 2;近期集中发布的 StepAudio 2.5 系列覆盖 TTS、ASR、Realtime 三款,其中 2.5 ASR 引入 MTP(多词预测)技术,官方称推理速度提升 400%。到 StepAudio 3 这一代,命名从「Step-Audio」改为连写的「StepAudio」,一次上线五款,把实时对话、识别、合成、综合音频生成与音乐生成收进同一条产品线。
开源侧是另一条线:GitHub 的 stepfun-ai 组织与 HuggingFace 主页目前均无 StepAudio 3 仓库,这一代走平台 API 路线,开源线最新的音频模型仍是 Step-Audio-EditX 与 Step-Audio-R1.1。TTS 与 Gen 已挂出 arXiv 技术报告,Realtime 有独立项目页。对开发者,五款模型的接入方式均为开放平台 API,语音应用的对话、识别、合成可以从同一家拼齐,Gen 与 Music 的限免预览降低了试用门槛。
 AI 速览