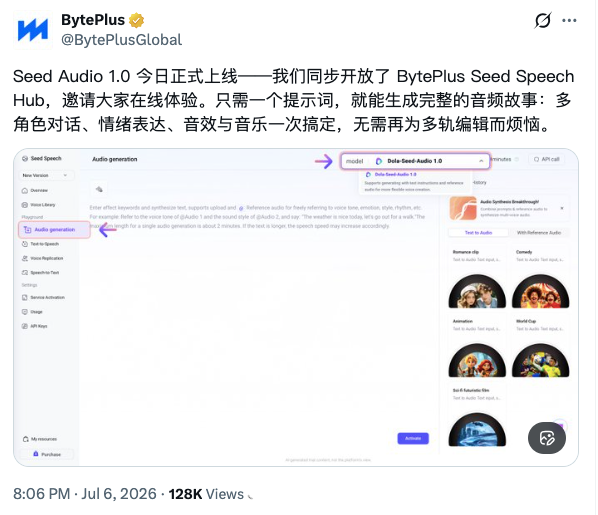
7月7日消息,OpenAI 上线 GPT-Realtime-2.1 及 GPT-Realtime-2.1-mini,为实时语音交互加入推理和工具调用能力,全系列 p95 延迟降低至少 25%。同期,字节跳动的 Seed Audio 1.0 通过BytePlus Seed语音中心向开发者开放,支持从单句文本提示生成包含多角色对话、情感、音效和背景音乐的完整音频场景。结合此前已报道的 Fun-ASR-Realtime 方言识别升级,同一周内 AI 音频的三个方向——识别(音频→文字)、交互(音频↔音频)、生成(文字→音频)——各自进入了新阶段。这三条线面向不同买家、解决不同问题、遵循不同竞争逻辑,"语音 AI"作为一个统一赛道的说法正在失去解释力。
GPT-Realtime-2.1:语音代理开始在对话中思考和行动
GPT-Realtime-2.1 是 OpenAI Realtime API 的最新版本,解决的核心问题是让 AI 代理能与人类实时语音对话,并在对话过程中进行多步推理和调用外部工具。它是端到端的语音到语音模型,不是"语音识别 + 文本 LLM + 语音合成"的拼接方案。
相比上代的核心变化:支持可配置推理强度(reasoning effort 参数),语音代理可以在对话中进行思考;支持工具调用,代理可在对话中触发外部 API;改进了字母数字识别、静音处理和打断行为。全系列通过缓存优化实现 p95 延迟降低至少 25%。
mini 版本为蒸馏推理模型,面向成本敏感场景,定价与上代 GPT-Realtime-mini 持平:文本输入 0.60 美元/百万 Token,音频输入 10 美元,音频输出 20 美元/百万 Token。标准版音频输入 32 美元,输出 64 美元/百万 Token。缓存价格大幅低于首次请求(音频缓存最低 0.30 美元),高频调用场景实际成本远低于列表价。支持 WebRTC、WebSocket 和 SIP 三种连接方式,可直接接入浏览器、服务器端应用和电话系统。
Seed Audio 1.0:一次 API 调用替代四类音频工具
Seed Audio 1.0("豆包-Seed-Audio 1.0")解决的是另一个方向的问题:不是和人对话,而是从一段文字描述直接产出"成品音频"。传统 TTS 只做单人朗读;Seed Audio 1.0 一次性输出包含多角色对话、情感语调、背景音乐和环境音效的完整音频场景,最长两分钟,音色在时间线内保持一致。 该模型于 6 月 23 日在字节跳动火山引擎 FORCE 大会首次披露,随后通过 BytePlus Seed Speech Hub向全球开发者开放 API,定价每分钟生成音频 0.075 美元。支持文本和参考音频两种输入,后者可用于音色克隆。字节跳动计划将其整合进剪映、即梦和番茄等自有产品,定位为创作基础设施层。 此前完成同等效果需要分别使用配音工具、音效素材库、音乐生成器和音频编辑器。Seed Audio 1.0 试图用一次调用替代整条工具链,对有声书、短视频配音、播客自动化和游戏音频场景有直接价值。
识别、交互、生成:三条线的买家和竞争逻辑互不重叠
加上此前已报道的 Fun-ASR-Realtime(30 种语言、16 种方言、87.8% 语义准确率),本周 AI 音频三个方向的格局更加清晰:
Fun-ASR-Realtime 的对手是 Google Cloud Speech-to-Text、AssemblyAI 和 Whisper,竞争武器是方言深度和速度,买家是需要把大量音频变成文字的团队。GPT-Realtime-2.1 的对手是 LiveKit + LLM 拼接方案和语音代理初创公司,竞争武器是延迟加推理的整合,买家是构建语音助手和电话代理的团队。Seed Audio 1.0 的对手是 ElevenLabs、Suno 和传统后期工作流,竞争武器是一次调用出全场景,买家是内容创作者和音频生产管线。 开发者选型的第一步不是比性能参数,而是判断自己的产品属于哪条线。需要听懂用 Fun-ASR,需要对话用 GPT-Realtime,需要批量生产音频内容用 Seed Audio。三条线短期内不会交汇。
各自的验证节点不同
GPT-Realtime-2.1 启用高推理强度时的实际延迟分布尚无独立测试数据。对延迟极度敏感的生产环境能否接受推理带来的额外等待,需要开发者实测。Seed Audio 1.0 的两分钟上限、多角色音色一致性和中英混合表现目前只有 fal.ai 的体验入口,缺乏系统评测;字节何时在国内火山方舟平台正式开放、以何种价格进入中国市场,将决定其实际覆盖范围。更远期的观察点是三条线是否会出现交叉——未来的语音代理是否需要在对话中即时生成复杂音频内容,同时理解用户上传的录音。目前没有一家走到整合这一步。
 AI 速览