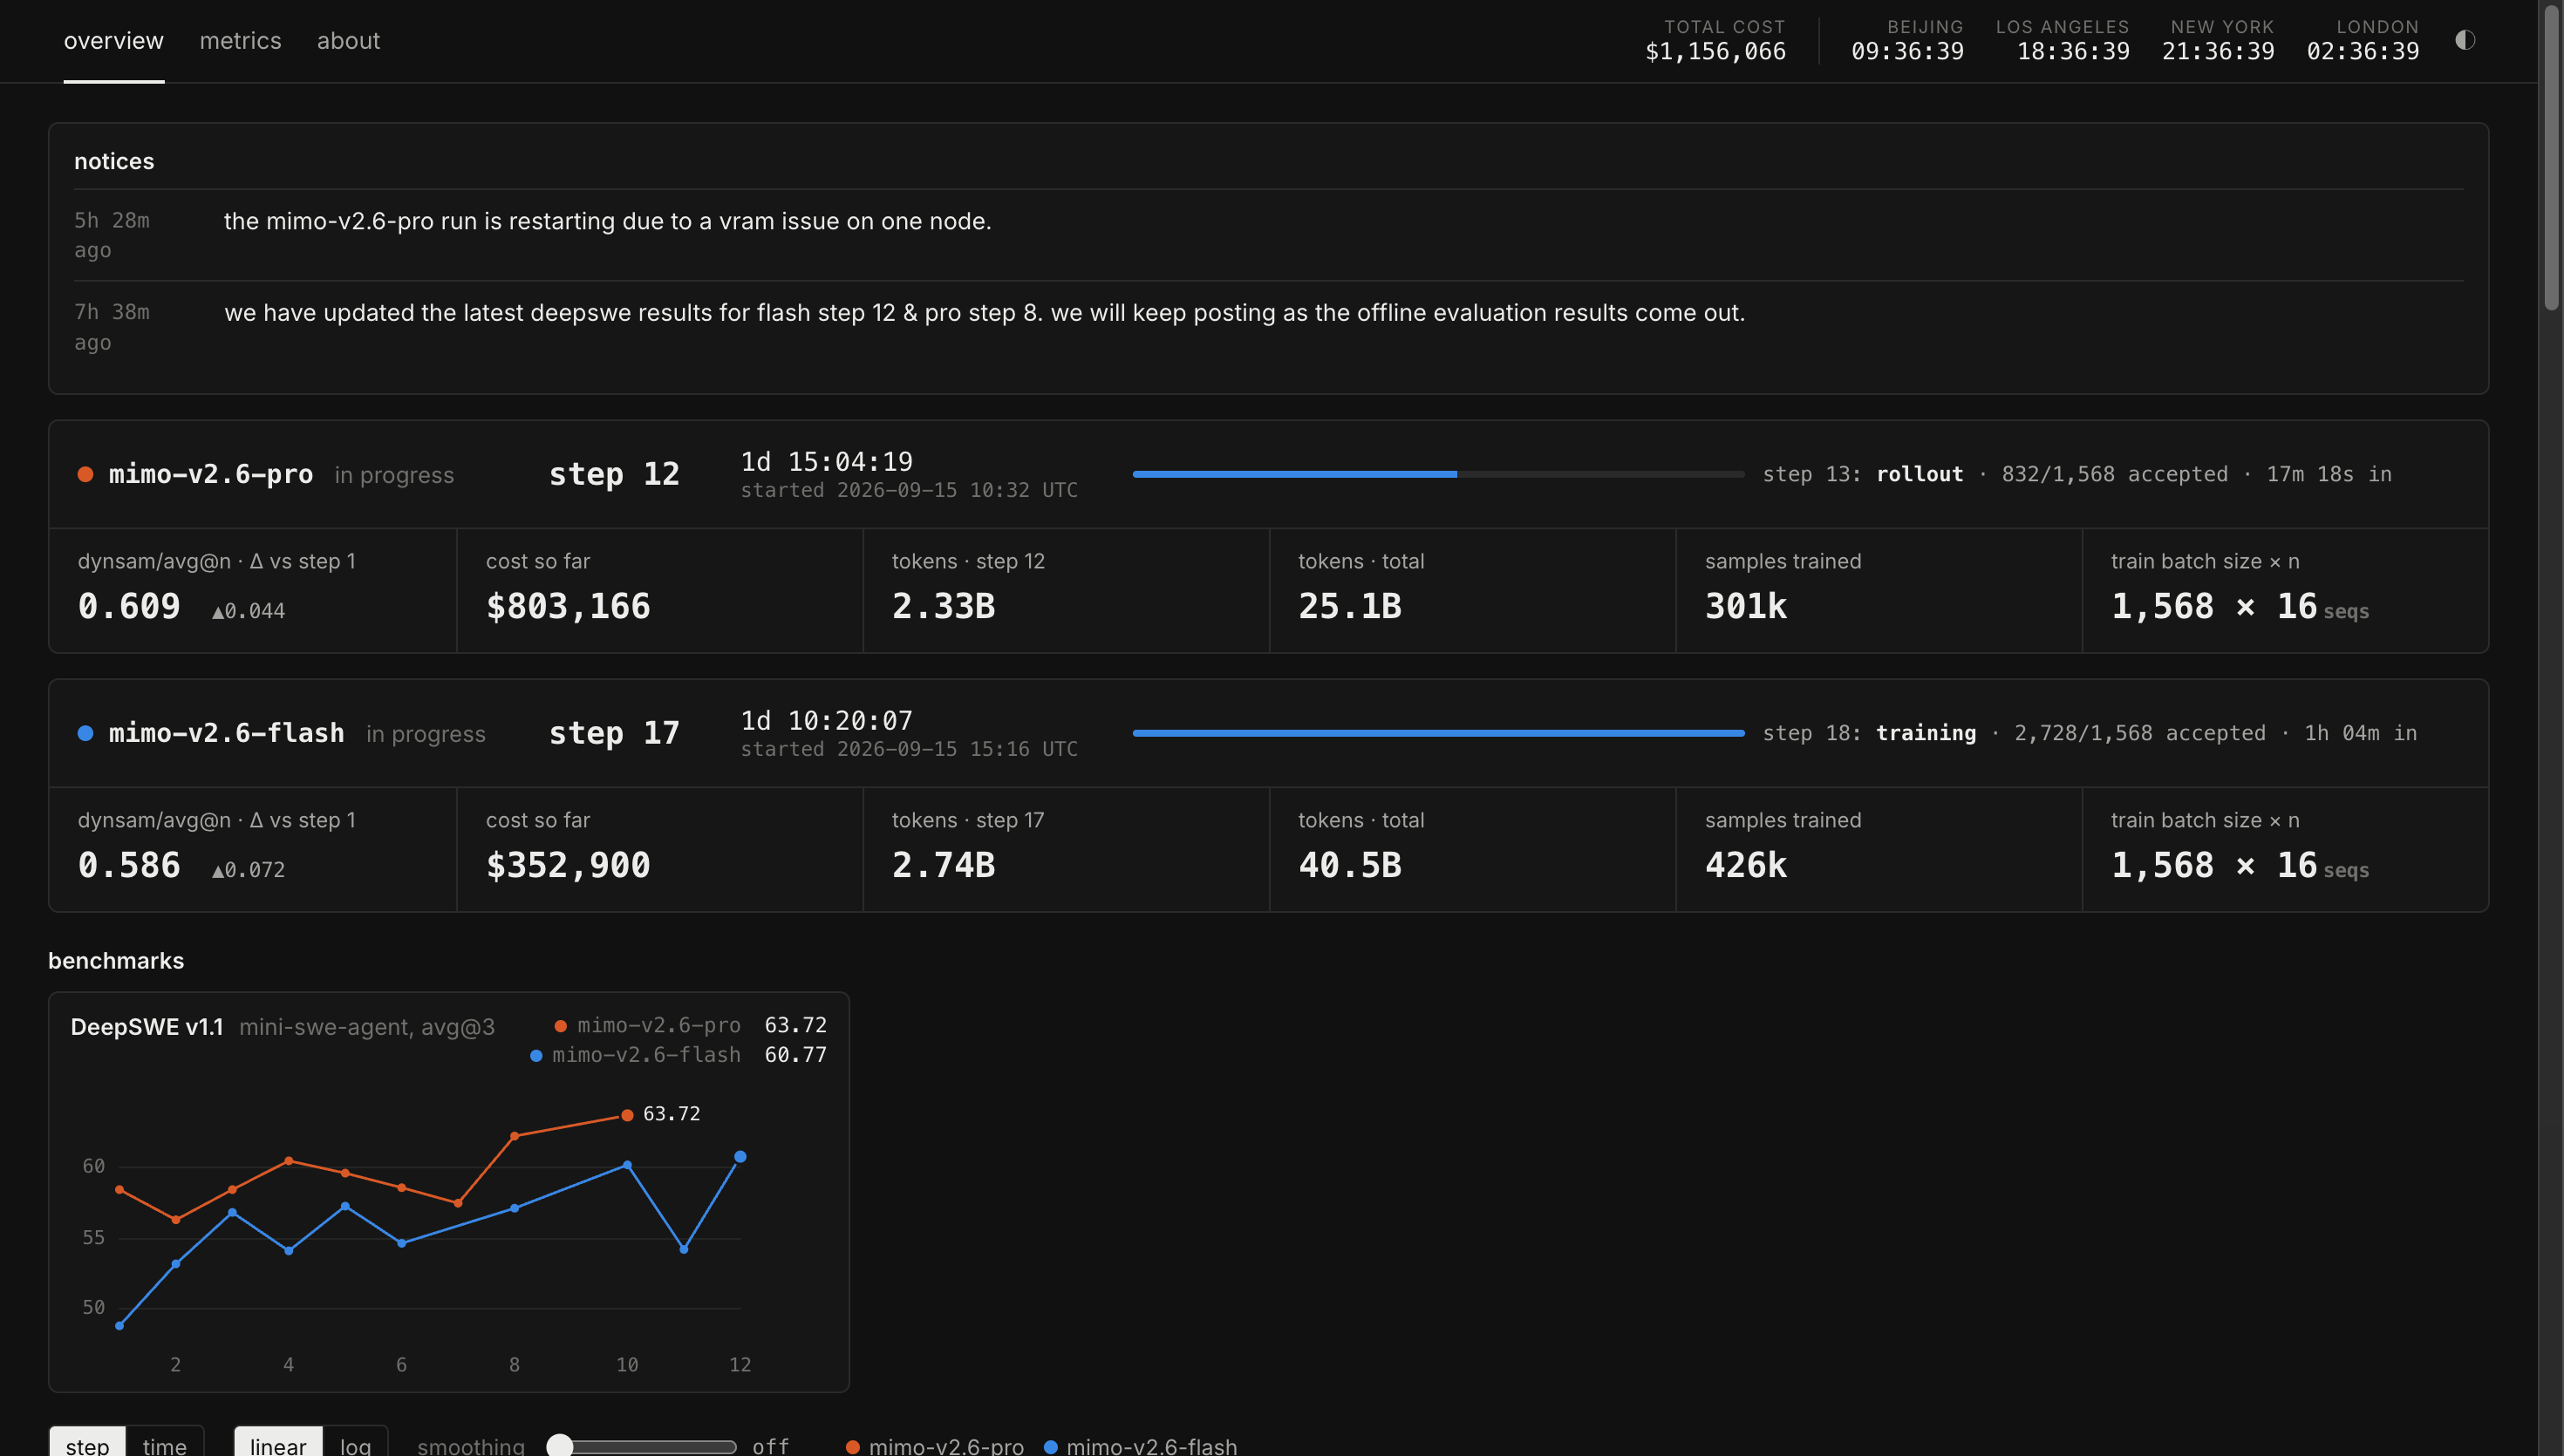
9月17日消息,小米上线了 MiMo-V2.6 的强化学习训练公开页,把 mimo-v2.6-pro 和 mimo-v2.6-flash 两个训练 run 的花费、单步 token 数、通过率曲线和节点故障记录挂在网页上。页面从9月16日12时开始推流,两个 run 处于训练中,页面对 MiMo-V2.6 系列的描述是 coming soon。
公开页按步更新成本、曲线和故障
Pro run 的起点是9月15日18时32分,Flash 的起点是当晚23时16分。截至9月17日上午,Pro 完成 12 个训练步,Flash 完成 17 个。
每步采样 1568 个 prompt,每个 prompt 生成 16 条 rollout,合计 25088 条轨迹。小米 MiMo 团队负责人罗福莉在 X 上说,单步 token 的量级是 20 亿。公开页记录的单步 token 数落在 17.9 亿至 28.1 亿的区间,Pro 第 12 步为 23.28 亿,Flash 第 14 步为 28.05 亿。
花费以每秒速率给出。Pro 每秒 5.71 美元,Flash 每秒 2.855 美元。Pro 累计 80.1 万美元,Flash 累计 35.2 万美元,两者相加 115.2 万美元,折算成小时是 3.08 万美元。
中断记录出现在页面上。Pro 重启 5 次,Flash 重启 1 次,其中一条通知写明 Pro 因一个节点的显存问题重启。
进度字段显示生成、判分和训练处于并行状态。Pro 第 13 步接收 712 个 prompt,其中 693 个完成判分,目标为 1568 个。公开页对 avg_staleness 的说明是采样与训练之间相隔的策略版本数,同一步内存在等待判分的样本与推进中的训练。
小米把扩展拆成算力、环境与 harness、评分算力
算力一项对应每步 20 亿 token、1568 个 prompt 乘 16 条 rollout,以及异步执行的方式。异步的代价写在页面字段里:不同样本的采样时刻与训练时刻相隔数个策略版本。
环境一项是多任务 agentic RL。公开页按数据源把 prompt 分成 code、general、cyber、visual、chat 五组,并设 harness 维度按 rollout 统计。同一次 run 里的任务运行在不同执行框架中,编程类任务可以开终端、改代码、跑测试、读报错,视觉类任务面对另一套工具和成功条件。页面上任务用匿名数据集编号标注,具体任务名与 harness 名目前属于未公开项。
评分一项是 agentic in-group credit assignment,奖励来自测试用例与评分标准。罗福莉用的说法是 grader compute,即为打分环节投入算力。算法细节留待后续公开。
罗福莉说,相关细节会在未来几周公开。上一代 MiMo-V2.5 系列的路径类似:今年4月23日开启公测,之后以 MIT 协议开放权重。
通过率在涨,训练内指标不等于排名
页面头条指标是 dynsam/avg@n。按公开页的定义,对每一步采样的每个 prompt,统计其 n 次尝试中成功的比例,并对 prompt 求平均。
Pro 在第 1 步为 0.5647,第 11 步升到 0.6142,第 12 步回落到 0.6088。Flash 从第 1 步的 0.5137 升到第 16 步的 0.6025,第 17 步回落到 0.5857。两条曲线在上升过程中出现回落。
两个 run 的步数不同,比较要按步对齐。第 12 步上,Pro 为 0.6088,Flash 为 0.5770,差距从第 1 步的 0.051 收窄到 0.032。
这个指标的来源是训练集,属于训练内统计。页面上的第二类指标是 DeepSWE v1.1 的离线结果,备注写明 mini-swe-agent 与 avg@3:Pro 第 10 步 63.72,Flash 第 12 步 60.77。
分数受 harness 影响,对照前需要交代口径。DeepSeek V4.1 Flash 在 DeepSWE v1.1 上得 74.2,这是 mini-SWE 口径,据 OrcaRouter 汇总的 Datacurve Pass@1 榜,74.2 排第二,排在首位的 Muse Spark 1.3 为 75.40。同一份汇总引 DeepSeek 自己的数据说明,同一个模型换成别的 harness,分数从 74.2 掉到 65.5,跨度 8.7 分。63.72 与 74.2 的对照因此有前提:小米的分数是 avg@3,DeepSeek 的是 Pass@1,两个数字的口径不同,直接相减会失真。 公开字段引出的技术取舍
公开页放出了 2019 项指标标签。critic 一族覆盖 advantages、returns 和 score,partial/avg_staleness 记录采样与训练之间相隔的策略版本数。
这两类字段对应训练方法上的选择。8月17日挂上 arXiv 的论文 Le Critique 讨论过同一组问题:group-relative 方法靠一个 prompt 采样多条 rollout 降低梯度方差,代价是信用落到序列一级,掉队的 rollout 会阻塞训练,吞吐下降、策略偏离加大。学习价值函数在理论上覆盖这两个问题,代价是额外的工程复杂度与推理开销,论文因此提出 PVF 与 TETHER 两种改法。
指标名说明不了实现方式,公开页给出的字段不含消融数据。
预算怎么切分,是公开页留下的另一个问题。同一份预算下,扩 prompt 数、扩每个 prompt 的 rollout 数、扩评分算力服务的目标不同;页面给出的配置是 1568 乘 16,其他配置的对照结果属于未公开项。
这次公开的是训练过程本身
小米这次公开的对象是训练过程本身。权重、代码或数据集的开放此前出现过多次,这次挂上网的是成本斜率、通过率曲线、重启次数和判分进度,这类内容过去留在训练日志里。
对做同类 agentic RL 的团队,公开页提供了可以对照的工程量级:单步 20 亿 token,上千个 prompt,每个 prompt 16 条轨迹,页面给出的单步耗时预期是 9063 秒,花费按秒计。这些数字出自厂商自己的页面,属于自报口径。
训练中断与节点故障被写进对外内容,外部能看到这类系统的稳定性侧面。5 次重启带来的算力损失,以及重启对通过率曲线的影响,属于未披露项。
这些数字推不出 MiMo-V2.6 的能力水平。通过率是训练集内指标,DeepSWE 分数来自单 harness 与少步数,两者随训练继续变化。罗福莉所说的扩展极限,是这次训练要回答的问题,当前页面上的数字覆盖的是训练进度。
 AI 速览