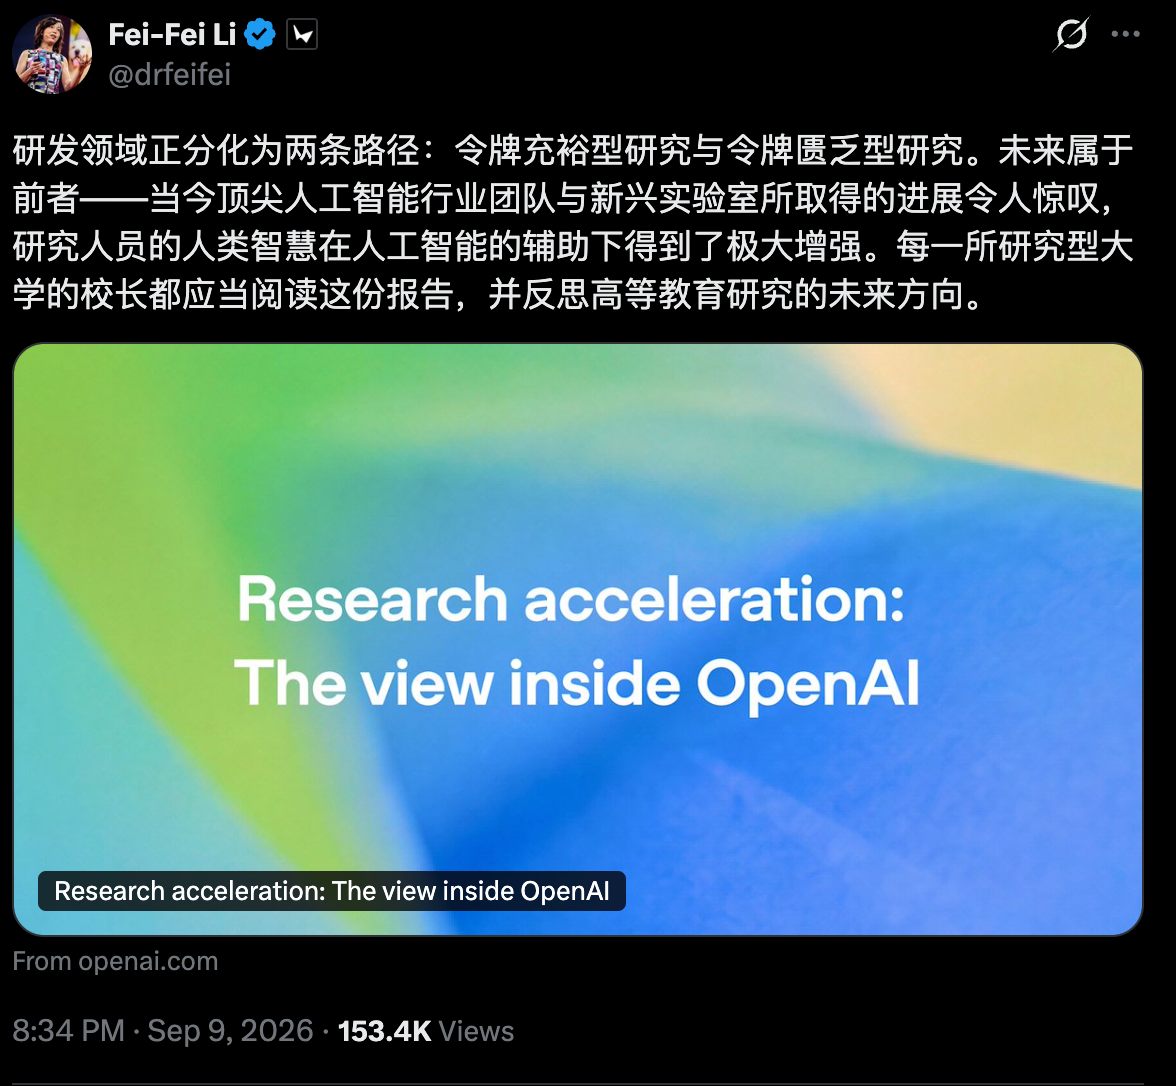
9月10日消息,斯坦福大学教授李飞飞在 X 上评价 OpenAI 三天前发布的内部研究加速报告《Research acceleration: The view inside OpenAI》。她写道:「研发领域正在分化为两条路径:令牌充裕型研究与令牌匮乏型研究。未来属于前者。」原推英文的用词是 token-abundant 与 token-starved。在她看来,当今顶尖 AI 行业团队与新兴实验室的进展令人惊叹,研究人员的人类智慧在 AI 辅助下得到极大增强。她由此向高校喊话:每一所研究型大学的校长都应当阅读这份报告,并反思高等教育研究的未来方向。这份报告的数据全部来自 OpenAI 自述口径;她的论断里哪些落在数据上、哪些是推断,可以分开看。
三层论断,最后落在大学校长
李飞飞这条推文获得超过 15 万次浏览。她的判断分三层:分化正在发生;未来属于 token 充裕的一方;大学站在匮乏一侧,校长们需要现在就读这份报告。三层都标注着她自己的立场,推文里没有给大学留缓冲表述,而是直接把一份公司内部报告推荐给了所有研究型大学的管理者。
判断的依据:600 美元与 3.1 倍
让她作出判断的报告发布于 9月6日。OpenAI 在其中称,已达成去年秋天定下的「9 月前造出自动化研究实习生」目标:按 API 价格折算,内部中位数研究员每天的 agent 推理用量超过 600 美元,使用量前 10% 的研究员每天消耗的 token 超过 7,000 美元;到 8 月中旬,研究组织每 1 个人类工作日对应 3.1 个 agent 工作日。多个曾设固定答疑时间的团队出勤率下降,其中一个停掉了答疑会。OpenAI 把下一个目标定在 2028年3月前,做出自动化 AI 研究员。
这些数字给出了「token 差距」的量纲:agent 化研究是有单价的,单价以 token 计,而 OpenAI 内部的用量曲线在八个月里大幅上扬——年初,中位数研究员还只是少量使用 coding agents。
报告没写大学,外推是她的动作
事实与推断需要分开。报告通篇讲的是 OpenAI 内部:中位数用量、任务分布、安全事故与算力分配,没有出现任何关于大学或学术界的对比。把「OpenAI 内部用量很高」外推为「研发正分化为两条路径、大学在匮乏一侧」,是李飞飞自己的引申。
数据本身也有边界。OpenAI 在报告中写明,agents 仍需大量人类引导,过去 6 个月成功完成的 4 至 8 小时任务中超过一半至少需要一次人工干预;实验数量创新高与算力投入大幅增长相关。快照的全部数据为公司自述口径,尚无独立核验。「未来属于前者」因此是一个方向判断,而不是已有结论——她的依据是趋势斜率,不是大学与行业研究的对照数据。
同时站在两侧的人
这句话的分量与说话人的位置有关。李飞飞既是 ImageNet 的发起人、斯坦福大学教授,站在学术界一侧;也是空间智能公司 World Labs 的联合创始人,参与产业竞争。两种研究环境都经历过的人,对资源差距有直接体感。她的呼吁因此超出一般的名人转发,更接近一个跨界者对高教系统的警示。
她同样没有给出答案。如何让大学研究变得 token 充裕——更多算力捐赠、共享基础设施,还是与产业界的新型合作——推文里没有展开,报告里也不存在这个问题。OpenAI 的加速按自己的时间表推进,大学的应对方式,目前还是一份留给校长们的开放题目。
 AI 速览