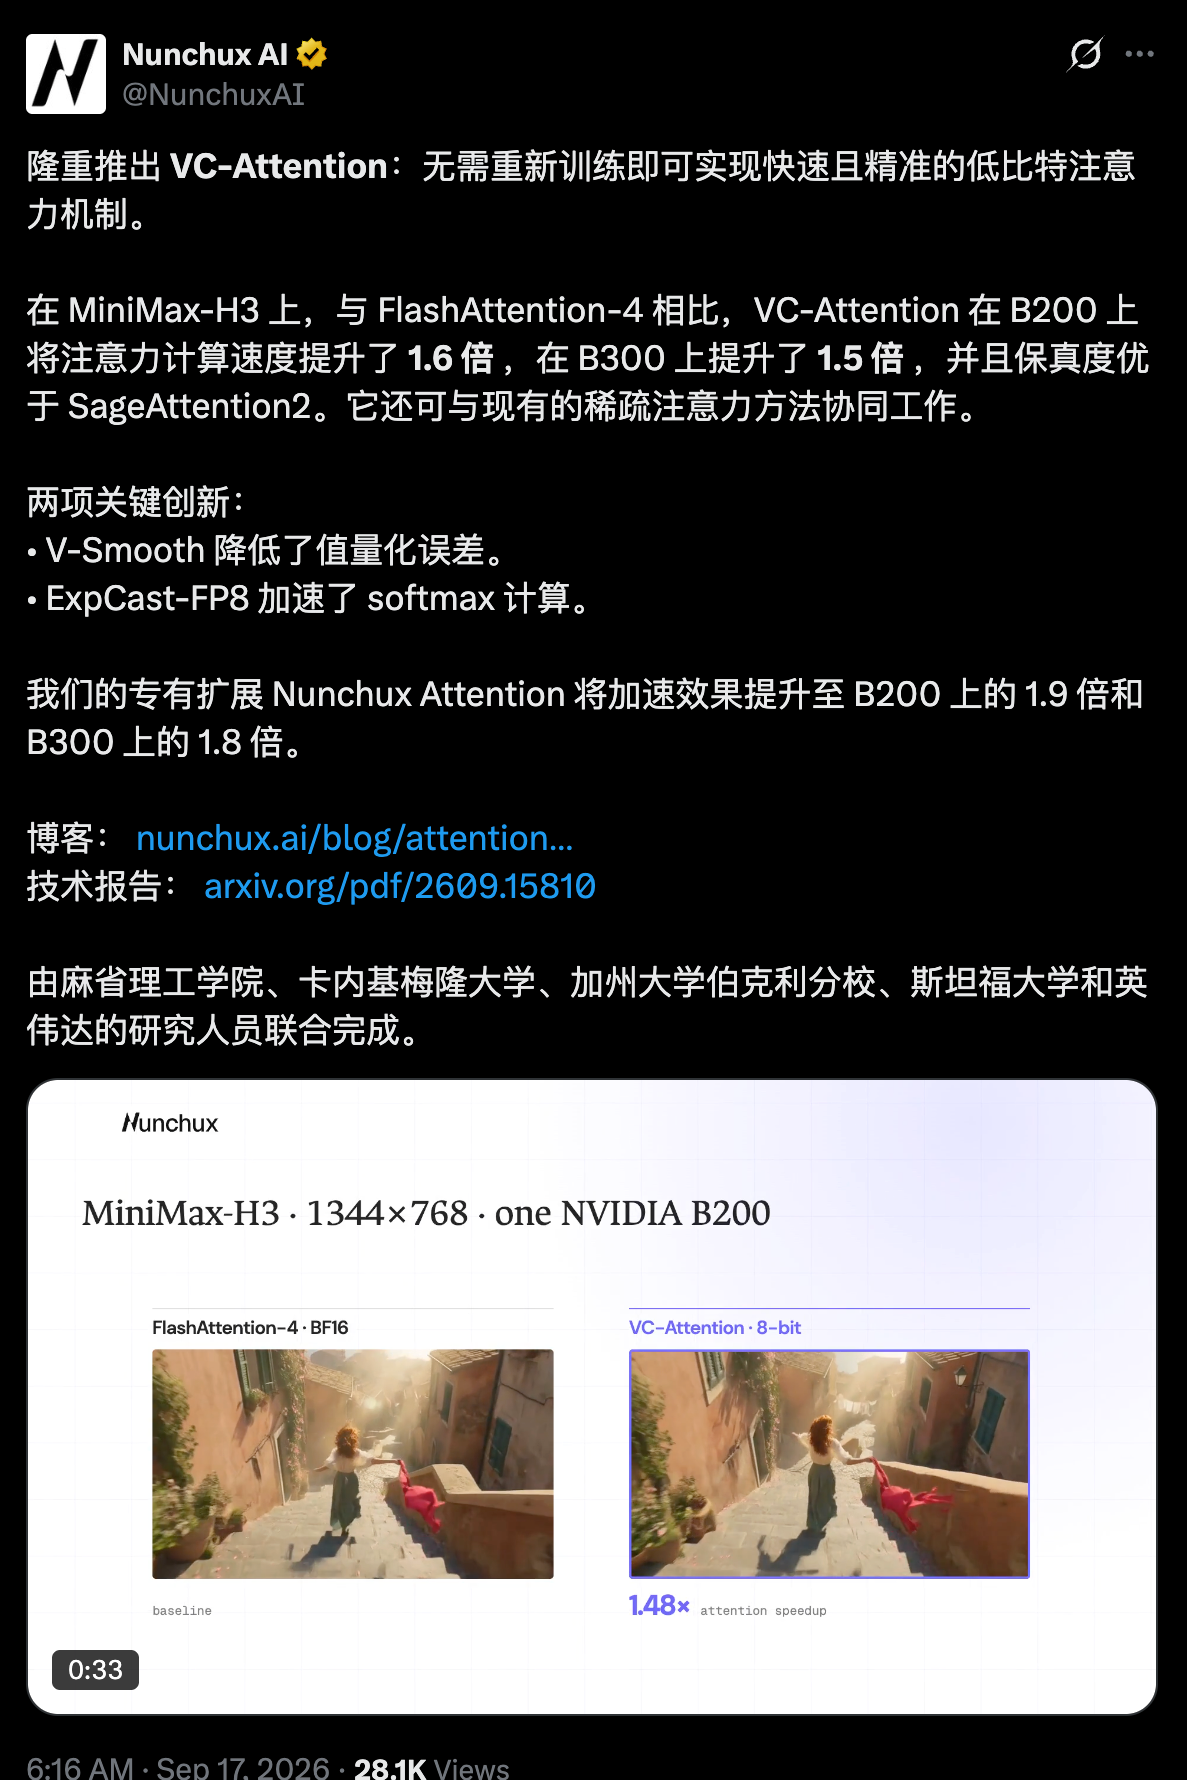
- Nunchux AI 联合 MIT、CMU、UC Berkeley、Stanford 与 NVIDIA 发布 VC-Attention,论文 2026 年 9 月 14 日提交至 arXiv,编号 2609.15810。
- 论文针对两个瓶颈:value 的量化误差,以及低比特注意力里无法被 Tensor Core 加速的 softmax 指数运算。
- V-Smooth 用轻量 k-means 把相似的 value token 分进同一个硬件块,减掉块均值后只量化残差,单这一项在四个视频模型上比 SageAttention2 高 1.1 至 2.8 dB PSNR。
- ExpCast-FP8 用一条融合乘加把对数域分数直接写成 E4M3 概率字节,跳过 FP32 指数运算与格式转换。
- 在 MiniMax-H3 的 243 帧、1344×768 负载上,注意力内核相对 BF16 FlashAttention-4 在 B200 提速 1.59 倍、B300 提速 1.51 倍;专有扩展 Nunchux Attention 达到 1.91 倍与 1.83 倍。
- 端到端出片加速低于内核峰值,论文给出的区间是 1.13 至 1.19 倍与 1.36 至 1.70 倍。
一句话说清楚:这论文在解决什么问题
生成一段十秒视频,慢在哪里?Nunchux AI 给出的答案是注意力。他们测得在单张 B200 上跑 MiniMax-H3,用 BF16 精度的 FlashAttention-4 时,每个去噪步骤里约三分之二的时间花在注意力上。注意力成本随 token 数平方增长,片段越长,这个比例越高。
降低注意力的算力开销有成熟办法:把矩阵乘法压到 8 位整数或 8 位浮点,让 Tensor Core 提速。这条路在视频模型上未能落地,原因有两个。一个是量化误差,另一个是 softmax,而后者是被忽视的一环。
核心方法之一:V-Smooth 把 value 的离群值收拢
量化误差的来源是离群值。一个硬件块共享一个量化刻度,刻度由块内峰值元素决定,其余元素因此被挤在窄的可表示范围里。用尺子做类比:如果按班里个子最高的人定刻度,其他人全挤在头几格里,刻度的粒度改变不了这一点。
前人的工作处理了 query 和 key 的离群值,常用手段是 Hadamard 变换,把离群值摊到各个通道上。VC-Attention 的观察是,value 的离群值不遵循固定的通道结构,不遵循时空结构,因此成为输出误差的主要来源。
V-Smooth 的做法分三步。先用一次轻量 k-means 把相似的 value token 聚到同一个硬件块,让一块之内的数值彼此接近。然后减掉这一块的均值,均值本身以高精度存储。接着把残差送进 8 位量化器。减法让残差变得小且均匀,量化误差随之下降。均值的恢复不需要额外开销,它来自在线 softmax 维护的行和。
论文报告,单是 V-Smooth 这一项,在四个视频模型上比 SageAttention2 高出 1.1 至 2.8 dB PSNR。
核心方法之二:ExpCast-FP8 换掉 softmax 里的指数
两个矩阵乘法可以走低比特 Tensor Core,夹在它们中间的 softmax 跑在 FP32 上。这一步成了流水线里耗时最长的一级,低比特带来的收益被它吃掉一部分。
softmax 的这一段做两件事:算指数,再把结果转成 8 位格式。VC-Attention 的 ExpCast-FP8 把两件事合成一件。E4M3 格式的一个字节大致可以表示 8·log₂p + 56,其中 p 是概率、log₂p 来自注意力分数,这意味着字节本身与分数之间存在线性关系。ExpCast-FP8 因此用一个融合乘加直接算出 8z + 56 + β 并取整,跳过 FP32 指数运算,并跳过从高精度到 E4M3 的格式转换。
两条路走下来,注意力流水线从"低比特矩阵乘法加 FP32 softmax"变成"低比特矩阵乘法加线性映射的 softmax",中间那一级不再成为瓶颈。
成绩单:数字与对比
基准场景是 MiniMax-H3 生成 243 帧、1344×768 的视频,对比对象是同一张卡上的 BF16 FlashAttention-4。论文给出的注意力内核加速比如下。
保真度方面,在 100 个 prompt 上,VC-Attention 的输出相对 BF16 参考的平均 PSNR 是 20.2 dB,SageAttention2 是 19.9 dB。论文称这是免训练方案中贴近 BF16 结果的一档。
硬件覆盖 B200、B300、H200、RTX PRO 6000 与 RTX 5090,模型覆盖 Wan2.2、LongCat-Video、HunyuanVideo-1.5 与 MiniMax-H3。在工作站显卡上,注意力内核的加速比达到 2.3 至 3.6 倍。
意义与局限
这项工作的价值在"免训练"三个字。VC-Attention 不改模型权重,推理时替换注意力内核即可,因此可以接在现成的视频模型上,并能与稀疏注意力、少步蒸馏、多卡并行叠加使用。对需要压低推理成本的服务方,这是一条不必重训模型的优化路径。
这项工作的局限清晰。端到端出片速度低于内核加速比,论文给出的区间是 1.13 至 1.19 倍与 1.36 至 1.70 倍,注意力占整条流水线的一段。V-Smooth 的开销需要按调度权衡,在 B200 的那组测试里它只在去噪过程的前四分之一步数中开启。Nunchux Attention 属于公司的专有扩展,未公开细节。
需要提醒的是,论文与博客中的数字全部来自作者自测,目前没有第三方复现。20.2 dB 与 19.9 dB 之间 0.3 dB 的差距在指标上成立,在主观画质上是否可感知,需要额外评测。论文与博客未给出开源代码仓库,要用这套方法,需要按论文描述自行实现内核。
作者、代码与资源
作者名单里可以看到几位熟悉的名字:MIT 的 Song Han、CMU 的 Jun-Yan Zhu、ControlNet 作者 Lvmin Zhang,以及 Muyang Li、Haocheng Xi 等,机构署名覆盖 Nunchux AI、MIT、CMU、UC Berkeley、Stanford 与 NVIDIA。团队此前的相关工作包括 Sparse VideoGen、Radial Attention 与 SpargeAttn。
团队背景解释了这套工作为什么全部来自作者自测。Nunchux AI 由 MIT 博士 Muyang Li 与 CMU 教授 Jun-Yan Zhu 联合创立,两人出自 Song Han 的研究圈;公司在 2026 年 9 月获得数百万美元种子轮融资,并从隐身状态走出。论文与博客公开、代码不开源、加速数据由作者自测,与一家以推理服务为业务的初创公司的位置相符。
论文地址为 arXiv:2609.15810,官方博客在 nunchux.ai。Nunchux AI 为 MiniMax-H3 的免费访问开放了等待名单。研究者可以复现方法,工程团队接入前需要评估自研内核的成本。
 AI 速览