9月20日消息,2026 云栖大会定于9月22日至24日在杭州举办。开幕前披露的分论坛议程显示,阿里巴巴 Token Hub 相关分论坛安排了 7 场分享。产品线覆盖世界模型、图像生成、语音三条线。议程写明将发布 Happy Oyster 2.0 Preview;Qwen-Image-3.1、Qwen-Audio-3.1 系列(含 ASR、TTS 与全双工 Realtime)为技术讲解。以上场次属于会前披露,各模型能否按议程亮相、表现如何,要等大会实际内容。
Happy Oyster 2.0 Preview:议程里唯一写明发布的条目
世界模型分论坛的两场分享排在上午时段。9:00 至 9:20,Happy Oyster 技术负责人苏文博以"World Model Technology Evolution and Outlook"为题,议程写明将发布 Happy Oyster 2.0 Preview。9:20 至 9:40,北京通用人工智能研究院(BIGAI)的陈一心分享 World Model Arena 与 Benchmark。
Happy Oyster 1.0 于 4月16日开启体验,是阿里 ATH 团队的开放式世界模型产品,支持实时世界创建与交互,基于原生多模态架构,最长可生成 3 分钟的影片。2.0 Preview 会带来什么,议程没有给出更多信息。
Qwen-Image-3.1:生产力基座写进议程标题
图像分论坛(13:30 至 13:50),Qwen-Image 技术负责人吴振飞讲解 Qwen-Image-3.1,议程标题把定位写成"A Productivity-Ready Foundation Model for Image Generation",即面向生产力的图像生成基座。上一代 Qwen-Image-3.0 于 7月20日发布,官方称其为 Qwen-Image 系列第三代基座模型。3.1 与 3.0 相隔两个月。
Qwen-Audio-3.1 系列:四场分享,从 ASR 到全双工 Realtime
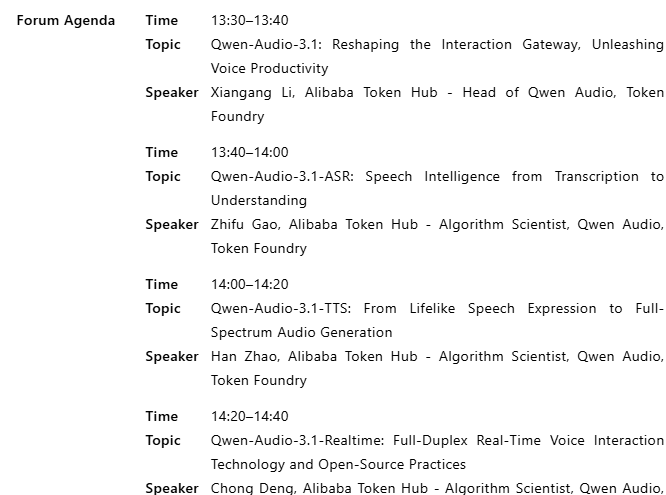
语音线的四场分享对应四个技术方向。李先刚(Qwen Audio 负责人)讲 Qwen-Audio-3.1 的整体定位,议程标题是"Reshaping the Interaction Gateway, Unleashing Voice Productivity";高志福讲 ASR,从转写走向理解;赵晗讲 TTS,从拟真表达到全频谱音频生成;邓冲的 Realtime 场(Full-Duplex Real-Time Voice Interaction Technology and Open-Source Practices)议题含全双工实时语音与开源实践。上一代 Qwen-Audio-3.0 的技术报告见于 arXiv,采用统一的非自回归框架(DiT)。
三线同场:Token Hub 成立半年后的集中亮相
从议程名单看,分享人以 Token Hub 各团队为主。这个组织 3月16日成立,吴泳铭直管,整合了通义实验室、千问事业部等模型与业务团队;6月8日,其下组建 Token Foundry 事业部,由通义大模型事业部与未来生活实验室合并而来,方向是视频、图像等多模态能力。周靖人任集团首席科学家,牵头 AI 未来研究院。
把三条线放回时间线:Qwen-Image 从 3.0 到 3.1 相隔两个月;Happy Oyster 从 1.0 到 2.0 Preview 相隔五个月;Qwen-Audio-3.0 技术报告发布之后,3.1 系列以四场分享的规模登台。议程披露的是安排而不是结果:模型表现如何、开放计划有哪些,要等大会开幕后验证。
 AI 速览