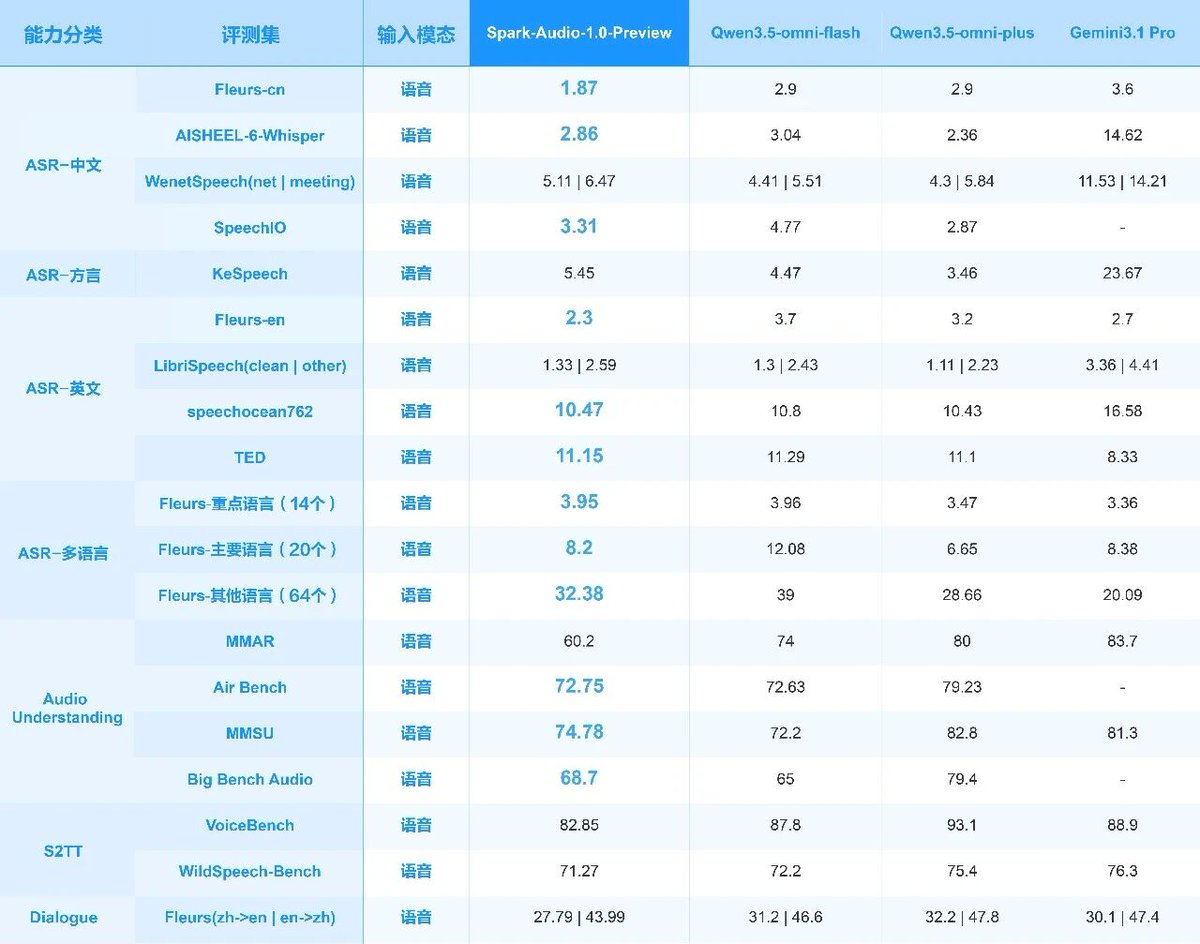
9月16日消息,科大讯飞上线语音基座大模型 Spark-Audio-1.0-Preview。模型采用 0.65B 稠密(Dense)结构的音频编码器,搭配 30B-A3B 混合专家(MoE)结构的大语言模型,训练数据为 1300 万小时音频与大量文本,训练所用算力集群为纯国产。官方称,该模型在多语言、多方言语音识别的平均效果上优于同尺寸的 Qwen3.5-Omni-Flash,并接近参数量高一个数量级的 Qwen3.5-Omni-Plus。
从级联到单一模型:架构与训练数据
过去处理音频,主流做法是级联:先把语音转成文字,再交给大模型理解。文字记录的是「说了什么」,丢掉语气、情绪和环境音;转写、声纹、翻译被拆成独立模块串联,模块间的断点会累积误差,使用中出现延迟。Spark-Audio-1.0-Preview 改用单一模型:文本与语音进入同一个模型,输出文本,语音转写、多语言翻译、多方言识别、环境音识别、说话人识别、情感分析与音频问答由一个模型承担。
架构上,音频编码器为 0.65B 稠密结构,大语言模型为 30B-A3B 的 MoE 结构,两者组合后支持文本与语音两种输入。训练数据为 1300 万小时音频加上大量文本,训练所用算力集群为纯国产。可识别范围覆盖 99 种语言与 202 种方言。
三个测试集各有侧重,「接近 Qwen3.5-Omni-Plus」的参照系
讯飞方面的对比口径分为三组:与同尺寸的 Qwen3.5-Omni-Flash(35B-A3B)相比,Spark-Audio-1.0-Preview 在多语言、多方言语音识别的平均效果上占优;与参数量高一个数量级的 Qwen3.5-Omni-Plus 相比,效果接近;在 FLEURS、KeSpeech、LibriSpeech 三个公开测试集上得分高于 Gemini-3.1 Pro,FLEURS-中文测试集取得 SOTA(当前最优成绩)。官方称,优势集中在高噪声、小音量等复杂场景。 三个测试集各有侧重。FLEURS 是覆盖 102 种语言的多语种语音识别基准;KeSpeech 是普通话加 8 种方言的开源中文方言数据集,音频来自 34 个城市、27237 名说话人,总时长 1542 小时;LibriSpeech 是英文语音识别的常用基准。讯飞占优的区间落在「语种多、方言多、噪声大」的语音识别任务上。
对比对象本身的位置需要交代。Qwen3.5-Omni 是阿里 2026 年 3 月发布的全模态大模型,发布时称在音视频理解、识别与交互等 215 项任务取得 SOTA,超越 Gemini-3.1 Pro;其技术报告显示,Qwen3.5-Omni-Plus 在 FLEURS 测试集上的平均词错误率(WER)为 6.6%,优于 Gemini-3.1 Pro 的 7.3%。Spark-Audio-1.0-Preview 与之「效果接近」,参照的是一个在多语种语音识别上跑赢 Gemini-3.1 Pro 的全模态旗舰。
开放体验先行,API 随后;官方自陈短板
模型目前开放体验,API 接口的上线渠道为讯飞开放平台,开放时间未公布。官方对模型短板的表述是:通用知识、数学与代码任务未出现降智迹象,指令遵循、对话与音频理解任务存在进步空间。
这段自陈指向模型定位。Spark-Audio-1.0-Preview 的输出为文本,不覆盖图像与视频,参数与 1300 万小时数据压在语音一条赛道上;Qwen3.5-Omni 同时处理音频、视频与文本。「接近 Qwen3.5-Omni-Plus」的参照限定在语音识别范围内,不能读作整体能力追平。对语音应用开发者,能直接检验的是开放体验中的实际识别效果。
 AI 速览