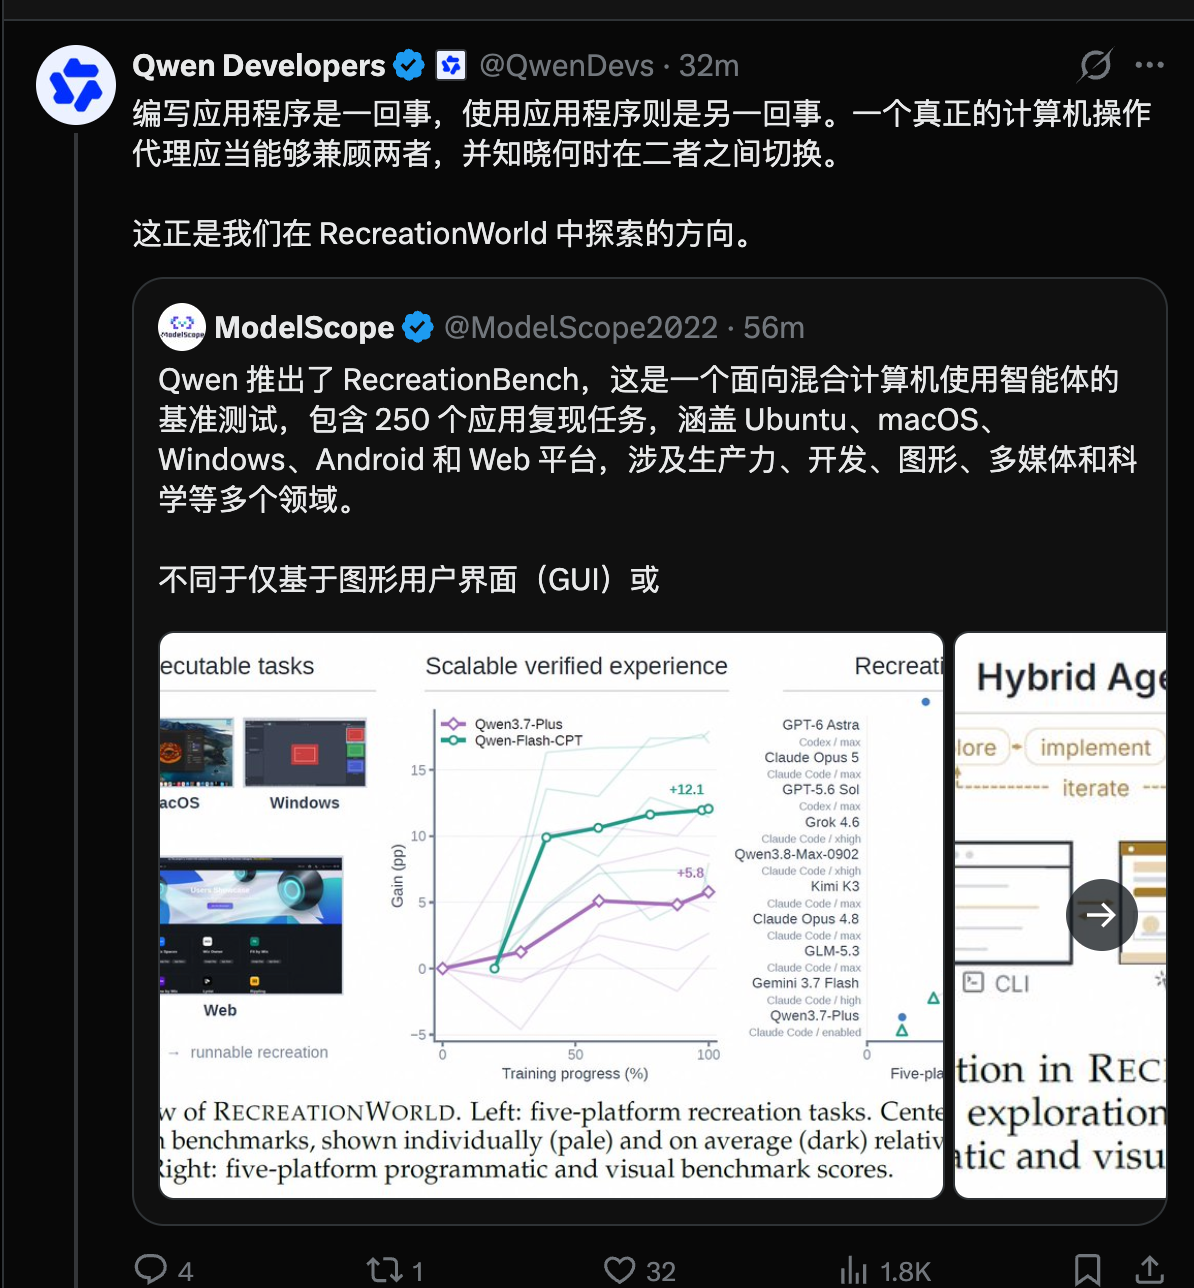
9月21日消息,Qwen 团队随 9月18日 提交的论文公开了应用复刻基准 RecreationBench:250 个任务覆盖 Ubuntu、macOS、Windows、Android 与 Web 五个平台,智能体拿到一个运行中的参考应用后,需探索其行为、用代码重新实现并通过程序化测试与视觉评估双重判分。论文结果显示,GPT-6 Astra 以 58.1% 的总分领先,但仅在 2.8% 的任务上通过全部程序化测试。
复刻怎么考:以参考应用为标准答案
RecreationBench 的每个任务只给智能体一段高层的复刻请求和一个可交互的参考应用。智能体自主探索参考应用的行为,重新实现一个功能等价的应用,并自我验证结果;参考应用的源码与评测测试都不可见。工具链同时提供原生 GUI 控制与编程工具,智能体可以自由组合点击操作与写代码,不规定工作流。
评分不比较源码相似度,只看可观察的功能与视觉保真,分两项指标:程序化检查(Prog)以参考应用为标准执行行为断言,视觉评估(VLM)由视觉语言模型判断复刻应用的视觉一致性;每条断言先在参考应用上验证、经人工审核后冻结,用于自动评分。总分为两项指标的非加权均值,按平台宏平均、五平台等权。任务难度分三档,五个平台各 50 个,领域覆盖生产力、开发、图形、多媒体与科学。
静态界面易,交互与计算难
论文给出的基线结果呈现了长程任务的难度结构。GPT-6 Astra 总分 58.1% 居首,说明部分通过测试并不难;但全测通过率只有 2.8%,意味着在 250 个任务里不足 8 个能拿到完整的程序化通过。论文的两项发现与此呼应:智能体复现静态界面结构比复现交互行为与计算输出更可靠;生成的应用普遍比参考应用更小、结构更单一。
这一基准并非凭空出现。Qwen 在 8 月发布 Qwen3.8-Max 时,已将其作为内部长程评测提及,本次是随论文与数据集首次公开。
训练环境、数据集与排行榜同步开放
与基准配套的 RecreationWorld 框架把应用复刻做成可扩展的训练环境:参考应用充当隐藏行为测试的标准答案,提供基于执行的奖励,用于从开源应用中规模化生成训练轨迹。论文称,用该框架轨迹训练的模型在 5 个分布外的编程与混合计算机使用基准上均有提升。
数据集已在 Hugging Face 与 ModelScope 开放,约 500 行、23.9 GB;GitHub 仓库(QwenLM/RecreationWorld)提供框架代码,排行榜站点 recreation-bench.cc 在线。许可分层:执行框架为 MIT,基准数据内容为 CC BY 4.0,上游应用及其资产保留各自条款,商用需逐项核对。
从评测设计看,复刻范式的价值在于把「应用做得对不对」变成了可自动执行的行为断言:参考应用即标准答案,评分锚定行为而非代码。58.1% 与 2.8% 之间的落差,就是当前混合智能体长程能力天花板的量化:静态界面画得出来,交互与计算还通不过整组断言。
 AI 速览