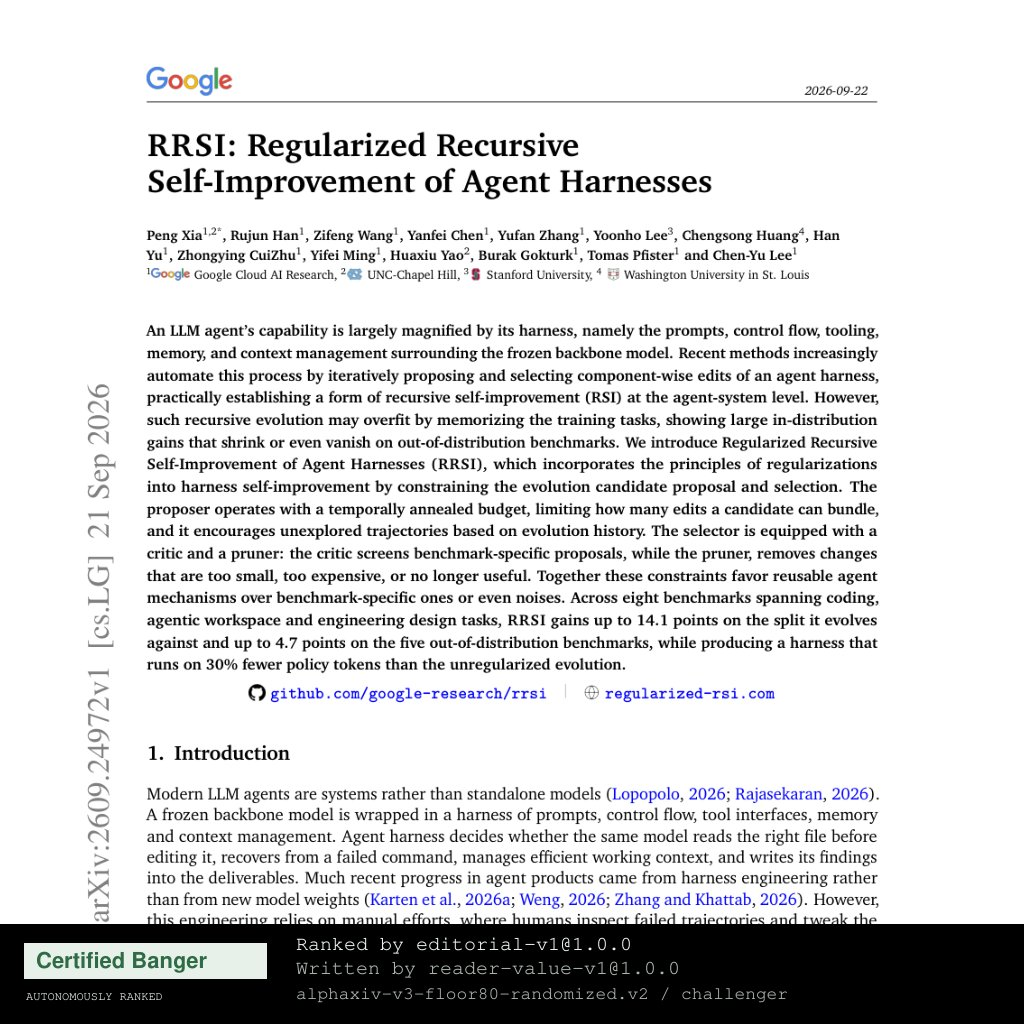
- RRSI(Regularized Recursive Self-Improvement of Agent Harnesses)是 Google Research 9 月 21 日发布在 arXiv 的论文,研究如何让智能体的 harness 自动进化而不过拟合。
- 递归自我改进的现有做法是让模型迭代修改自己的 harness(提示词、控制流、工具、记忆和上下文管理),但演化集分数大涨、陌生基准分数缩水甚至归零的过拟合现象随之而来。
- RRSI 在候选提议和选择两个环节加入正则化约束:提议端限制每次捆绑的编辑数量并鼓励未探索的轨迹,选择端用 critic 和 pruner 过滤投机性、代价高或无用的改动。
- 在覆盖编程、智能体工作台和工程设计三类任务的 8 个基准上,RRSI 在演化所用数据划分上最高提升 14.1 分,在 5 个分布外基准上最高提升 4.7 分。
- 正则化后的 harness 比未正则化演化少用 30% 的策略令牌,即改动更少、更通用,运行成本也更低。
- 代码以 Apache 2.0 许可开源在 google-research/rrsi,基于 Python 3.10+,依赖 Vertex AI 环境。
递归自我改进卡在哪:涨的都是见过的题
让智能体变强有两条路:改模型,或改模型外面那层东西。后者叫 harness——围绕冻结骨干模型的提示词、控制流、工具调用、记忆和上下文管理。同一个模型,harness 不同,表现可以差出一个档位。近一年的研究趋势是让这个改的过程自动化:模型迭代地提出对 harness 的修改、测试、择优,进入下一轮,形成智能体系统层面的递归自我改进(RSI)。这个概念本身可以追溯到 I. J. Good 在 1965 年对"超智能机器"的设想。
问题出在反馈信号上。自动化演化通常对着一批任务集优化,分数一路涨,但涨分的方式可能是记住这批题——论文把这种现象称为对训练任务的记忆。一到没见过的基准上,收益缩水,甚至消失。刷了一整套题库,考纲一变就打回原形,这正是过拟合在智能体系统里的样子。
RRSI 要回答的问题因此很具体:怎么让自动演化继续跑,又不让它学成"押题机器"。
核心方法:在提议和选择两端加闸门
论文的思路沿用机器学习的老办法——正则化,但加的对象不是模型权重,而是演化过程本身,约束落在两个环节。
提议端(proposer)拿到的约束有两个。一个是随时间退火的编辑预算,限制一个候选方案能捆绑多少处修改,逼着演化小步走,不许一轮把整个 harness 翻新。另一个是基于演化历史鼓励未探索过的轨迹,防止系统在同一种改动上打转。
选择端(selector)配了两个过滤器。critic 负责筛掉针对特定基准的投机性提议——那种只在这套题上有用、换一套题就失效的改动;pruner 负责删掉过小、代价过高或已经不再有用的变更。可以把这两个角色类比成代码评审:一个拦"为了过这条用例硬编码的补丁",一个砍"改了等于没改、还要花编译时间的提交"。
两端的约束合在一起,指向同一个目标:让演化保留可复用的通用机制,淘汰基准特异性的改动和纯噪声。
成绩单:分布外涨 4.7 分,令牌省 30%
实验覆盖 8 个基准,横跨三类任务:编程(Terminal-Bench 一类)、智能体工作台和工程设计(EngDesign)。三个数字值得分开看。
在演化所用的数据划分上,RRSI 最高提升 14.1 分——这证明正则化没有牺牲演化本身的搜索能力。真正拉开差距的是分布外场景:在 5 个演化时从未接触的基准上,RRSI 最高提升 4.7 分,而未正则化的演化在这类基准上的收益会缩水甚至消失。第三个数字是成本:正则化后的 harness 运行时少用 30% 的策略令牌。改动更克制,留下的是更短、更通用的机制,推理开销随之下降。
注意口径:这三个数字都是论文自报的最高值(up to),不是 8 个基准的平均提升;独立第三方复现目前还没有。代码虽已开源,社区讨论也尚未形成——论文发布到本文写作只有一天,GitHub 仓库 27 个 star,还没有可归因的外部评测。
意义与局限:给自动化 AI 研发补一块防过拟合拼图
这篇论文的位置在一个正在变热的方向上。Lilian Weng 近期的综述把 harness 工程列为自我改进的关键层,此前的 Self-Harness(2026 年 6 月)和 RSIAgent(2026 年 9 月)分别探索了让 harness 自我设计和通过记忆构建实现自我改进。这些工作共享一个前提:模型冻结,进步来自外围系统的自动演化。RRSI 补的正是这条路线的共同短板——演化会过拟合,而且只在分布外测试时暴露。Google Research 把正则化这个经典工具搬进来,等于给这条自动化路线补上了一块工程地基。对在做智能体自动化优化的团队,可直接借鉴的是它的两个判断:演化集和评测集必须分离,改动幅度和多样性需要显式约束。
局限同样明确。其一,实验结果全部基于论文自报,无独立复现,最高值也不代表平均效果。其二,30% 的令牌节省是相对未正则化演化而言,不是相对人工设计的基线 harness。其三,方法依赖 critic 和 pruner 的判断质量,这两个过滤器本身的失效模式,论文未展开。其四,RRSI 约束的是 harness 演化,不涉及模型权重的自我改进,读者不应把结论外推到模型层面的 RSI。
快速上手:代码、环境与资源
论文作者团队来自 Google Research,通讯方向为智能体系统与云侧 AI 研究。代码以 Apache 2.0 许可开源,Python 3.10 以上,安装走 pyproject.toml。想复现的读者注意:运行依赖 Vertex AI 环境变量配置,不是开箱即用的本地玩具。
极简上手路径如下:
--domain 支持 coding、workspace、eng 三个取值,分别对应 Terminal-Bench 编码、Harvey LAB 工作台和 EngDesign 工程设计三类演化场景;命令分 baseline(基线测量)、run(启动演化)、status(查看进度)三步。项目页在 regularized-rsi.com。
本文基于 arXiv 论文 2609.24972 及 google-research/rrsi 仓库文档撰写,发布于 2026 年 9 月 22 日。
 AI 速览