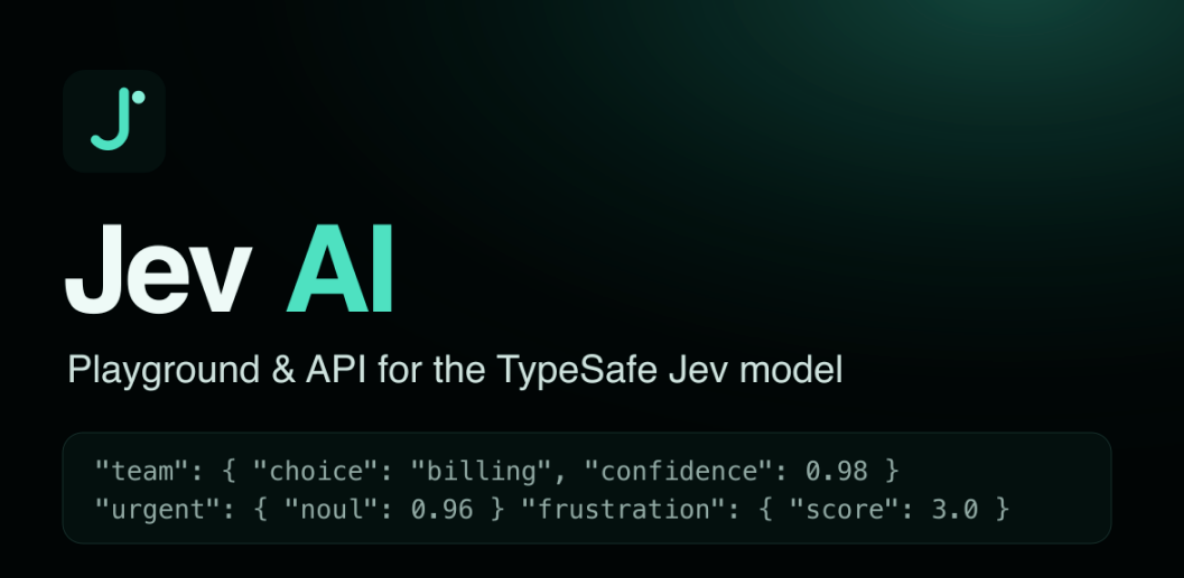
你如果最近刷到 Jev,第一反应大概率是懵的——这模型连一句完整话都说不出来,却在上线几天内把 API 挤到排队。原因很简单:它压根不想说话,只想做判断。Jev 是 TypeSafe AI 推出的 System One 模型,专门把"是不是""选哪个""打几分"这类决策丢给程序直接消费,不写文章、不聊天、不生成代码。
不说话的模型,Jev 到底在做什么
普通大模型回答任何问题都得先攒一整段话,你再从里面把结论抠出来。Jev 反着来,它只接受三种输入原语:
你给它定义好 Schema,它输出的就是结构化的、带概率分布和置信度的结果——不用求它吐 JSON,也不用写代码去解析。官网那句 "no text generation, no parsing",说的就是这个意思。
零幻觉也是这个意思的延伸:给它 A 和 B,它只能在两者之间选,不会凭空编出个 C。但选项之内选错了,它照样会错。
快在哪,省在哪
普通大模型不管答案多短,都得走一遍自回归解码,一个 token 一个 token 往外吐,这是延迟压不下去的根源。Jev 把生成这一步直接砍掉,底层只做一次前向传播——数学上是一次矩阵乘法的副产物。
延迟与实测数据一览
| | |
| | |
| | |
| | Matthew Berman 演示(40 秒拆完) |
耗时主要都砸在一次性的 Prefill 阶段,不存在长文本逐字解码的累加。
价格更狠:输入每百万 token 0.042 美元,输出免费——毕竟一次判断也吐不出几个字。
⚠️ 官网宣称的"193.6 倍更快、444.6 倍更省"是 TypeSafe 自己跑出来的数据,不是第三方独立测试,这一点得留个心眼。
多问题并行是另一个实用设计:长文本只做一次 Prefill,后面十几个离散问题共享同一份 KV Cache 前缀,各自只算少量 token 的注意力,多维度提取的耗时几乎等同于单次评估。
一个 OpenAI 老将,跟 RLHF 自己较上了劲
创始人 Diogo Almeida 参与过 OpenAI 的 InstructGPT 和早期 RLHF,某种程度上,ChatGPT 能"好好说人话"背后有他一份功劳。2024 年初他离开创业,隐身两年憋出了 Jev。
他演讲里抛过一个问题:
AI 都能做高等数学了,为什么企业不敢让它自己决定一笔退款给不给?
他的答案指向 RLHF 本身——训练时把人塞进了回路,模型学的是"人更喜欢哪个回答",而不是"这个判断到底准不准"。所以 Jev 换了一套训练目标,叫 RLCD(校准决策强化学习),比的是模型报出去的置信度和最后应验的比率能不能对上。
说白了:别吹牛,说几成就是几成。
这个校准也不是没有代价的护城河。有开源项目用未校准的小模型直接截取 logits 做类似判断,一致性只有七成多,预测错了置信度照样能飙到 0.9 以上——这也是为什么"置信度门控"这套自动化拦截的玩法,必须建立在真正校准过的模型上,不是随便拿个开源小模型截 logits 就能凑合的。
真实场景里,它被拿去干了什么
① 游戏微操(最直观的演示)
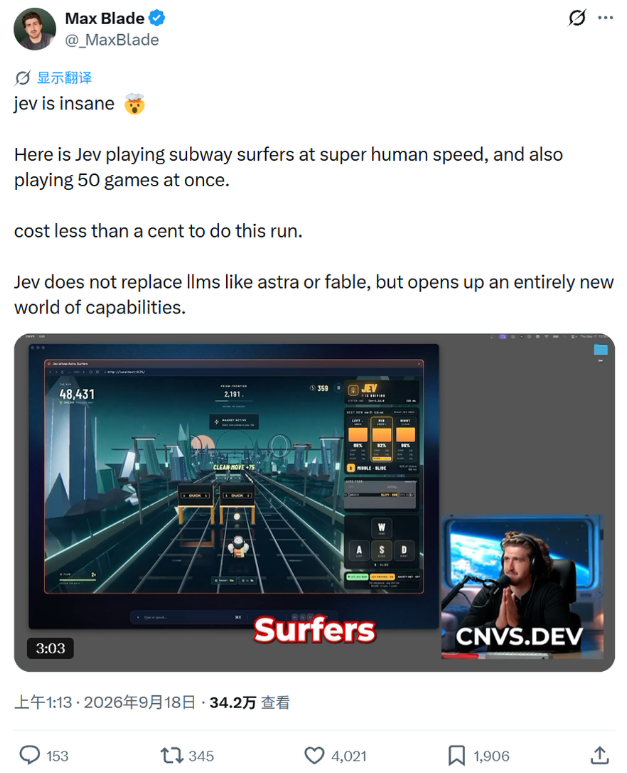
在一次社区延迟演示里,Jev 12 秒里做了约 47 次操作决策(折算每秒近 4 次),同一时间几个主流大模型只做了两三次判断。50 局地铁跑酷同时开跑,全程费用不到 1 美分。
② 浏览器自动化
把网页可点击元素编号列成清单喂给它,让它挑下一步点哪个,7 秒能把整个流程点完;遇到需要打字的地方再叫一个生成模型补位。
③ 内容批量标注
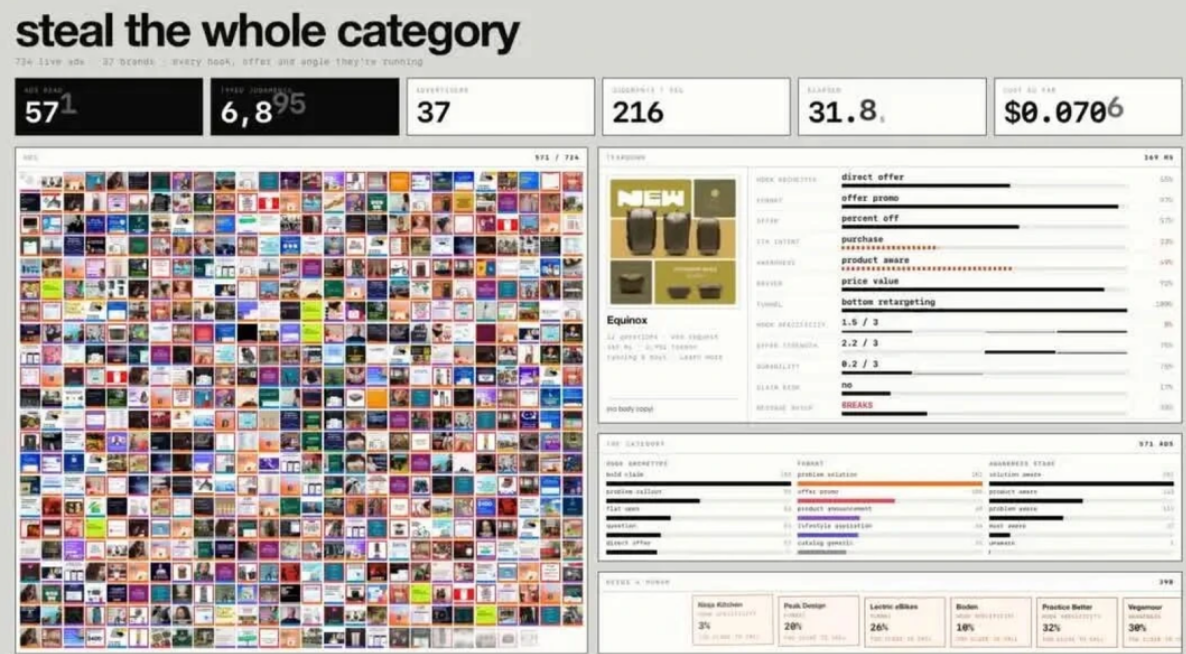
有人把 37 个品牌 724 条广告文案,40 秒内按分类、评分、卖点打完标签,费用 9 美分——这种批量结构化打标的活儿,以前靠大模型跑一遍要贵得多、慢得多。
它的边界在哪
- 没有中间推理:单步前向决定了它没有思维链。面对需要多层因果推导的场景(比如识别伪装成正常邮件的高级钓鱼),支持思维链的模型判断得明显更准,Jev 容易漏判。
- 轻微的选项顺序敏感:独立测试显示,重排选项大约会让 4% 的决策结果改变、整体准确率下降 1.5 到 2 个百分点,但它并没有干净的首位/末位位置偏差,所以设计 Prompt 时更稳妥的做法是把关键依据放进共享上下文。
- 吃干净的结论,不吃噪音:往 state 里塞太多无关信息会干扰判断、拉低准确率。这个模型吃的是你写清楚的结论,不是自己去推——指望它从一堆噪音里自己拎出重点,会失望。
- 未开源:架构目前没有开源,外界只能靠逆向复现摸个大概,想本地部署暂时没门。
- 不是精度冠军:它也不是全场精度最高的判断类模型——性价比是它的卖点,不是精度冠军。
这件事有意思的地方不是又多了一个模型,是生成和判断第一次被拆成了两条产品线。以前 AI 每次出场都得先开口说话,现在有团队赌的是机器不需要开口——人不在场时,软件自己问,模型自己判,这或许也是Jev模型能爆火的原因之一。
 AI 速览