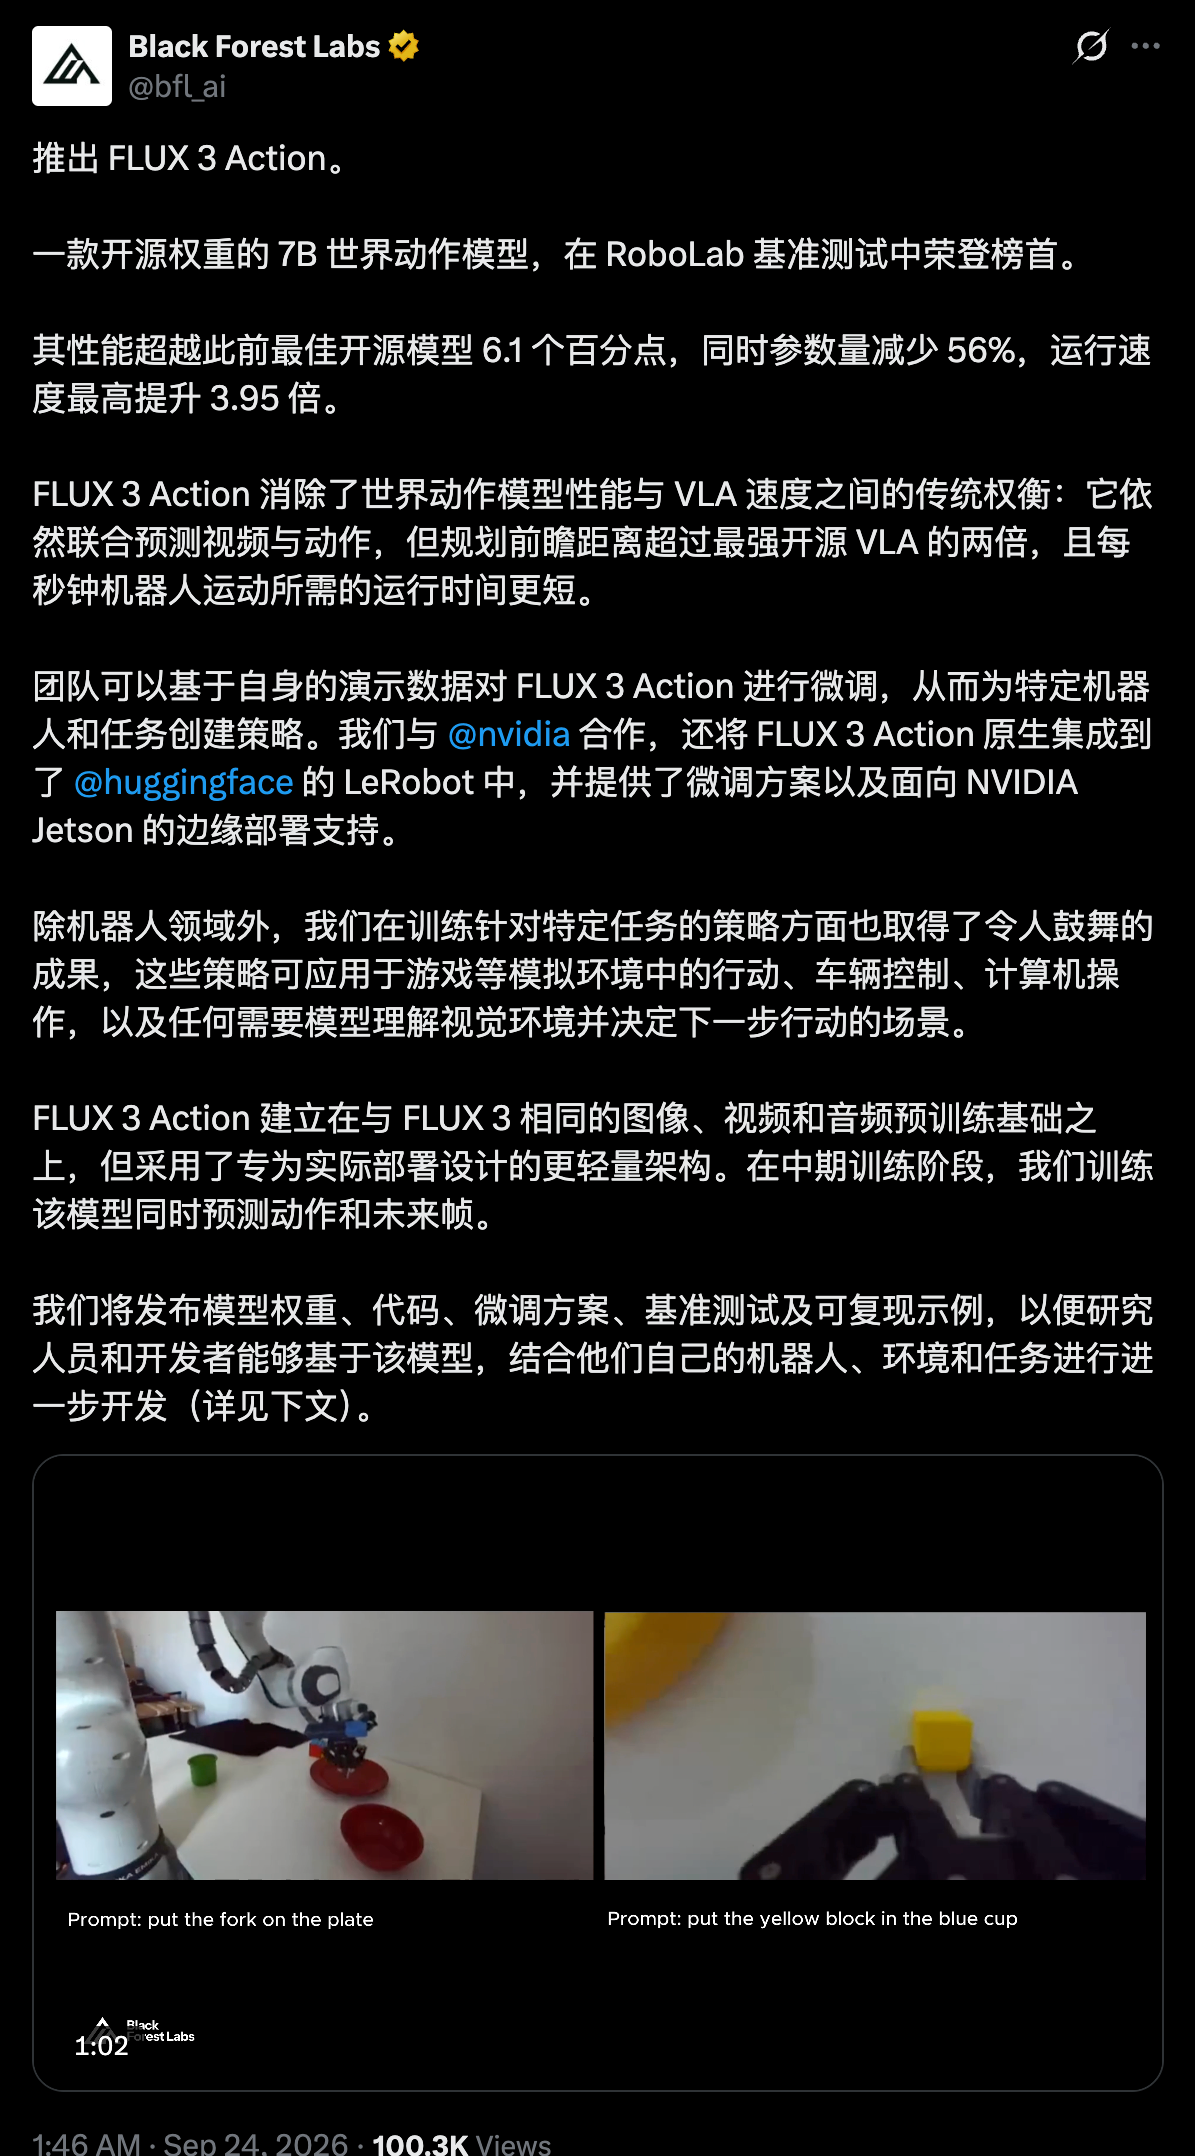
9月24日消息,Black Forest Labs(BFL)发布开源权重的 7B 世界动作模型 FLUX 3 Action,权重与技术报告同步公开。官方技术报告称,该模型在 NVIDIA 仿真基准 RoboLab-120 上成功率 42.92%,比此前最佳开源模型高 6.1 个百分点,目前仍是公司自测口径。
成功率超过 16B 对手,参数不到一半
官方报告给出的核心对照是 NVIDIA 的 Cosmos 3 Nano。在 RoboLab-120 的 120 个仿真任务上,FLUX 3 Action 成功率 42.92%,Cosmos 3 Nano 为 36.8%。后者参数 16B,前者只有 7B。FP8 精度下,FLUX 3 Action 的推理速度是 Cosmos 3 Nano 的 1.52 至 3.95 倍。
世界动作模型(WAM)同时预测未来视频和机器人动作。按报告说法,这条路线此前准确但昂贵:Cosmos 3 Nano 每秒机器人动作所需处理时间约为最强开源 VLA 模型 π0.5 的 4.7 倍,而选 VLA 要放弃近四分之一的成功任务。FLUX 3 Action 的单步蒸馏版成功率 38.3%,仍高于 Cosmos 3 Nano;在工作站和数据中心 GPU 上,它比 π0.5 快 1.34 至 2.28 倍。它单次预测覆盖 2.13 秒动作,π0.5 为 1.0 秒。引导蒸馏版把成功率进一步提到 42.2%。
这组对照有一个限定:在 RTX 5090 这类消费级 GPU 上,单步版反而比 π0.5 慢 1.15 至 2.42 倍。报告没有解释原因。
真机盲测 30 次尝试成功 28 次
根据官方报告,BFL 委托 Positronic Robotics 在其实验室做了真机评测。Franka 机械臂执行 10 个 DROID 任务,每个任务 3 次尝试,操作员不知道每次尝试由哪个模型驱动。FLUX 3 Action 成功 28 次(93.3%)。同场的 Cosmos 3 Nano 成功 27 次,DreamZero 20 次,π0.5 13 次。
报告还披露,BFL 用同一套微调方法在 SO-101 机械臂上做了验证:用遥操作采集一个小数据集微调后,模型能完成训练分布内的任务,并泛化到未见过的物体、容器和相机位姿。
预训练把骨干减半,蒸馏把采样压到单步
报告把结果归因于两处改动。一处是 Self-Flow 多模态预训练:训练 token 中视频占 95% 以上,让 7B 骨干拿到足够强的表征。另一处是蒸馏:引导蒸馏把原本需要两次前向传播的引导过程压进单个学生模型,成功率不降反升 0.6 至 1.08 个百分点;步数蒸馏再把采样压到单步。
与推理模型分工,每成功成本 8.77 美元
报告复现了 Su 等人 2026 年的协议。GPT 6 Astra 在其中充当推理智能体,把控制委托给 FLUX 3 Action 或 π0.5,只在需要时介入修正动作。低推理挡下,F3A 混合策略成功率 90%。每成功成本 8.77 美元,耗时 8 分 08 秒。纯推理最高挡能把成功率做到 100%,但每成功成本 13.47 美元,耗时 16 分 23 秒。π0.5 混合策略的最好成绩是 12.28 美元。
FLUX 3 Action 单独运行时每次成功成本约 0.09 美元,但在这个基准里的成功率为 48%,复杂任务仍需要推理模型接管。快速策略越好,系统需要调用推理的次数越少。对搭建具身智能系统的人来说,可靠性和成本之间的折衷位置,会随动作模型的进步而移动。报告把方向写成一句话:用必要的推理,也只用必要的推理。
模型权重已在 Hugging Face 公开并接入 LeRobot,NVIDIA 协助完成了 Jetson 边缘部署适配。报告还把游戏列为动作预测的下一个试验田,指向 computer-use 等低延迟智能体。
 AI 速览