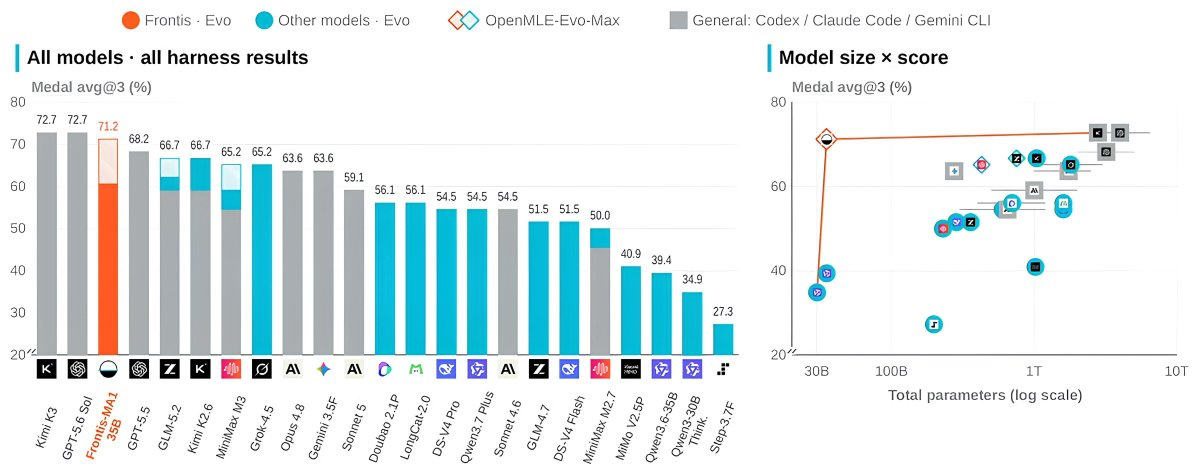
- 衔远科技(Frontis.AI)与清华大学相关团队开源 Frontis-MA1,一个面向“AI 改进 AI”(AI4AI)的元进化智能体;35B 权重与完整 OpenMLE 技术栈以 CC BY-NC 4.0(非商用)开源。
- 在 MLE-Bench Lite 的 22 个任务上(单卡 RTX 4090、12GB 显存、每任务 12 小时),Frontis-MA1-35B 相对基座 Qwen3.6-35B-A3B 把奖牌率从 39.39% 提到 60.61%,配合 OpenMLE-Evo-Max 达到 71.21%,超过 GPT-5.5+Codex 的 68.18%,接近 GPT-5.6 Sol 与 Kimi K3 的 72.73%。
- 核心机制是四个原子算子(Draft、Improve、Debug、Crossover):同一套算子既用于执行接地的后训练,也用于长程进化搜索,构成学习—执行—进化闭环。
- Human Rank 从基座的 0.5828 升至 0.7647,配 Evo-Max 达 0.8126。
- NatureBench Lite 迁移实验显示两条提升路径各自有效:换模型 Match-SOTA 从 50% 到 70%,换搜索框架从 20% 到 50%。
- 使用边界要先看清:71.21% 是模型加搜索框架的系统成绩,不是模型单次生成的分数;许可证非商用;作者明确表示这只是可执行域上的元进化,不等于解决了通用 RSI。
Frontis-MA1 是什么:把“AI 改进 AI”缩成一个可打分的循环
“AI 改进 AI”听上去玄,Frontis-MA1 的做法是把它缩小成一个工程问题:给智能体一份数据、任务说明、评价指标和有限算力,让它自己完成数据检查与验证集划分、特征处理、模型选择、训练调参,最后提交预测并由隐藏测试打分。这个场景就是机器学习工程(MLE),也是递归自我改进(RSI)研究里少有的既能真实运行、又能客观打分的试验场。
输入输出链路因此很清楚:输入是任务包和算力预算,输出是一份能通过隐藏测试的提交。团队为此建了 OpenMLE-Gym,构造出 5758 个质量门控的可执行任务,覆盖表格、图像、时序、文本、音频、视频等模态。评测基准对齐 Kaggle 竞赛文化,用“奖牌率”(Medal Average)计分——拿到铜牌以上算过,这正是 MLE-Bench 系列的口径。
核心技术:四个算子,打通后训练与搜索
这项工作真正的结构创新,是把后训练和推理时搜索对齐到同一组动作上。论文定义了四个原子算子:Draft 从零写完整方案,Improve 根据分数和执行证据改进父程序,Debug 修复跑不通或提交失败的代码,Crossover 把两个父方案的有效部分重组。
训练侧,这四个算子构成执行接地的后训练数据:先做 SFT,再做强化学习,奖励来自真实运行结果而不是文本相似度,且训练数据对所有评测基准做了去重——论文在三处明确写了排除 MLE-Bench 相关来源,防止刷题。搜索侧,同一套算子被组装成长程进化搜索 OpenMLE-Evo:模型反复执行“写、改、修、杂交”,由分数和执行证据引导搜索树生长。
在 Evo 之上还有 Evo-Max 配置,加了两样东西:与评测隔离的跨任务经验先验,以及异步搜索(总沙箱算力不变,把等待时间填满)。两类增益要分开看——换上训练后的模型,奖牌率从 39.39% 到 60.61%,是后训练贡献的约 21 个百分点;再叠上 Evo-Max 搜索,到 71.21%。Human Rank 的爬升路径类似:0.5828、0.7647、0.8126。对照实验里,30B 的复现版(基于 Qwen3-30B-A3B-Thinking-2507)同样有效,从 34.85% 升到 53.03%,Evo-Max 下到 66.67%,说明方法不挑基座。
适用场景与效果边界
适用的一侧:表格、图像、时序、文本、音频、视频的多模态 MLE 任务都在任务集覆盖内,NatureBench Lite 的留出实验显示模型与框架都有跨域迁移——框架固定换模型,Match-SOTA 从 50% 到 70%;模型固定换框架,从 20% 到 50%。换句话说,提升不完全是刷竞赛题刷出来的。
边界也要如实列。第一,71.21% 是训练后模型加增强搜索的系统成绩,官方对比的 GPT-5.5+Codex、GPT-5.6 Sol、Kimi K3 也都是系统口径,但如果你想拿 35B 模型单次生成方案,数字会明显低于此。第二,许可证是 CC BY-NC 4.0,整库级非商用,商业使用未被授权。第三,5758 个任务里只有 1415 个随仓库发布完整数据,其余 4343 个只发布脚本,受授权限制。第四,中文社区对它有评测口径的讨论空间(比如自建任务集与自家评测的绑定),目前独立第三方复现还少,社区讨论整体不多,这是研究发布初期的常态缺口。第五,作者自己也写明:这是可执行域上的元进化,不等于已经解决通用 RSI。
快速上手:拉权重,跑通冒烟测试
需要的东西都在四个地址:论文在 arXiv(2607.28568),代码在 GitHub 的 FrontisAI/OpenRSI 仓库,权重在 Hugging Face 的 FrontisAI 集合下(35B 与 30B 均有 BF16 权重和 GGUF 衍生版),任务与 SFT 轨迹作为数据集分发。
前置环境是 Python 3.12 的 venv 加 conda,各组件(Gym、SFT、RL、Evo)独立运行、各有自己的 README,没有统一的顶层命令。最小验证路径是克隆 NatureBench 任务集,设置主键后跑本地冒烟脚本:
冒烟通过说明执行与评测链路是通的。常见失败点有两个:模型权重、任务工件和语料与源码是分开分发的,只克隆仓库跑不了完整实验;部分组件依赖 SGLang 端点做推理服务,直接裸跑会报连接错误。
生态定位:衔远与清华的 RSI 叙事
按中文科技媒体报道,这项工作由衔远科技(Frontis.AI)与清华大学相关团队完成,论文作者 24 人,包括周伯文(Bowen Zhou)、张开颜(Kaiyan Zhang)、一作杨峻麟(Junlin Yang)与姜澈(Che Jiang);报道称项目负责人包括杨峻麟与姜澈,通讯作者为张开颜。研究被放在“从进化、自进化到元进化,走向递归自我改进”的叙事里,衔远被描述为在“AI 造 AI”方向上的持续投入。
对谁有用:想在自家任务上搭自动 ML 工程管线的团队,可以直接复用 OpenMLE-Gym 的任务规范和执行沙箱;研究 RSI 的人,得到的是一套可执行、可打分、可复现的实验底座。它不提供的是开箱即用的产品能力,而且非商用许可把商业落地挡在了外面。
把递归自我改进这种长期愿景,缩小到一个单卡消费级 GPU 上能跑、能复现、能被第三方打分的循环——这是 Frontis-MA1 最实在的贡献。至于从可执行域推广到通用智能的自我改进,论文自己没有下这个结论,读者也不必替它下。
 AI 速览