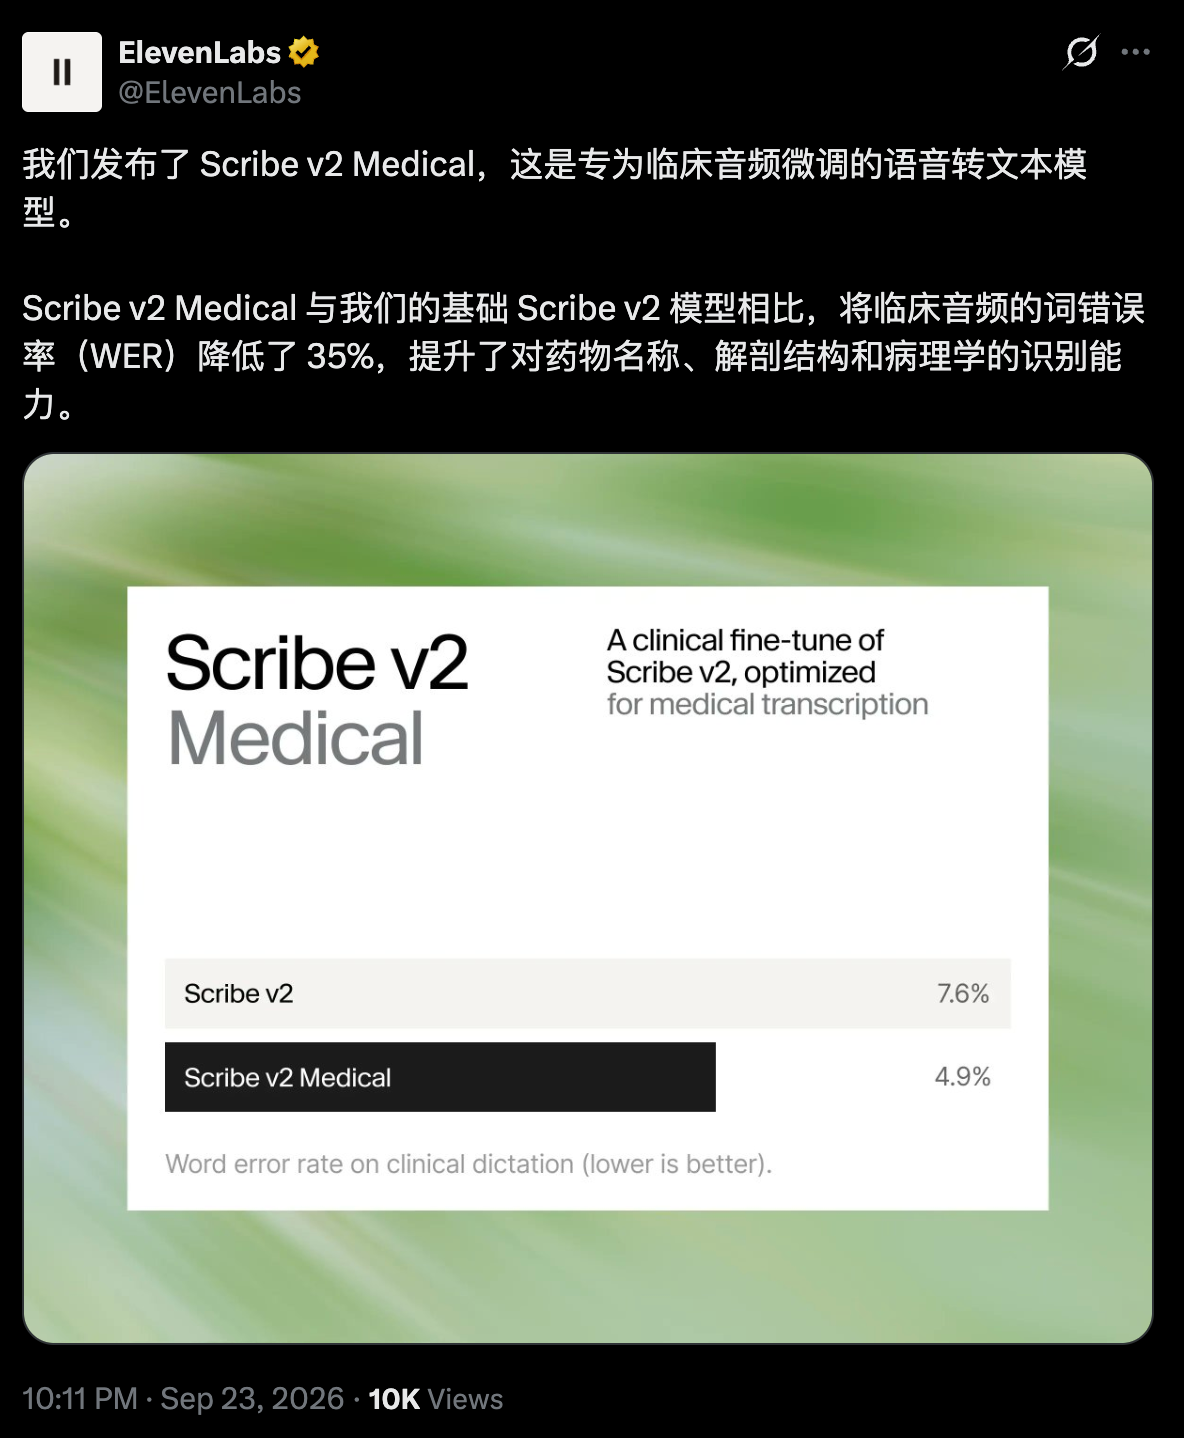
9月24日消息,ElevenLabs 的医疗语音转文本模型 Scribe v2 Medical 正式可用,通过 ElevenLabs API 的批量转写端点调用。在公开临床口述数据集 MedDictate 上,它的整体词错误率为 4.9%,基础版 Scribe v2 为 7.6%,降幅约 35%。
临床基准词错率 4.9%,术语召回率 77.7%
ElevenLabs 公布的测试显示,该模型在 MedDictate 基准上的整体词错误率为 4.9%,基础版 Scribe v2 为 7.6%。词错误率(WER)指转写中错误词的比例。MedDictate 由医疗 AI 公司 Corti 发布。内容是英语、法语和德语的口述临床笔记,药名、剂量和单位密集出现。Scribe v2 Medical 的英语词错率为 3.0%。法语和德语分别为 8.3% 和 7.2%。对照模型中,OpenAI GPT Transcribe 整体词错率 5.9%,Deepgram Nova-3 Medical 仅测英语,为 5.5%。
在医学术语基准 MedTerm 上,该模型术语召回率 77.7%,术语词错率 10.4%,两项均领先同场模型。MedTerm 同样由 Corti 发布,含 600 条带术语标注的样本。Eka Medical ASR 基准含 3619 条英语临床音频。在该基准上,Scribe v2 Medical 语义词错率 6.5%,OpenAI GPT Transcribe 为 13.9%。数字虽来自厂商自测,三个基准本身公开可复现,医疗机构选型时可以自行验证,不必只凭厂商口径。
孤立药名仍最难,企业版支持 HIPAA 合规
官方也公布了短板。在 Eka 基准中,单独念出、没有上下文的药名对所有上榜模型都是最难的场景。Scribe v2 Medical 在这类片段上词错率升到 14.3%,句中则为 7.5%。官方举例,非甾体抗炎药 etodolac 曾被听成 "It'll do the luck"。缓解办法是关键术语提示(keyterm prompting),即在转写前把药名等术语预先提供给模型。
已有客户在生产环境使用。CareCo 首席执行官 Mendel Erlenwein 在发布稿中称:"自从从 Deepgram 切换到 ElevenLabs Scribe v2 Medical,我们在临床术语上的准确率明显提高,团队的工作方式也随之改变。"
合规方面,签署商业伙伴协议并启用零留存模式的企业客户符合 HIPAA 要求。HIPAA 即美国《健康保险流通与责任法案》,规范患者健康信息的处理。零留存模式下,音频输入和转写文本在每次请求完成后即刻删除,ElevenLabs 不作保留。另据公司测试,医疗微调不影响通用语音表现,日常语音词错率 5.3%,与基础版持平。该模型通过 ElevenLabs 语音转文本 API 的批量转写端点调用。定价未随发布公布。
 AI 速览