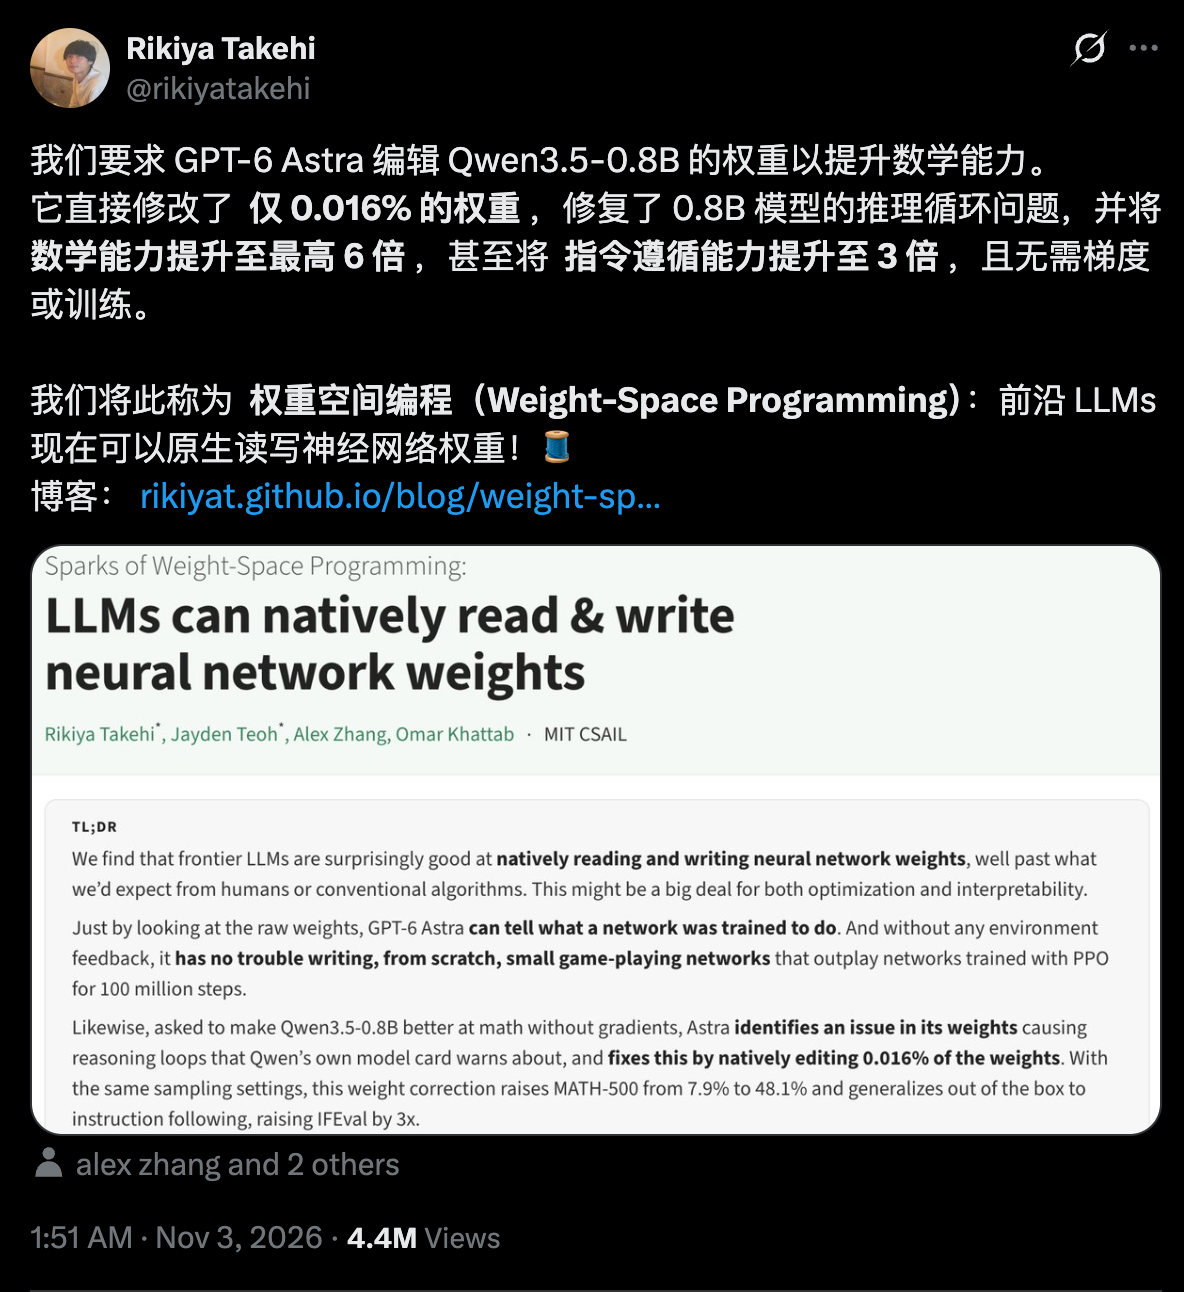
11月3日消息,MIT CSAIL 博士生 Rikiya Takehi 等人发布权重空间编程研究。共同作者包括 Jayden Teoh、Alex Zhang 和 Omar Khattab。研究博客报告了 GPT-6 Astra 直接读取和修改神经网络权重的实验。
通用模型直接读取和写入权重
作者把这种方法称为 Weight-Space Programming,即通用大模型围绕自然语言目标读取或写入神经网络权重,不通过优化器,也不使用梯度下降。
在小网络实验中,Astra 从 17,253 个原始权重判断网络训练时玩的游戏。在 Kinetix 控制任务中,它一次修改 3.5% 权重。原本无法越过坡道的小车随后在 1024 次测试中都成功。作者还测试了从零生成游戏网络,以及只根据中间层权重判断小型语言模型的训练语料。
这些实验的网络规模、可用工具和反馈预算不同,不能合并成一个通用成功率。它们共同支持的是作者提出的研究方向:通用模型不只修改提示词或训练代码,也开始直接操作权重。
Qwen 修改了 0.016% 权重
在语言模型实验中,Astra 面对约有 8 亿权重的 Qwen3.5-0.8B。模型权重无法全部放入上下文,Astra 通过一个加载了权重的 Python kernel 读取和保存张量。它还利用练习题获得前向传播反馈,但实验不允许训练或梯度信息。
作者先测试 10 次和 25 次前向传播预算,随后增加到 50 次。每次前向传播可让模型回答最多 512 道练习题,或读取最多 1024 段文本。这些前向传播不是训练批次。练习题来自 GSM8K 和 MATH 的训练集,Astra 没有接触测试集。
Astra 将重复推理循环定位到第 15 和第 19 层 MLP 写入的一个方向。它从每层 64 个输出列中减去该方向。修改共涉及 131,072 个权重,占模型权重的 0.016%。
在 50 次前向传播预算下,编辑后的 Qwen 在 MATH-500 上从 7.9% 升至 48.1%。GSM8K 从 13.8% 升至 67.1%。IFEval 从 21.0% 升至 62.3%。达到 32,768 token 上限的 MATH-500 回答比例则从 93.0% 降至 33.1%。
提升主要来自解除重复循环
Qwen 原模型在数学回答中经常重复同一段文本,无法给出最终答案。作者记录的前 96 个练习回答中,有 85 个达到 token 上限。权重修改减少循环后,模型能够完成更多原本就可能回答的问题。
因此,作者没有把结果解释为模型获得了新的数学知识。编辑主要移除了阻碍已有能力表现出来的问题,同时改善了数学和指令遵循。
另一项实验支持这种克制解释。Gemma 3 270M 很少出现循环,只有 8.5% 的回答达到 token 上限。Astra 阅读其错误后发现的是普通算术和代数推理错误,没有一个可以统一关闭的组件。多次编辑后,Gemma 的 MATH-500 变化都没有超过约一个百分点,作者也未认定这些变化构成可靠提升。
这组对照说明,权重编辑在这组实验中消除了一个具体故障,但没有证明它能为模型添加原本缺少的能力。
实验日志已经公开
作者认为,这项工作的特点在于使用通用前沿模型直接处理权重,而不是训练一个专门读取权重的模型,或让训练算法完成写入。机制可解释性、事实知识编辑和无梯度优化已有不同研究路径,研究博客没有给出与这些方法的成本或效果横评。
研究也仍有明确限制。大模型权重需要借助工具处理,前向传播预算影响结果,作者尚在建设统一基准和测试框架。现有实验没有证明递归自我改进,也没有证明权重编辑优于常规微调。
作者已公开各实验的完整日志,包括发送给 Astra 的内容、运行代码、网络与评测记录;编辑后的 Qwen3.5-0.8B 也已在 Hugging Face 提供。
 AI 速览