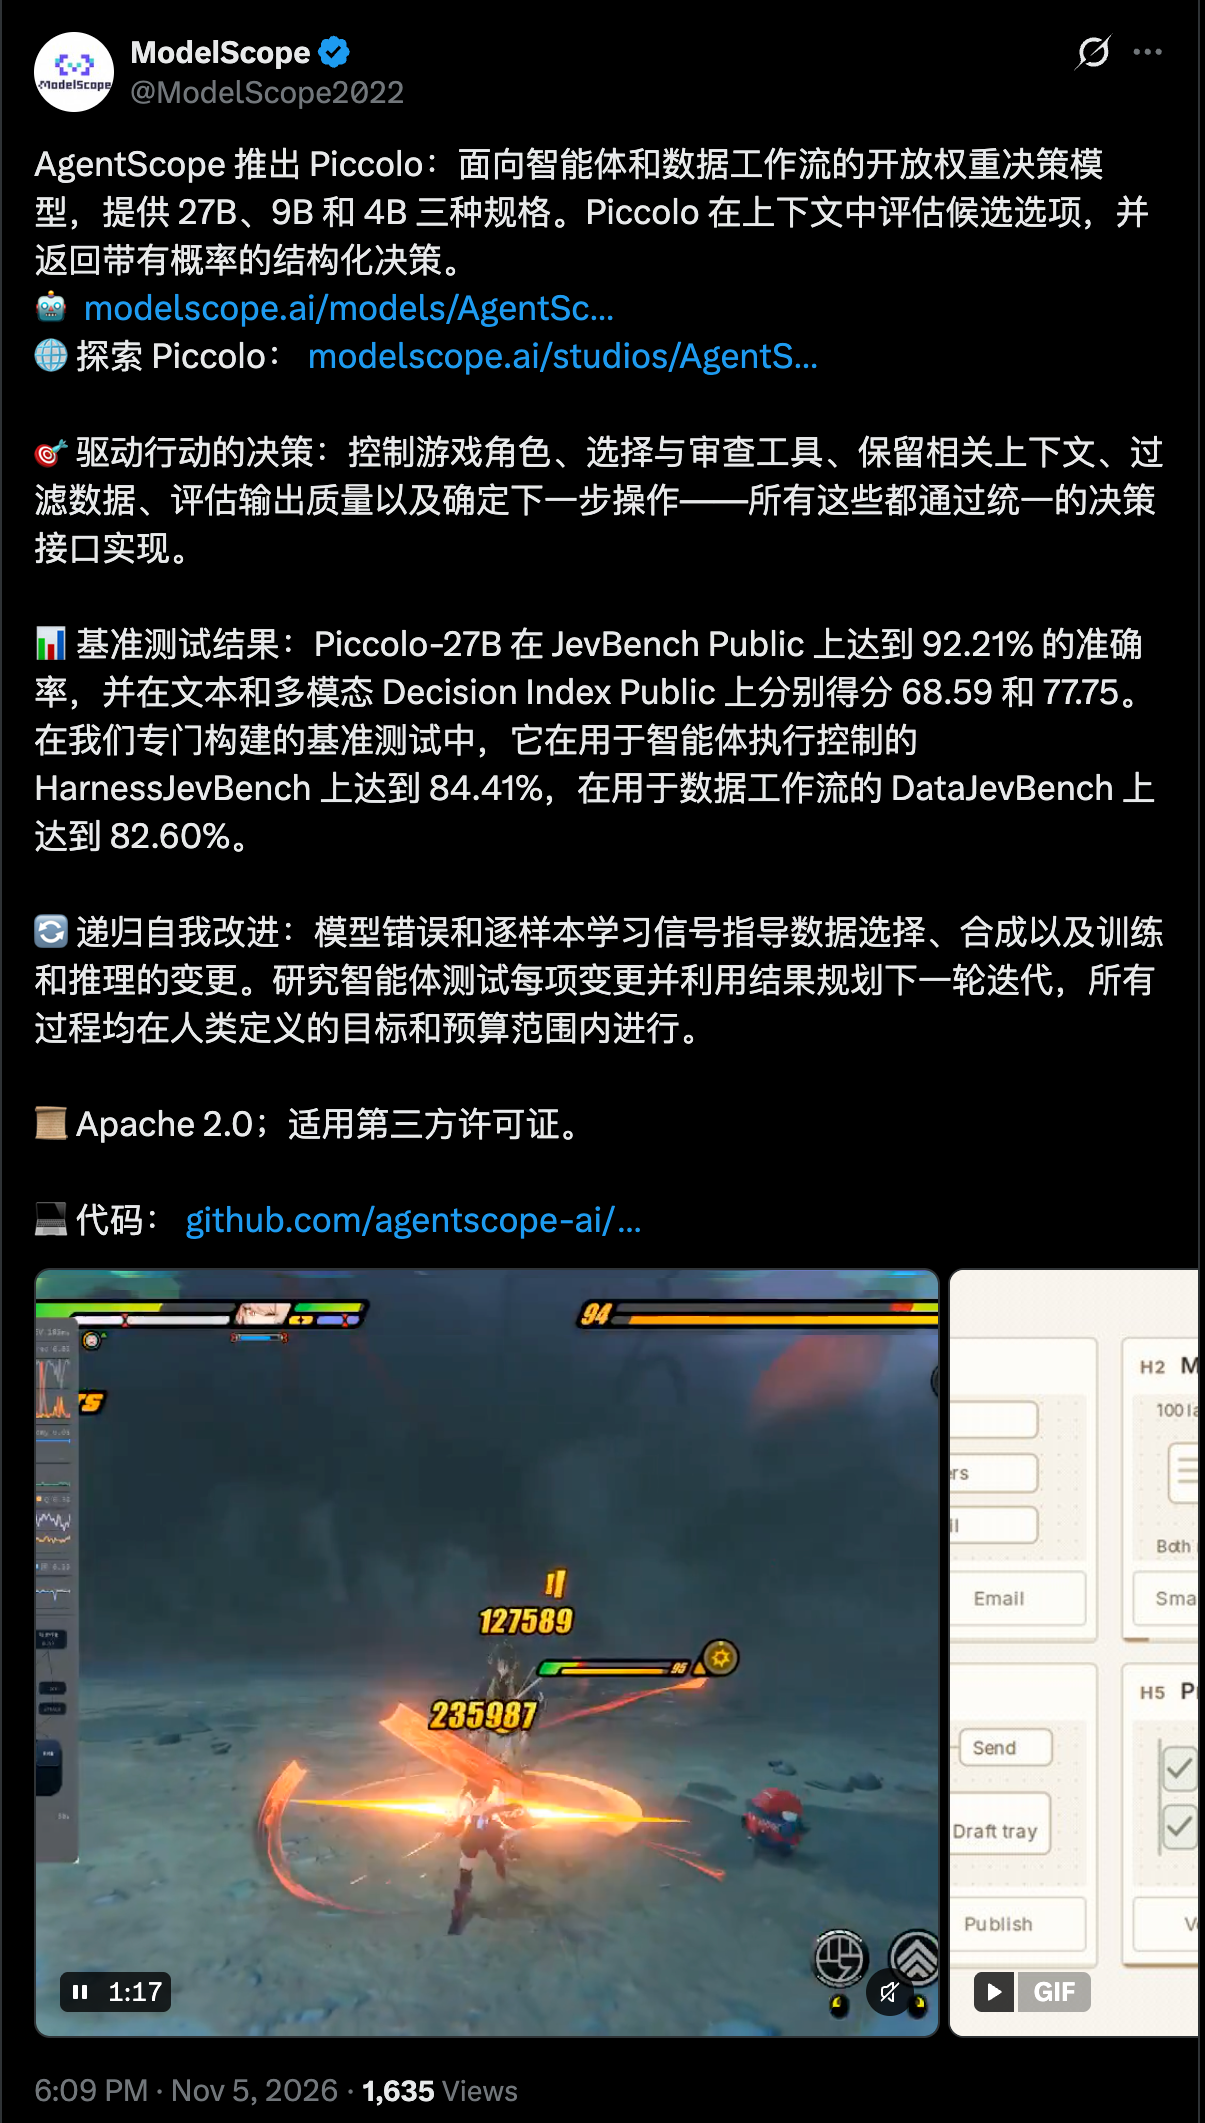
11月6日消息,AgentScope 发布 Piccolo 决策模型系列,提供 4B、9B 和 27B 三种规格。完整权重及多种 GGUF 格式已在 Hugging Face 和 ModelScope 开放。代码与模型采用 Apache 2.0。
Piccolo 面向智能体和数据工作流。它接收当前状态、问题和候选项,返回结构化决策与候选概率,而不是生成一段聊天回答。
决策接口不生成解释文本
通用聊天模型可以先写一段分析,再由程序提取答案。Piccolo 跳过这段自由文本,直接读取单 token 候选项的 logits,并归一化为概率。
训练与推理使用同一套输入模板和候选映射。模型在全注意力层采用双向 prompt attention,并保留线性注意力层的原有计算。原生接口返回选择、二元判断或有序评分。
这种分工让主对话模型继续负责理解任务和生成内容,Piccolo 只处理当前判断。程序可以依据概率和固定阈值决定放行、请求人工审批,或保留某段历史原文。
普通 chat completion 接口并不实现这套决策契约。开发者需要使用配套推理协议和运行时,不能把模型当成普通聊天模型直接调用。
训练围绕数据反馈迭代
Piccolo 的训练材料来自 665 万条原始来源记录,覆盖分类、检索、数理推理、偏好判断和工具使用。材料被统一为状态、问题、候选项和目标分布。
硬标签表示确定选择,软标签保留评分、偏好和判断分歧。数据治理还处理重复、答案依据、候选差异、位置偏置和训练评测重叠。
标签体系包含 13 个标注维度和 551 个预定义取值。团队根据每个切片的学习速度、偏差和波动,决定回放、复核、补充或调整数据配比。
Agent 参与方案设计、数据构建和实验比较,人类则给出目标、预算与数据使用范围。每轮训练反馈再进入下一轮配方,而不是一次性收集完数据就结束。
四项评测分别对应不同决策任务
Piccolo-27B 在 JevBench Public 上的准确率为 92.21%。它在 Decision Index Public 上为 68.59 分。9B 和 4B 的 JevBench Public 准确率分别为 89.61% 和 87.01%。
HarnessJevBench 面向工具执行、资源调度、上下文管理和权限边界。27B 在 Hard 子集上的准确率为 84.41%。
DataJevBench 面向数据准入、处理方案、产物质量和任务控制。该版本包含 500 道中英文任务,Piccolo-27B 答对 413 道,准确率为 82.60%。
这些分数描述的是决策任务,不是通用聊天、知识或编码能力。评测还同时观察概率分布,避免只看最终选项是否正确。全部结果仍属于项目方公布的评测。
QwenPaw 将决策接入本地工作流
QwenPaw 已接入 Piccolo,主要覆盖工具审核和上下文压缩。工具执行前,系统会收集工具名称、操作类型、目标参数、沙箱状态和已有风险信号。
决策模型随后判断操作影响、数据破坏、敏感信息暴露和权限变化。程序依据固定阈值决定是否请求人工审批,原有权限规则和人工确认回退仍然生效。
上下文压缩则判断一份工具结果接下来是否还会用到。需要保留的原文可以绕开普通摘要,减少订单号、报错细节和具体数值被删掉的概率。
用户可以本地下载 BF16、Q8_0 或 Q4_K_M 版本。启动模型与启用审核、压缩是独立步骤,本地运行时一次只管理一个决策模型。
因此,Piccolo 并没有替代主对话模型或权限系统。它把反复出现的候选判断交给专用模型,再把执行权留给规则和人工审批。完整权重、推理说明和本地接入指南已经公开。
 AI 速览