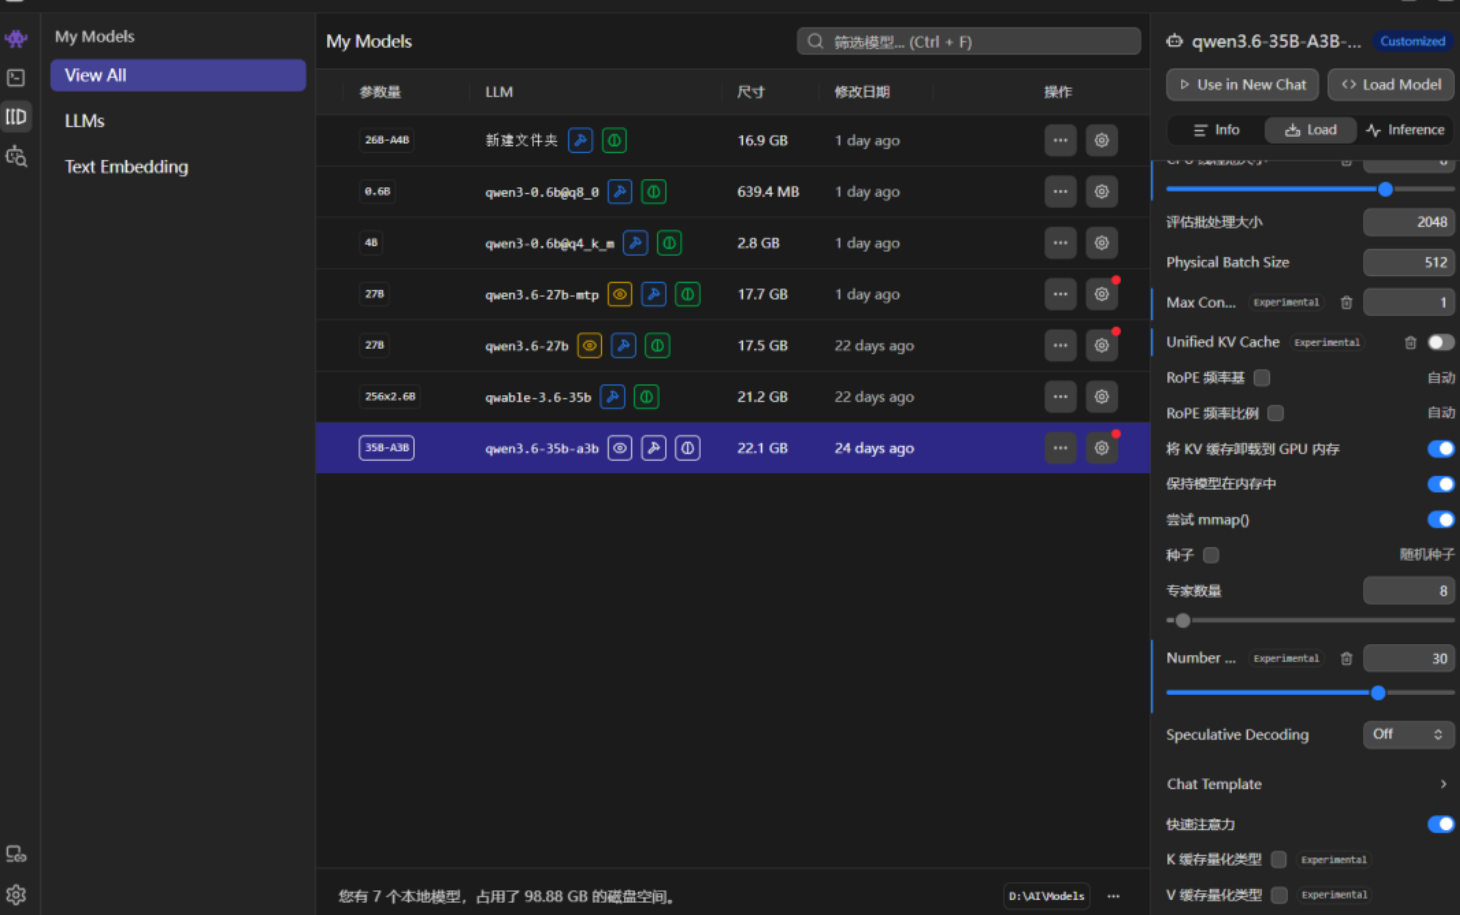
能部署的范围比多数人想的大。它只认两种格式:GGUF 和 MLX,前者跨平台,后者只跑在 Apple Silicon 上。只要 Hugging Face 上有这两个格式的文件,理论上都能装进来跑。官方模型目录里现成打包好的有 49 个本地模型、9 个云端模型,从 270M 的 FunctionGemma 到 480B 的 Qwen3-Coder 都在其中。
LM Studio能部署哪些模型
先分清三条路径,它们能拿到的东西不一样。
| | |
|---|
| 官方打包好的 49 个本地模型,已配好提示词模板与加载参数 | |
| 任意 GGUF / MLX 模型,可粘贴仓库地址直接下 | |
| | |
第一条最省事。目录里每个模型都是一份 model.yaml,把同一模型的 GGUF 和 MLX 多个变体收在一个条目下,选模型时不用管底层是什么格式,参数、上下文长度、是否支持视觉都写在里面。
第二条是真正的边界。应用内置下载器直连 Hugging Face,可以按关键词搜,也可以直接粘仓库路径或整条 URL。这一步能拿到的东西远超目录,代价是提示词模板、停止词、工具调用格式可能要自己调。
第三条用命令行:lms import path/to/model.gguf。手工放也行,目录结构是 ~/.lmstudio/models/发布者/模型名/文件.gguf,三层不能少。放错层级的典型现象是应用里看得到文件夹、看不到模型。
如果目标是服务器或 CI,不必装图形界面。LM Studio 把核心拆成了独立守护进程 llmster,官方提供一行安装命令(macOS 与 Linux 用 curl -fsSL https://lmstudio.ai/install.sh | bash),之后 lms daemon up 起服务、lms server start 开端口。桌面版、守护进程、命令行三者共用同一套模型目录和 runtime,模型能力一致,区别只在有没有界面。
GGUF和MLX差在哪
格式决定了引擎,引擎决定了你能跑在哪台机器上。这两套权重不能互换,同一个模型两套都下就是双份磁盘占用。
选哪个不用纠结太久:Mac 用户优先 MLX,同等参数量下速度和内存效率通常更好;Windows 和 Linux 只有 GGUF 一条路;Mac 上想用 GGUF 特有的量化档位或某个只有 GGUF 的冷门模型,也能退回去跑 llama.cpp。
下载时看到的 Q3_K_S、Q4_K_M、Q8_0 是量化档位。数字越小文件越小、质量损失越大。官方建议 4bit 起步,机器撑得住就往上加。Q2、Q3 在长文推理和代码任务上掉得比较明显,省下来的那几个 GB 通常不值。
官方目录里的49个本地模型
目录按能力打了三个标签:工具调用、推理、视觉。分类看下来,覆盖面是这样的:
| |
|---|
| Qwen3.8 27B、Gemma 4 5.1B/7.9B、GLM-4.7 30B、Nemotron 3 Super 120B、Laguna S 2.1 118B |
| Qwen3-Coder 30B/480B、Qwen3-Coder-Next 80B、Devstral 2 24B/123B、Codestral 22B、Flint 40B、seed-oss 36B |
| Qwen3-VL 2B/4B、GLM-4.6V-Flash 9B、qwen2.5-vl 3B/7B、Ministral 3、Magistral、olmOCR 2 7B |
| FunctionGemma 270M、LFM2 350M/700M、gemma-3 270M、LFM3 2B |
| Qwen3-Coder 480B、minimax-m2 230B、Nemotron 3.5 Super VL 120B |
| Mistral 7B、mistral-nemo 12B、phi-4 3B/14B、deepseek-r1 7B/8B、Granite 4.0 与 4.1、Olmo 3 |
几个值得单独提的:olmOCR 2 是 7B 的文档识别模型,专门啃扫描件和 PDF 版面,比通用视觉模型在表格还原上更准。FunctionGemma 只有 270M,塞进树莓派级别的设备都行,但只能干结构化输出这类窄活。Devstral 2 的 123B 版本和 Qwen3-Coder 的 480B 版本属于"能下但不好跑"的类型,后者 Q4 量化后权重就接近 270GB。
云端那 9 个(GLM-5.3、Kimi K3、DeepSeek V4 系列、Beam 501B 等)只能通过 Secure Cloud 调用,本地下载不了。它们的定位是给跑不动大模型的机器兜底,按 token 计费,需要账号绑账单。 llama.cpp支持多少种模型架构
LM Studio 的本地推理基于 llama.cpp,所以"能跑哪些架构"这个问题可以直接查上游。主干代码里当前登记了 172 个架构标识(其中一个是量化工具专用的占位项),主流家族基本齐了:
| |
|---|
| llama、llama4、deci、stablelm |
| qwen、qwen2、qwen3、qwen3moe、qwen3next、qwen3vl、qwen35、qwen4exp、qwen3tts |
| deepseek、deepseek2、deepseek32、deepseek4、deepseek41、deepseek2-ocr |
| chatglm、glm4、glm4moe、glm-dsa、glm5-next |
| gemma 到 gemma4、gemma3n、gemma-embedding、gemma-embedding2 |
| mistral3、mistral4、mistral-large4(Codestral、Magistral、Devstral 复用 mistral 或 llama 架构) |
| gpt2、gptj、gptneox、gpt-oss |
| kimi-linear、kimi-k3、kimi-k31 |
| minimax-01、minimax-m2、minimax-m3 |
| baichuan、internlm2、minicpm、ernie4_5、hunyuan-moe、step35、bailingmoe、xing4_0 |
| mamba、mamba2、jamba、falcon-h1、rwkv6、rwkv7、granitehybrid |
| bert、nomic-bert、jina-bert-v2/v3、eurobert、modern-bert、llama-embed |
| t5、bloom、mpt、dbrx、command-r、cohere2、arctic、exaone、olmo、plamo、bitnet |
注意这个数字是 llama.cpp 主干的,不等于你手上那个 LM Studio 版本立刻全支持。应用里的推理能力以"扩展包"形式分发,更新日志显示 2026 年 11 月初的版本带的是 llama.cpp 2.67.0。新架构发布后,通常要等扩展包跟上。遇到"这个模型加载失败、提示架构不支持",先检查更新,而不是怀疑文件坏了。
你的机器能跑多大的模型
官方给的最低门槛不高:macOS 要 14.0 以上且必须是 Apple Silicon(Intel Mac 至今不支持),Windows 支持 x64 与 ARM(Snapdragon X Elite),x64 要求 CPU 有 AVX2,Linux 只发 AppImage、Ubuntu 20.04 起。内存建议 16GB,GPU 至少 4GB 显存,不够就靠 CPU 卸载顶着跑。
真正决定"能跑多大"的是显存和内存。按 Q4 量化估算,占用大概是这个量级:
8B 那一行不是拍的:官方 model.yaml 示例里给 Qwen3-8B 标的 minMemoryUsageBytes 正好是 4,600,000,000,也就是 4.6GB。其余行按同比例推算,属于估算值。
还有一个常被忽略的变量:上下文长度。KV 缓存是额外开销,8B 模型开到 32K 上下文,可能再多占三到五个 GB。表格只算了权重,实际配内存时按 1.3 倍留余量比较稳。MoE 模型是例外,激活参数少但权重全要加载,230B 的 minimax-m2 不会因为只激活 10B 就省下 120GB。
LM Studio跑不了哪些模型
边界比想象中清楚,踩坑多半出在下面几条:
原始 transformers 权重不能直接加载。Hugging Face 上大量模型仓库给的是 fp16/fp8 的 safetensors,那是给 vLLM、Transformers 用的。LM Studio 认的 safetensors 是 MLX 格式那一套,两者不通用。想跑得先转成 GGUF 或 MLX。
Intel Mac 全系不支持。官方在系统要求页写得很明确,只留了一个收集需求的入口。
需要张量并行的超大模型没法拆。单机能装多少就跑多少,没有跨机分布式推理这条路。480B 那种模型,普通工作站就是加载不动。
训练和微调不在功能范围里。它只做推理,要微调得换别的工具链。
云端专属模型下不到本地。目录里标 Cloud 的那 9 个,权重不对外提供,只能通过 Secure Cloud 按 token 付费调用。
部署模型的注意事项
- Mac 别下 GGUF 又下 MLX:同一模型两套权重是双份磁盘,且引擎不能互换,切换时得重新加载。选一套就够。
- 目录层级不能少一层:必须是 ~/.lmstudio/models/发布者/模型名/文件,少一层应用就扫不出来,文件明明在硬盘上却显示没有模型。
- 视觉模型要配套的投影文件:只下主权重会变成纯文本模型,能加载但读不了图。下载时看清包里有没有 mmproj 一类文件。
- 上下文开太大反而崩:KV 缓存吃的是同一块显存,开到模型训练长度上限,8B 模型在 16GB 机器上会直接 OOM。先用 8K 试,稳了再往上加。
- Q2/Q3 慎用:体积是小了一半,但代码补全和长链推理的稳定性掉得厉害。显存不够时,降上下文比降量化更划算。
- 架构支持跟着扩展包走:新模型加载报架构不支持,先更新应用再看,别急着转格式。
- AMD 显卡分平台:Linux 走 ROCm,Windows 走 Vulkan,性能差一截。同一张卡换系统,速度可能不一样。
- 云端模式不是本地的:切到 Secure Cloud 后请求离开本机,本地部署的隐私前提在这个模式下不成立,敏感材料注意别误切。
LM Studio常见问题
Q:LM Studio 能部署哪些模型?
A:GGUF 和 MLX 两种格式的都能。官方目录现成打包了 49 个本地模型,Hugging Face 上任意 GGUF/MLX 也能直接搜来下。
Q:能跑 safetensors 吗?
A:只能跑 MLX 格式的 safetensors。Hugging Face 上给 Transformers 用的原始权重不行,得先转 GGUF 或 MLX。
Q:Intel 的 Mac 能用吗?
A:不能。官方要求 Apple Silicon 加 macOS 14.0 以上,Intel Mac 至今没有支持计划。
Q:16GB 内存能跑多大的模型?
A:Q4 量化下 8B 舒服,14B 勉强,30B 起要 32GB。上下文开到 32K 还要再留几个 GB。
Q:为什么下载的模型加载不了?
A:三种常见原因:格式不对(是原始权重不是 GGUF/MLX)、架构太新(扩展包没跟上)、文件不完整。先看报错里有没有提架构名。
Q:能同时加载多个模型吗?
A:能,但受内存限制。两个 8B 模型在 16GB 机器上已经很紧,实际用起来更常见的是一个对话模型加一个小嵌入模型。
Q:支持视觉模型吗?
A:支持。Qwen3-VL、GLM-4.6V-Flash、qwen2.5-vl、olmOCR 2 这些都在目录里,能直接读图,前提是权重包含视觉投影文件。
Q:有嵌入模型吗?
A:有。模型目录已经收录嵌入与决策模型,API 也提供 /v1/embeddings 端点,可以本地搭检索。
Q:跑本地模型要付费吗?
A:本地推理不收费,官方称个人与工作用途都可免费使用。只有云端那 9 个模型按 token 计费。
把选择收成一句:Mac 优先 MLX,Windows 和 Linux 只有 GGUF,格式定了之后剩下的就是算内存。LM Studio 能部署哪些模型,答案的一半在 llama.cpp 的架构表里,另一半在你机器的显存里。模型目录和 runtime 版本更新都快,这一篇会跟着官方更新继续补。
 AI 速览