加载失败就那么几种,先看清是哪一种再动手。模型文件不对、运行时没装、显存和上下文不够、系统压根不支持,这四类覆盖了官方 bug tracker 里绝大多数报告。重装应用解决不了其中任何一类,反而会把排查线索一起清掉。
LM Studio无法加载本地模型
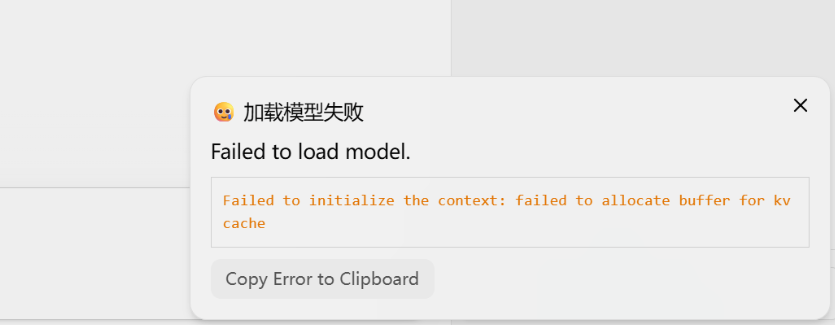
LM Studio 自己不做推理。它把权重交给下面的引擎,GGUF 走 llama.cpp,MLX 走 Apple 那套框架。所谓加载,是把磁盘上的权重读进内存、按上下文长度分配 KV cache、再拉起一个引擎进程。任何一步走不通,界面上都只弹一句 Failed to load model。
这句话本身不含信息。有用的是它出现在哪一步,四种表现对应四组完全不同的原因。
最容易被误判成“软件坏了”的,是文件本身。
先确认模型文件本身有没有问题
官方要求的目录是三层,一层都不能少:
丢在 models 根目录、少一层发布者文件夹、或者文件夹里套着解压出来的子目录,都会出现“文件明明在那儿,应用里看不到”。lms ls 能确认它到底扫到了什么,输出里带参数量、架构和体积三项,跟 Hugging Face 页面对一下就知道差在哪。
格式只有两种能进:GGUF 和 MLX。Hugging Face 上 fp16 的 safetensors 是给 transformers、vLLM 那类框架用的,LM Studio 读不了,得先量化成 GGUF。.bin、.pth、.ckpt 同理。这块每年都有人踩,原因是模型页面的文件列表里 safetensors 往往排在最前面,看着像默认选项。
完整性看文件头四个字节。GGUF 文件的第一行就是 GGUF 四个字母:
打印出 GGUF 才算数。打印出 <!DO 或者 PK,说明拿到的是网页或者压缩包,常见于挂着代理、被镜像站拦截、或者直接右键另存。
分片模型少一片也加载不了。名字带 -00001-of-00003 这种后缀的,三个文件必须都在同一目录,改名也不行。
从 Ollama 那儿拷过来的文件通常没有 .gguf 后缀。Ollama 的 blobs 目录里存的是 sha256 开头的无扩展名文件,LM Studio 按扩展名扫,扫不到。这不算文件坏了,重新下载或者改名后 lms import 都能接上。
运行时与模型架构不匹配
运行时是独立下载的组件,不跟应用一起装。设置里按 Ctrl Shift R(Mac 用 Cmd Shift R)打开运行时管理,或者用 lms runtime ls 查。一个都没装的时候,报错原文是这一句:
No LM Runtime found for model format 'gguf'!
这条最好认,装上就行。
装了但版本旧,报的是架构不认识,形如 unknown model architecture: 'xxx' 或者 Model type xxx not supported.。官方 tracker 里这类报告有明显的时间规律,新模型发布后的一到两周集中冒出来。Qwen3.8-Flash-Next 的 qwen4_exp 架构、gemma4-assistant、还有误把 flux 的图像模型当语言模型下的,走的都是这条路。llama.cpp 合并支持到 LM Studio 打包下发之间有时差,lms runtime update 或手动换最新运行时能解决一部分,剩下的只能等。
还有一类不是版本问题,是硬件。Windows 上报错里带 0xc000001d,或者只写 No compatible runtimes,那不是模型的事,是 CPU 缺少 AVX2 指令集。官方系统要求写得很明确:x64 平台要求 AVX2。2013 年之前的至强、部分低功耗赛扬、以及被虚拟化平台屏蔽了指令集的云主机,都过不了这一关。
显存与上下文超出上限
权重放得下、KV cache 放不下,是“进度条走完又掉回未加载”最常见的原因。这两个东西要分开算。
权重看量化等级。Q4_K_M 大约每十亿参数 0.6GB,8B 约 4.7GB,27B 约 16GB,70B 约 40GB。
KV cache 看上下文长度。以 Llama 3 8B 为例,32 层、8 个 KV 头、每头 128 维、FP16 存储,每 token 约 128KB。8K 上下文就是 1GB,32K 是 4GB,128K 直接到 16GB。层数和头数更多的模型,这个数还要往上翻。
官方 CLI 有个不用真加载就能测的开关:lms load --estimate-only 模型名。文档里的例子是 gpt-oss-120b 估到 65.68GB。这个估算已经把上下文、flash attention、是否视觉模型都算进去了,比手算可靠。
界面上的护栏弹窗也有绕过的办法,按钮写 Load anyway,强行加载。强行加载的结果通常是跑起来慢十倍,或者跑到一半被系统杀掉,不值当。
真要挤显存,四个旋钮按性价比排:先把 GPU offload 从 max 往下拉,让部分层留在内存里;再把上下文砍到实际需要的一半;然后开 KV cache 量化,也就是 llamaKCacheQuantizationType 那组参数,前提是 flash attention 已经打开;最后关掉 keepModelInMemory,它是拿内存换速度的选项,紧张的时候先牺牲它。
mmap 是另一回事。它让系统把文件按需映射进内存,模型比内存大时反而更慢,但往往能“加载成功”。开关叫 tryMmap,值得单独试一次。
系统与驱动层面的限制
这几条是硬门槛,没有绕法。
| | |
|---|
| Apple Silicon,系统 13.4 起,MLX 模型要 14.0 | Intel Mac 全系不支持,装上也没有可用运行时 |
| | |
| | |
| AppImage 包,Ubuntu 20.04 起 | |
macOS 版本这一条,官方两处口径不一样:文档正文写 13.4 起,现行系统要求页写 14.0 起。装之前按高的那个准备,比较稳。
显卡驱动是 Windows 上另一类常见原因。CUDA 运行时要求驱动版本匹配,驱动太旧时引擎加载会失败,报错往往只给一个 exit code,看不出所以然。处理办法不是重装 LM Studio,是更新显卡驱动;临时可以切到 Vulkan 或纯 CPU 跑一次,确认模型本身没问题。
磁盘空间也要留。权重之外,解压和格式转换需要临时空间。剩余几百 MB 的时候,很容易出现“下载完成但加载失败”,而下载记录看起来完全正常。
报错原文对应的处理动作
按报错原文查。
| | |
|---|
No LM Runtime found for model format 'gguf' | | |
No compatible runtimes 或 0xc000001d | | |
unknown model architecture: 'xxx' | | lms runtime update,或等官方支持 |
Model type xxx not supported | | |
Model loading was stopped due to insufficient system resources | | |
unable to allocate backend buffer | | |
Failed to load model(Exit code: null) | | |
| | |
按顺序排查的六步
- 看清单。跑 lms ls,确认模型在列表里,架构和体积与 Hugging Face 页面一致。不在列表就直接回到目录结构那一节。
- 验文件头。head -c 4 模型.gguf,输出必须是 GGUF。
- 看运行时。lms runtime ls,一个都没有就先装,有多个就试着切一个。
- 看估算。lms load --estimate-only 模型名,把估算显存和自己卡上的可用量对一下。
- 抓日志。lms log stream --source server 从 0.3.26 起支持,界面只给一句 Failed to load model 的时候,真实原因在这一行里。
- 做二分。把 GPU offload 设成 0、上下文设成 2048 再加载。能成功说明文件和运行时都没问题,问题在资源分配;还是失败,问题在文件或运行时。
第六步是整个排查里最省时间的一步。它把四类原因一刀切成两半,剩下的只是在对的那一半里找。
加载失败后要避开的做法
- 别急着重装。重装不会补上运行时,也不会换掉不支持 AVX2 的 CPU,只会把日志一起清掉。
- 别把上下文拉满。模型标称的上下文往往是训练长度,KV cache 按这个值预分配,普通显卡扛不住。
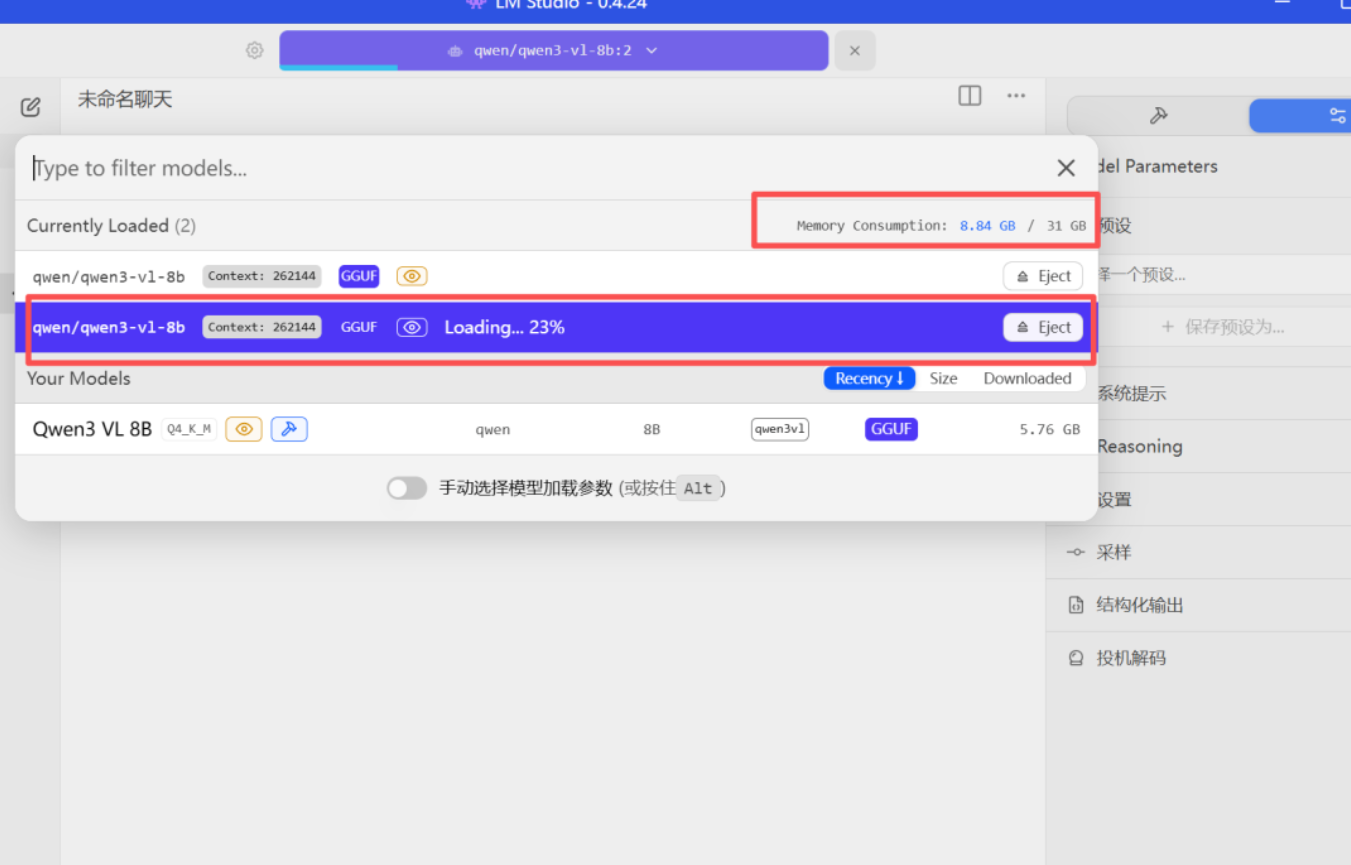
- 别同时挂两个模型。各自占一份显存,第二个大概率失败,第一个也可能被挤掉。
- 别用浏览器另存权重。没有断点续传,也没有完整性校验,文件头一验就露。
- 别拷 Ollama 的 blobs 目录。无扩展名文件扫不出来,改名加后缀才有机会被识别。
- 别在 Intel Mac 上折腾。官方明确不支持,转成 GGUF 也没用。
- 别盯着 exit code 猜。它只是进程退出码,同一个码能对应好几种原因,去日志里找报错行。
LM Studio加载失败常见问题
Q:模型能加载,但回答全是乱码?
A:先验文件头,再换一个官方目录里的同款模型对照。两个都乱码是模板或分词器的问题,只有一个乱码是文件截断。
Q:加载完几秒钟自己卸载了?
A:权重放得下、KV cache 放不下。把上下文降到 4K 试一次;走服务器模式的话,还要看 TTL 和 auto-evict 有没有把模型踢掉。
Q:同一个模型 Ollama 能跑,LM Studio 不行?
A:引擎是同一个,差在默认值。Ollama 通常给的上下文更小、offload 策略更保守,照着它的参数调一遍就能对上。
Q:能加载比显存大的模型吗?
A:能。GPU offload 拉到 50% 左右,一部分层留在内存里,速度会掉得厉害,但跑得起来。
Q:加载一般要多久?
A:看磁盘和体积。SSD 上 8B 十几秒,70B 从机械盘读要几分钟,第一次加载之后系统有缓存会快一些。
Q:刚下载的模型为什么列表里没有?
A:三种可能,目录少了发布者那一层、文件不是 .gguf 结尾、分片没下全。用 lms ls 看实际扫到了什么最快。
Q:加载失败会扣费吗?
A:本地模型不涉及费用。云端模型按 token 计费,加载失败没产生 token,不计费。
Q:能让一部分层跑 GPU、一部分跑 CPU 吗?
A:可以,GPU offload 支持 0 到 1 之间的任意比例,命令行用 lms load --gpu 0.5。
Q:视觉模型加载成功,一传图就报错?
A:多模态模型需要额外的 mmproj 文件,同一目录里缺了它,模型会退化成纯文本,传图直接失败。
四类原因对应四组动作,把 lms ls、--estimate-only 和日志这三条命令记住,LM Studio 无法加载本地模型这件事就不用再靠猜。想跟进运行时的支持列表和新架构的下发节奏,可以关注本站的 AI 工具栏目,有变化我们会同步更新。
 AI 速览