kimi哪个模型好没有统一答案,要看你是聊天、写代码还是长文档。2026 年官方主力已换到 K3 系列,K3.1 Pro 综合能力最强、K3 性价比最高;老牌 K2 系列年底退场。下面按场景拆解各档 Kimi 模型的强弱与定价。 kimi 现在有哪些模型,先列清单
月之暗面的 Kimi 不是一个模型,而是一组同门产品线,共享品牌但定位不同。2026 年官方主线是 K3 系列,向下兼容仍在运行的 K2 系列,外加面向长文档的 Kimi Plus 和早期的 K1.5。把清单铺开,才知道每档该用在哪。
表里七档不必全用。普通用户认准 K3 系足够,开发者再按场景细分,K2 系注意它正在退场。
消费端和开发端入口不同。网页与 App 默认免费起步,重度使用才有付费档;开发走开放平台按 token 结算。两种入口背后模型由官方统一滚动升级,普通用户不必纠结版本号。
综合实力最强:K3.1 Pro 与 K3
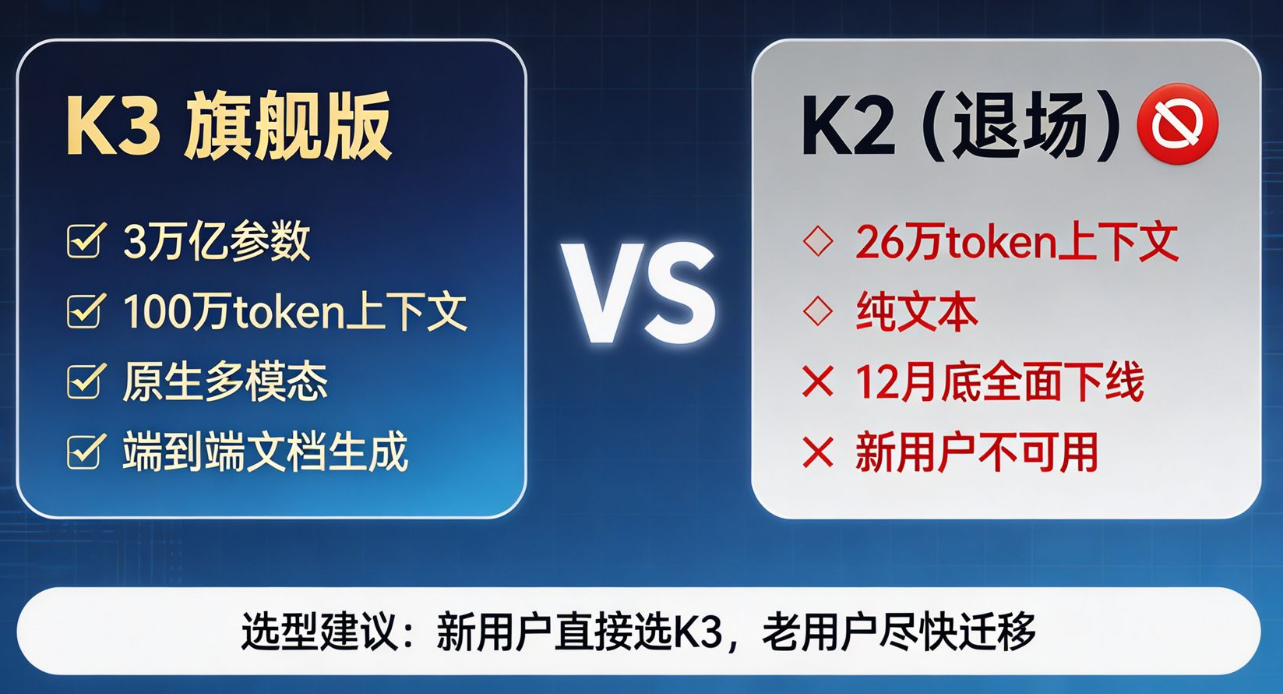
K3 系列是 2026 年官方主力,K3 于同年 7 月发布,总参数 2.8 万亿,原生多模态,上下文拉到 100 万 token,相当于一次读进近百万字材料。K3.1 Pro 在 K3 基础上进一步拔高综合与复杂任务表现,是当前的综合旗舰;K3 则是同架构里性价比最高的通用档,日常对话、写作、分析都够用。对大多数手机和网页用户,不用自己挑,官方默认把最新旗舰顶上,你体感就是同一个助手。
两者都支持思考模式,遇到算账、排计划、拆解复杂需求时开启,准确性能拉回一截。K3 系与 K2 系相比,最大变化是上下文从 26 万涨到 100 万,且原生支持图像与视频输入,长材料不用切块拼接。
K3.1 Pro 另有机高速版,响应更快但输入输出都更贵,适合对延迟敏感的生产调用;普通创作和问答用标准版即可。多媒体输入让它能直接看图和视频,做图文理解、视频要点提炼不必先转文字。
写代码选哪个:K2.7 Code 与 K2.6
如果你主要用 Kimi 干活是写程序,认准 K2.7 Code。官方把它标成迄今最智能的 Coding 模型,长上下文里更稳地听指令,编程任务成功率更高;K2.6 也被官方称为最新最智能的通用模型,长程代码与 Agent 自主执行明显增强。不过要注意,K2 家族整体正在退场,新项目更建议直接上 K3 系,编码能力会随版本滚动增强。
单价取自官方平台标价,缓存命中价格更低,写码量大的团队靠缓存就能把账单压下一截。K2 系在编程基准上长期处在开源模型头部,但 K3 系才是官方持续投入的方向。
编码相关的型号在工具调用和自主编程上表现突出,能读整个仓库、跨多文件改写、补测试和调试。对重度工程,把大任务拆给子代理并行处理,比一次性塞进长上下文更稳。
长文档与超长上下文:Kimi Plus 与 K3
读论文、扒长合同、整理会议纪要这类活儿,考验的是上下文长度。K3 系给到 100 万 token,能一次塞进十万字量级材料;面向消费端的 Kimi Plus 进一步把上限放到约 200 万字符,专门服务长文档分析。两者都不用把材料切块拼接,跨多轮聊一个项目也不必反复交代背景。普通用户想读长材料,Plus 或 K3 都稳,重度研究再考虑 Plus 的更长上限。
长文档场景常见误区是以为窗口越大越好。实际要兼顾读取稳定性和费用,材料超过模型稳定上限仍建议先摘要或分段。Kimi Plus 的字符上限和 K3 的 token 上限单位不同,换算时别直接比数字。
推理与思考任务:K2 Thinking 与思考模式
数学题、严密逻辑、研究综述这类不能一口闷的任务,适合带显式推理的模型。K2 Thinking 走思维链那一派,把问题拆开一步步推再给结论,上下文 26 万 token,适合长链路工具调用。K3 系也内置思考模式,日常开启即可。代价是更慢也更贵,所以别拿它刷闲聊,留给真正值得深想的任务,性价比才对。
把推理模型当成放大镜而不是锤子。闲聊、摘要、翻译这类轻活儿用标准模式更快更省;只有数学证明、代码排错、方案推演才值得开思考。开错模式,既慢又烧钱。
老牌 K1.5 还值不值得用
K1.5 是 2025 年初出圈的早期推理模型,支持轻量多模态,上下文 12.8 万 token,但已是闭源旧款。它主要留在 API 兼容老项目,新项目不推荐当主力。若你只是轻度多模态或维护旧集成,还能用;但要综合能力和长上下文,K3 系已经全面接棒。
若你只做轻度图文问答或维护旧版 API 集成,K1.5 仍能跑,但官方已不再把它当主线。新接入的项目直接用 K3 系,长上下文和多模态都更省心,迁移成本也比想象中小。
Kimi 模型怎么计费,是按量不是订阅
开放平台提供的模型推理是按量计费,不是包月订阅,要和会员、Code 产品区分开。计费单元是 token,每消耗一百万 token 为一个计价单位,输入和输出分开算,缓存命中只收缓存价。所以选模型时,除了看能力,还要看单价和你的输入输出比例,长输出任务更吃输出价。
缓存机制值得花心思。重复出现的前缀(如系统提示、固定背景)命中缓存后单价大幅下降,长对话和批量任务靠它省钱最明显。所以同样的模型,用法不同账单能差不少。
不同人群该怎么选
对照表只是起点,真实选型还要看你的输入输出比例和是否需要多模态,别只看榜单。
预算紧的团队可以把高频简单请求路由到 K3 标准档,只把难题交给 K3.1 Pro 或思考模式,这种分层比全量上顶配更划算。自部署则要预留足够显存,万亿级权重即便量化也吃机器。
选模型前先核这九件事
1. K3 系列是 2026 年官方主力,K3.1 Pro 综合能力最强,K3 性价比更高。
2. K2 系列将于 2026 年 10 月 31 日停止新用户开通、年底下线,新项目直接上 K3。
3. 开放平台按量计费,不是订阅制,和会员、Code 产品是不同产品。
4. 写代码优先 K2.7 Code 或 K2.6,但都在迁往 K3 系,长期看 K3 系编码能力。
5. 超长文档用 Kimi Plus(约 200 万字符)或 K3(100 万 token 上下文)更稳。
6. 需要深度推理选带思考模式的 K3 或 K2 Thinking,纯闲聊不必开思考。
7. 同一模型分普通版与高速版,高速版输入输出都更贵。
8. 上下文窗口单位不同,K3 系按 token(100 万),Kimi Plus 按字符(200 万),别直接比数字。
9. 最终模型清单、价格与可用区以 kimi.com 与 platform.moonshot.cn 官方页面实时显示为准。
常见问题
Q:kimi 目前最强的模型是哪个
A:综合以 K3.1 Pro 为顶,编程以 K2.7 Code 为强,深度推理以 K2 Thinking 见长,没有单点通吃的那个,按任务挑最稳。
Q:普通聊天用哪个 kimi 模型最划算
A:大多数用户不用手动挑,官方默认接最新旗舰;想省成本就认 K3,免费起步、通用够用。
Q:写代码用 kimi 哪个模型好
A:首选 K2.7 Code,它是官方标的最强 Coding 模型;长期建议迁到 K3 系,编码能力会持续增强。
Q:kimi K2 是不是要下架了
A:是的。官方公告 K2 系列 2026 年 10 月 31 日停止新用户开通,计划年底下线,已注册用户暂不受影响。
Q:kimi 模型按什么计费,有包月吗
A:开放平台按量计费,不是包月订阅,输入输出分开算,缓存命中更便宜;会员与 Code 产品另算。
Q:kimi K1.5 还能用吗,和 K3 差多少
A:还能用,但它是闭源旧款,主要兼容老项目;综合能力、上下文长度都已由 K3 系接棒。
Q:长文档分析用哪个 kimi 模型
A:Kimi Plus 约 200 万字符上限,或 K3 的 100 万 token 上下文,两者都能一次读进长材料。
Q:手机 App 和网页版用的模型一样吗
A:入口不同但背后模型由官方统一滚动升级,默认都是最新旗舰,体感一致。
Q:选 kimi 模型要看哪些参数
A:看上下文长度、单价与输入输出比例、是否多模态、是否支持思考模式,再结合自己的任务挑。
回到 kimi哪个模型好 这个问题,2026 年普通用户直接选 K3 系就够用,要最强上 K3.1 Pro,写代码先用 K2.7 Code 过渡、再迁 K3,长文档交给 Kimi Plus。看清自己的场景和预算,比追新模型更实在。
 AI 速览