Gemini 4 Neon 和 Opus 5.5 不属于可以互相顶替的两款模型。前者输入 3 美元、输出 15 美元每百万 token,卖点是高频复杂任务下的性价比;后者 4 美元与 20 美元,长在极限难题、成品文档和密集图表读取。两家的发布页都写了“第一”,但用的不是同一把尺子,只按单价挑容易挑错方向。 Neon 和 Opus 5.5 的定位差在哪
Gemini 4 Neon 是谷歌 Gemini 4 家族的中间档。官方博客把 Carbon 放在最难的长期项目上,Hydrogen 负责日常高频调用,Neon 夹在两者中间,11 月 18 日随博客上线,模型 ID 是 gemini-4-neon,只对付费 API 层开放。
Opus 5.5 是 Claude 5.5 家族的第一款,9 月 22 日发布,目前已经被 Anthropic 设为 Pro、Max、Ultra、Team 套餐的默认模型。官方给它的定位是“大多数知识工作的主力”,不是只在难题上出场的那种。 七项硬指标摆在一起,差异很直观:
| | |
|---|
| | |
| Gemini 4 中杯,Carbon 之下、Hydrogen 之上 | |
| | |
| | |
| low / medium / high / xhigh,默认 high | low / medium / high / xhigh / max,默认 medium |
| | |
| | |
两处容易看漏的差别。Neon 的 100 万 token 是输入输出共用一个池子,会话里模型写得多,能塞的输入就少;Opus 5.5 的 100 万是整窗标准价,没有长上下文的加价档。单次输出上,Opus 5.5 官方写明 12.8 万 token,批量接口配 beta 头能到 30 万;Neon 在 AI Studio 模型页标注的单次上限约 6.5 万,长解码场景才放宽。要一次吐完一份长报告、或者整份文件重写,这个差距比单价更影响体验。
每百万 token 单价怎么算
单价看几行就够,其余都是派生出来的:
按输入输出 3:1 的常见比例折算混合价,Neon 是 6 美元,Opus 5.5 是 8 美元。每一条价格档都差四分之一,缓存读也一样,0.15 对 0.20。这个比例很整齐,说明两家在这代产品上用的是同一套结构,只是基准价不同。
缓存这块两家都在想办法压账。谷歌给 Neon 缓存输入打的标签是 95% 折扣;Anthropic 把 Opus 5.5 的缓存读定在基础输入价的 0.05 倍,低于多数 Claude 模型的 0.1 倍。算法不同,效果类似:重复前缀越多,缓存价在总账单里的权重越大,长会话的成本差距会被这一项重新拉开。
还有一个时间点值得记:从公开定价表看,Gemini 4 家族的 Carbon 和 Argon 挂的是 2 美元、10 美元的首发价,12 月 1 日起翻到 4 美元、20 美元,Neon 是这一代唯一没标截止日的平价档。12 月之后它反而成了本家最便宜的高端型号。选型时把这条算进去,结论会和上个月的评测稿不一样。
跑分榜为什么给出相反结论
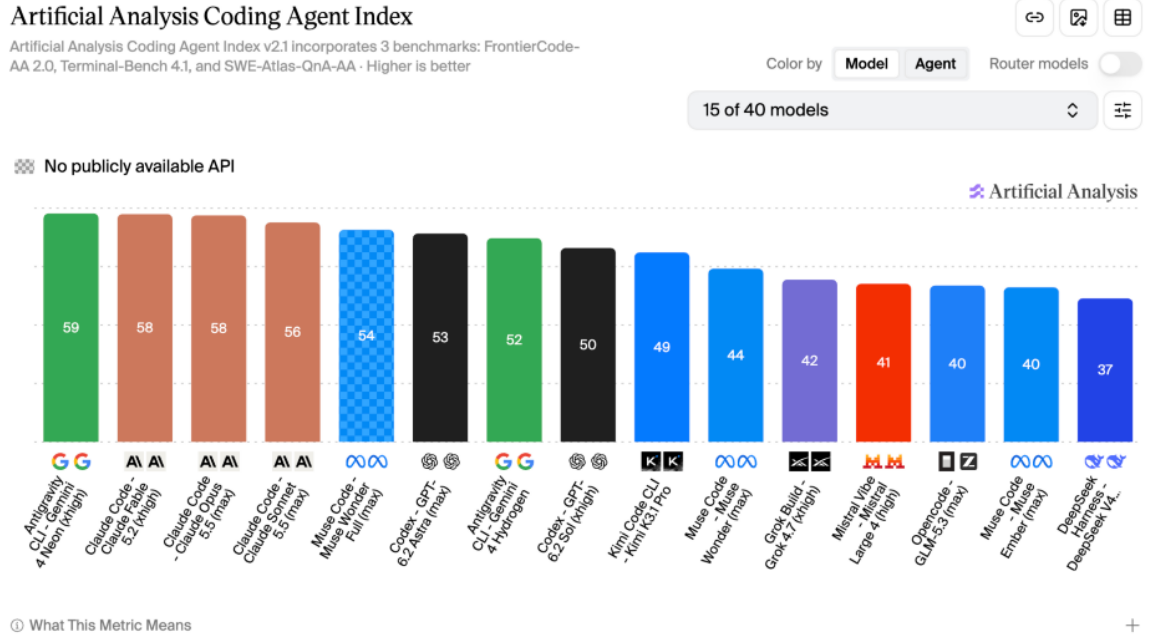
Artificial Analysis 智能指数上,Neon 在 xhigh 档拿 61 分,排第 3,官方措辞是“仅次于更大、更慢的模型”。Opus 5.5 在最高档的同一指数上被记录为 58 分,但那个读数是 9 月底页面上的数据,比 Neon 发布早了两个月,指数版本也更新过几轮。
换个榜单,名次就换人。BenchLeader 自建指数给 Opus 5.5 打 68.5,在 337 个受测配置里排第 3,编程项 80 分、智能体与工具项 62 分。Neon 没有出现在那张榜的单模型页里,硬要横比就是拿苹果对橘子。
厂商自报的数字还得看版本号。Anthropic 公布 Opus 5.5 的 Terminal-Bench 4.0 是 66.4、CursorBench 4.0 是 57.8、OSWorld 2.0 是 81.8、GDPval-AA v2.1 是 1846 Elo。谷歌公布的 Neon 是 Terminal-Bench 4.1 的 65.2、FrontierCode 2.0 的 46.2。4.0 和 4.1 是两个难度的题库,直接相减没有意义。
这张表的正确读法:两边的“第一”各自成立,证明的是不同维度上的领先,推不出谁全面更强。谁把两份发布页并排贴,再拿同一个基准的两个版本比大小,得出的“碾压”结论基本可以当噪音处理。
单任务成本差距从哪来
单价差四分之一,真实账单常常差一倍。Artificial Analysis 的口径下,Opus 5.5 在 max 档跑完一个任务是 5.98 美元,xhigh 档 3.46 美元。谷歌说 Neon 在默认 high 档的每任务成本比自家 Carbon 低 32%,比顶级竞品低 50% 到 80%;AA 自己测 Neon 对 Carbon 是低约 17%。三组数字都对,只是题目难度和步数不一样,每任务成本本来就是三个乘数相乘的结果:单价、步数、每步 token。
思考 token 在两家都按输出价计费,这一项最容易失控。Neon 能降到 low 或 medium 档,把思考量直接掐下去;Opus 5.5 的自适应思考常开,官方写明不可禁用、不能给 token 预算,只能靠 effort 档位往下压。同样一句“帮我看看这段代码”,两者默认花掉的思考量差得很远。
延迟也得计入成本。第三方实测 Neon 的输出速度约 110 token 每秒,同期的 Carbon 约 57 每秒;谷歌官方给的口径是端到端快三倍,两个说法量的是不同的东西,别混着用。Opus 5.5 大约 115 到 120 token 每秒,看着不吃亏,但首字要 3.12 秒,含推理的整答中位数是 714 秒。做交互式产品,用户先感受到的是首字延迟,不是总时长。
按任务类型怎么选模型
把任务按三问过一遍:跑得多不多、难不难、要不要交成品。答案基本能落进下面几档。
- 多文件重构、跨仓库排错:Neon。官方强调手术式编辑,在 Antigravity 里它还能当调度者,指挥 Hydrogen 子代理并行干活。SWE-sweep 在 mini-SWE 环境是 12.8%,换到 Antigravity 环境跳到 39.0%,同一个模型差三倍,说明脚手架有时比型号更决定成败。
- 极限难题与漏洞挖掘:Opus 5.5 的上限更稳。Neon 另开了一条 Neon for Cyber 线,AutoBaxBench 困难档 76%、SEC-bench Pro 90.5% 都是 SOTA,但通过 Fairwind 计划定向开放,普通开发者拿不到。
- 成品文档、表格、幻灯片、读密集图表:Opus 5.5。视觉是这代 Opus 的强项,官方说它在最低 effort 档读密集图表的准确度已经超过上一代最高档。
- 法务、税务、金融检索:Neon。法律检索与税务智能体两项第一,Surge AI 的会计、表格建模类目也大多是第一。
- 高频批量调用:Neon。没有免费 API 层,但 3 美元、15 美元的单价在高频场景里省下来的是真金。
- 一次生成超长文件:Opus 5.5。12.8 万 token 的输出上限比 Neon 宽一倍,整份标的书或长报告不用分段拼接。
迁移时的报错与参数限制
切换前要确认的调用规则
- Neon 不接受旧思考参数:老 Flash 系列的 MINIMAL 档没有对应值,thinking_budget 这类参数不再静默映射,直接返回 400。
- Neon 忽略采样参数:自定义 temperature、top_k、top_p 不生效,frequency_penalty 和 presence_penalty 返回 400。靠调温度控制文风的提示词,迁过来会失效。
- Neon 没有免费层:只对付费层开放,余额为零时调用直接失败,不会降级到别的模型。
- Neon 只出文本:能吃文本、图像、视频、音频和 PDF,但不生成图像和音频,也不在 Live API 上。
- Opus 5.5 默认 effort 从 high 降到 medium:沿用 Opus 5 的调用代码、不显式指定档位,会直接变“懒”。这是从旧版本迁过来最容易误判成“模型变差”的一条。
- Opus 5.5 的思考关不掉:不能禁用,也不能设 token 预算,提示词里写“仔细想想”纯属浪费字数。
- 缓存有最小长度:Opus 5.5 的提示词缓存 512 token 起步,短提示词挂不上缓存优惠。
- 单价、档位与额度会随官方调整,接入前在控制台确认当期标准。
Gemini 4 Neon 常见问题 9 条
Q:Gemini 4 Neon 能免费用吗? A:API 侧没有免费层,只走付费;订阅 Google AI Pro 或 Ultra 的用户可以在 Gemini 应用和 Antigravity 的模型选择器里直接选它。
Q:两者上下文都是 100 万,用起来会一样吗? A:不一样。Neon 的 100 万由输入输出共用一个池子,Opus 5.5 是整窗标准价,长文档灌进去时可用空间更宽松。
Q:AA 指数 Neon 61 比 Opus 58 高,是不是说明 Neon 更强? A:这两个读数不是同一天取的,Opus 5.5 的 58 分来自 9 月底的页面。换一张榜,Opus 5.5 同样能进前三。
Q:写代码到底该选哪个? A:多文件重构和长程任务调度选 Neon,省下的钱能多跑几轮;单点极难题、要求一次做对的活,Opus 5.5 更省心。
Q:中文写作哪个更顺手? A:两家都能写。Opus 5.5 的文风更直白,改稿次数少;Neon 这代写作输出也有升级,胜在便宜,适合批量出初稿。
Q:贵 25% 的 Opus 5.5 值不值? A:看缓存命中率和步数。长会话反复读同一份上下文时,0.20 与 0.15 的缓存价差会放大;而 Opus 5.5 一个中位任务的 17.3 万 token 里,七成花在推理上。
Q:能处理图片和视频吗? A:输入都可以。Neon 支持文本、图像、视频、音频和 PDF,Opus 5.5 支持文本、图像和文件,两者都不输出图像。
Q:有国内可用的替代方案吗? A:预算敏感又不想折腾跨境支付,可以先用 GLM、DeepSeek、豆包这类国产模型把流程跑通,再决定要不要为前沿能力付费。 Q:换模型后代码报错,先查什么? A:先查思考档位参数。Neon 的旧 thinking_budget 和 Opus 5.5 的默认 effort 变化,这两处是迁移后最常见的 400 和“效果变差”来源。
榜单会换版本,单价也会调,但把任务按频率和难度分完之后,Gemini 4 Neon 与 Opus 5.5 各自的位置其实很固定:一个负责把复杂任务跑得又便宜又快,一个负责在最难的那几步上不出错。想跟进这两个系列后续的版本与定价变化,可以关注本站的 AI 工具栏目,有新模型我们会同步更新。
 AI 速览