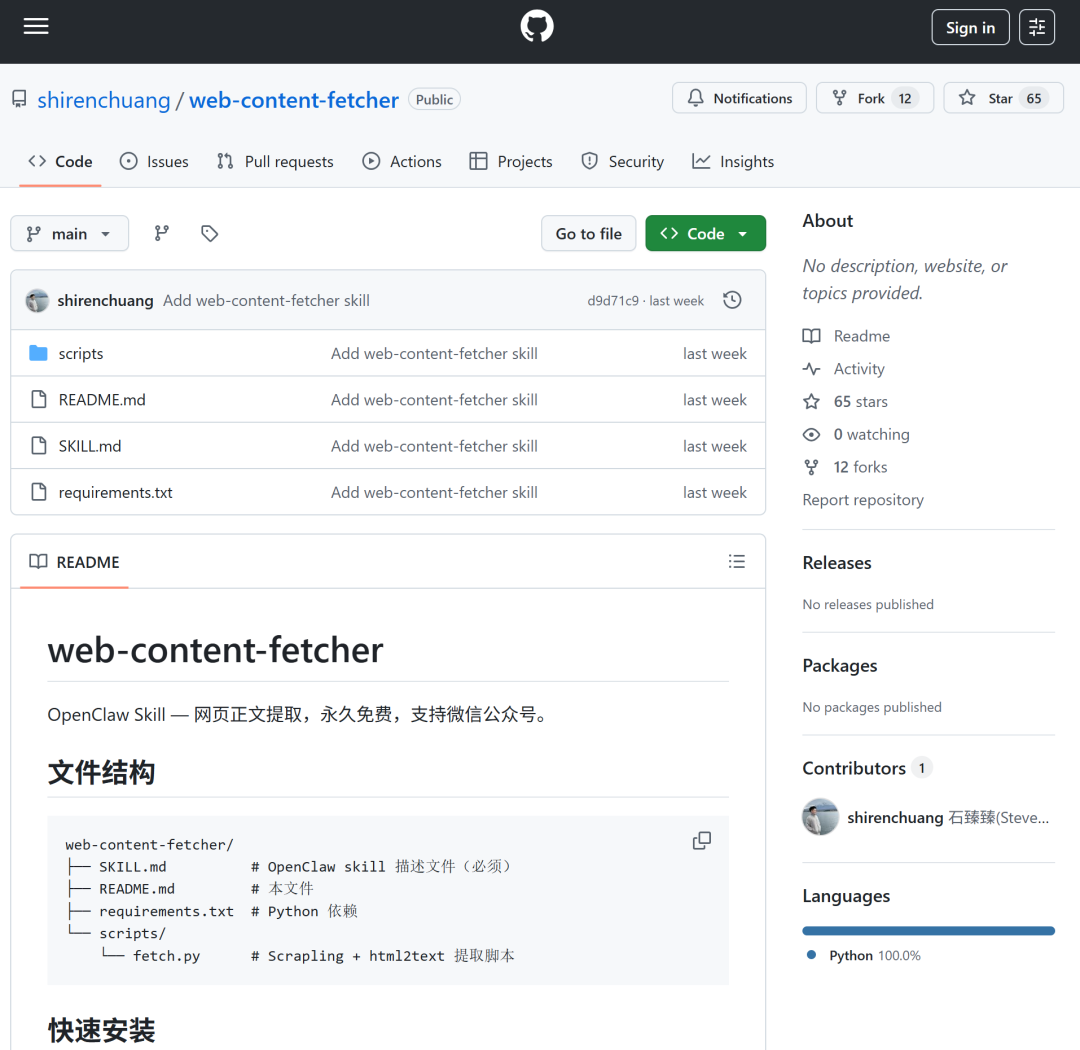
针对大模型提取网页内容时“幻觉频发、防爬难破、效果不稳定”的痛点,开发者推出开源OpenClaw Skill——web-content-fetcher,通过组合Jina、Scrapling、web_fetch三款工具并设计智能调度逻辑,实现对微信公众号、小红书、知乎等主流平台的稳定网页提取,且永久免费、无需API Key,成为日常网页内容抓取的“万能钥匙”。
一、核心设计:三工具组合+智能优先级调度
web-content-fetcher的核心优势的是“扬长避短”的工具组合策略,将三款现有工具的特性发挥到极致,并通过优先级调度解决单一工具的局限性:
1.三款工具各司其职
2.智能调度逻辑
采用“优先最优解,遇阻自动切换”的优先级策略:
首选Jina:优先使用其高效去冗余能力,确保输出内容简洁精准;
次选Scrapling:当Jina达到使用上限,或遇到微信公众号等无法突破的平台时,自动切换至Scrapling,破解反爬限制;
保底web_fetch:前两款工具均失效时,调用web_fetch获取完整源码,确保不遗漏内容。
此外,工具统一设置30000字符上限(maxChars),在节省Token消耗与保留完整正文之间实现平衡,兼顾效率与实用性。
二、安装指南:手动安装开源版,三步完成部署
需注意,skillhub和clawhub源的自动安装版本无法抓取微信公众号,需手动安装GitHub开源版,步骤简单易操作:
下载源码:通过GitHub链接(github.com/shirenchuang/web-content-fetcher)下载压缩包,或用git clone命令克隆仓库;
部署文件:解压后将整个web-content-fetcher文件夹,上传至OpenClaw的Skills目录(路径:~/.openclaw/workspace/skills/); 安装依赖:打开命令提示符(Windows)或终端(Mac/Linux),执行pip install scrapling html2text--break-system-packages(服务器端可执行pip install-r requirements.txt),首次安装后需运行scrapling install下载浏览器依赖;
重启生效:重启OpenClaw后,Skill自动加载,无需额外配置即可使用。
三、实测效果:覆盖90%日常场景,无幻觉不编造
对7类主流平台链接进行实测,整体通过率达90%,且提取内容准确、总结到位,无大模型常见的“编造信息”问题:
1.稳定通过的平台(6类)
微信公众号:成功突破防爬机制,快速提取正文,总结能精准覆盖核心功能、使用场景等关键信息;
小红书:Jina被屏蔽时自动切换Scrapling,顺利抓取历史笔记等内容,总结完整还原文章主旨与细节;
飞书文档、CSDN博客:即使CSDN需登录弹窗,仍能提取核心内容,总结准确命中文章情感基调与核心观点; X(Twitter)、知乎:完美抓取公开内容,知乎回答的多论点总结无遗漏,X平台帖子的故事线提炼完整。
2.暂不支持的场景
需登录的私有内容:如Google Docs,因内容区域需账号权限验证,仅能抓取菜单栏等界面元素,无法获取正文;
应对方案:工具会坦诚报错并提供替代路径(导出PDF/Word、复制粘贴内容、修改分享设置),不编造虚假信息。
四、使用方式与核心价值
1.触发方式简单
无需复杂指令,发送包含网页链接的提取/总结请求即可触发,支持触发词包括:“抓取某个URL的正文内容”“总结这个链接的内容”“提取网页内容”等,自然语言描述即可生效。
2.核心价值
免费无限制:无使用次数、平台、内容长度限制,无需付费API Key,降低使用成本;
稳定防幻觉:基于真实网页内容提取,不编造信息,总结精准度远超直接让大模型读取链接;
复用性强:作为OpenClaw Skill,可无缝集成到自动化工作流中,支持批量提取、内容汇总等进阶场景。
五、背后逻辑:Skill的核心价值是“封装最优解”
web-content-fetcher的成功并非依赖新技术发明,而是将现有工具的最优解封装成可直接复用的Skill——开发者无需了解Scrapling的反爬原理、Jina的过滤逻辑,只需安装使用即可享受稳定效果。这正是OpenClaw Skill生态的核心魅力:一个人解决问题后,所有用户均可直接复用解法,避免重复踩坑。
其背后的方法论值得借鉴:遇到复杂问题时,不必局限于单一工具,可组合现有技术形成“组合拳”,并封装成可复用的方案,既提高效率,也能让技术普惠更多人。
web-content-fetcher以“简单部署、稳定高效、永久免费”的优势,解决了日常网页提取的核心痛点,尤其适合需要批量抓取内容、总结网页信息的OpenClaw用户。
虽然无法突破所有私有内容或极端防爬机制,但已能覆盖90%的日常使用场景,成为OpenClaw生态中不可或缺的实用Skill。对于经常需要提取网页内容的用户,推荐优先安装体验,进一步提升AI工作流的效率与可靠性。
 AI 速览