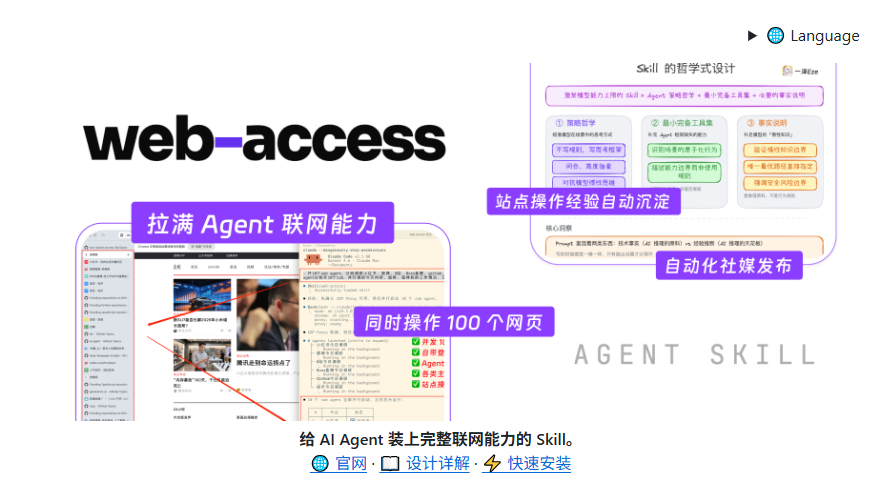
你让 Claude Code 帮你做竞品调研、抓小红书笔记,它跑一圈 WebSearch 就没辙了,遇到登录页、反爬页直接歇菜,最后还是你自己开 Chrome 手动翻。这个断点其实是很多AI的通病,如今有了web-access 这个Skill,抓取数据这件事再也不是什么难事了。 它到底解决了什么问题
Claude Code 原生联网能力就是 WebSearch 加 WebFetch,遇到需要登录、交互、等 JS 渲染完的页面,两者都抓瞎。web-access 没有再造一个无头浏览器,而是通过 Chrome DevTools Protocol(CDP)直接接管你正在用的浏览器——小红书、飞书、GitHub 都登着,Claude Code 直接借用这些登录态干活,不用重新登录、不用处理验证码,跟 Playwright 那种「起一个干净新浏览器」是两条路子。 它内部有三层通道调度:公开信息走 WebSearch,网页正文交给 Jina 提取,只有涉及登录态、动态加载、表单交互的场景才启动最重的 CDP 浏览器,Agent 自己判断走哪一层。还有个站点记忆机制,每次成功访问一个站点后,会把有效的 URL 模式、能抓到正文的 DOM 选择器、会触发反爬的操作存进本地 references/site-patterns/ 目录,下次直接读缓存跳过摸索,缓存失效了就自动回退重新探索并更新。
开发者是独立开发者一泽(Eze),这个 Skill 目前在 GitHub 已经拿到8.6k个Star、600 多个 Fork,最新版本新增了 Microsoft Edge 支持。
适用对象:
跑竞品调研、写行业周报的人最能感受到差距——同时看五六个官网、扒几十条社媒评论,人肉复制粘贴一晚上都弄不完。做内容矩阵运营、做舆情监控、想让 AI 把网页信息导进 Excel 做数据表格的人,这个 Skill 基本都能补上「AI 能写代码但不能上网点点点」的短板。
web-access安装教程,四种方式任选
最省事的是用 skills CLI 一键装:
这个 CLI 是开源的 Agent Skill 包管理器,会自动识别环境装到正确位置。
嫌敲命令麻烦,也可以直接甩给 Agent 自己装:
用 Claude Code 的话还有 Plugin 安装方式:
不放心自动化流程,想自己手动来,就用最原始的 git clone:
装完还没完,CDP 模式要求 Node.js 22 及以上版本,浏览器得单独开远程调试。Chrome 地址栏输入 chrome://inspect/#remote-debugging,Edge 输入 edge://inspect/#remote-debugging,勾选「Allow remote debugging for this browser instance」,可能需要重启浏览器才生效。
长期用哪个浏览器可以固定,配置文件在 ${CLAUDE_SKILL_DIR}/config.env,首次运行自动从模板创建且被 gitignore。写 WEB_ACCESS_BROWSER=edge 就固定用 Edge,留空则每次启动都会问你,合法值只有 chrome 和 edge。
临时换个浏览器又不想改配置文件,可以单次指定:
proxy 已经连上旧浏览器要切换,得先杀掉进程再重连:
这个环境检查 Agent 运行时会自动跑,手动执行就是:
有个坑得避开:之前装过 Chrome DevTools MCP 或 Playwright MCP 的话先关掉,多套自动化层同时挂着,Agent 会纠结用哪个,反而拖累效果。
web-access Skill使用方法
装好之后不需要记命令,直接用自然语言吩咐 Agent 就行,比如「去小红书搜索 xxx 的账号」「读一下这个页面:[URL]」「同时调研这 5 个产品的官网,给我对比摘要」「帮我在创作者平台发一篇图文」,Skill 自动判断走 WebSearch、Jina 还是 CDP 浏览器。
底层是一个 CDP Proxy,通过 WebSocket 直连浏览器,对外暴露一套 HTTP API,Agent 平时不用你操心生命周期,了解一下能帮你判断它在干什么:
Proxy 会自动追踪 /new 建出来的 tab,闲置 15 分钟自动关掉,防止 Agent 异常退出留下孤儿标签页,超时时间能用环境变量 CDP_TAB_IDLE_TIMEOUT(单位毫秒)自己调。
并行能力是另一个亮点,官方说法是单个 Chrome 实例能扛 100 个以上标签页,每个子任务用自己独立的 tab 但共享同一套登录状态,互不干扰也不抢资源。同时去微博、小红书、知乎搜同一个关键词,就是并行开好几个 tab 一起抓,不用排队。
还有个容易被忽略的功能叫本地书签/历史检索,脚本是 find-url.mjs,能跨 Chrome、Edge 查你访问过的、公网搜不到的页面(比如公司内部系统),支持按关键词、时间窗、访问频度排序,也能用 --browser 参数限定单一浏览器。
用起来的一些技巧
写周报时,与其自己打开十几个网站抄数据,不如让它并行开好几个 tab 同时去抓,再整理成一段总结,你负责校对措辞。做 PPT 前收集素材,批量打开几个行业博客整理标题摘要,直接挑重点往幻灯片上填。把某平台几十条笔记的标题、点赞数导出成 Excel,也是先让 Agent 抓数据,抓完顺手转成结构化表格。
社媒账号相关的操作要留心:官方明说过风险,浏览器自动化操作小红书这类社交平台存在被限流甚至封号的可能,真要做发帖、提交表单,建议先拿小号练手,别直接上主力账号。
web-access这类 Skill 的价值不在炫技,而在于它把「AI 能写代码却不能替你上网跑腿」这个真实痛点堵上了。用好它,还是得自己摸清哪些操作能放手、哪些得留个心眼,尤其是涉及登录账号的场景。
 AI 速览