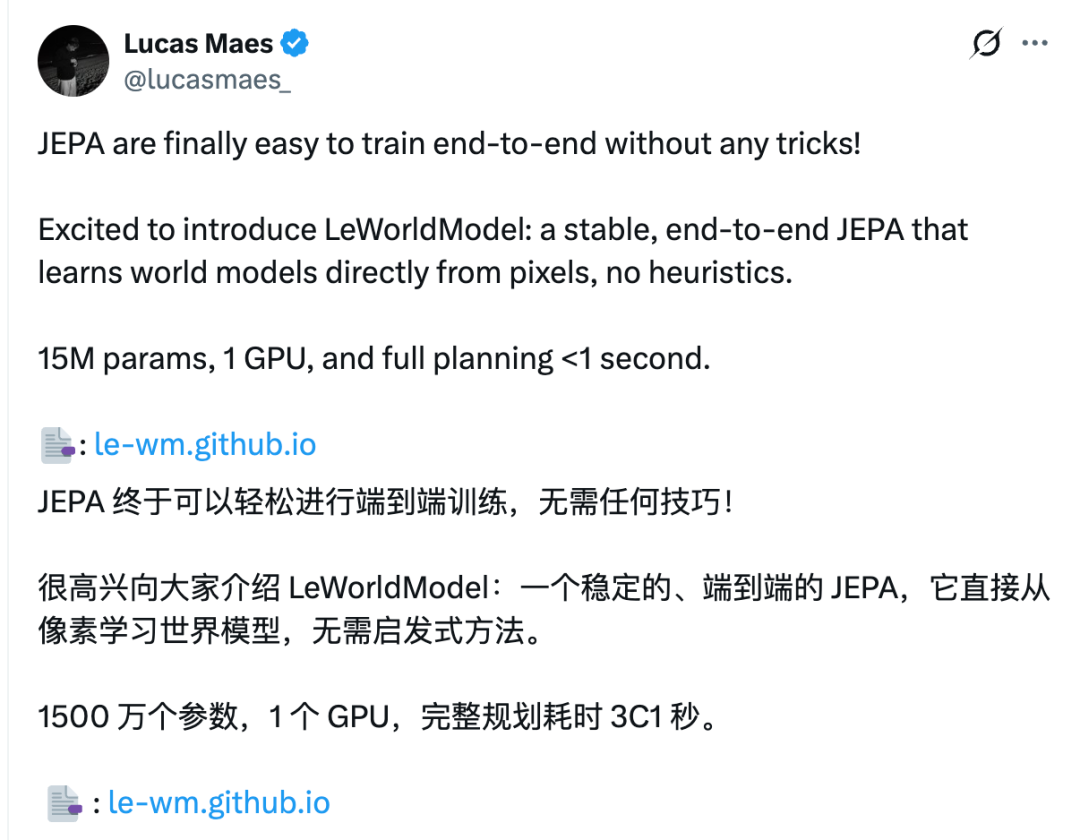
3月24日,由Yann LeCun参与指导的团队正式开源世界模型LeWorldModel(简称LeWM)。该模型基于JEPA(联合嵌入预测架构),通过极致简化的设计,实现了“单GPU训练、1秒规划、懂物理规律”的核心突破,专为机器人与AI智能体的规划控制场景打造,彻底降低了世界模型的使用门槛,相关代码、论文及项目主页已同步公开。
一、核心亮点:轻量化与高性能的双重突破
LeWorldModel颠覆了传统世界模型“大参数、高算力”的固有认知,在参数规模、训练成本与执行速度上实现跨越式提升:
超小参数体量:仅1500万参数,远低于同类世界模型(通常亿级以上),轻量化设计让部署更灵活;
单GPU即可落地:所有训练与规划实验均在单张NVIDIA L40S显卡上完成,几小时即可完成训练,无需集群或超高配硬件;
极速规划能力:完整任务规划耗时不到1秒,比依赖大模型预训练的DINO-WM快48倍,可满足实时控制需求;
物理规律理解:能从像素输入中学习位置、角度等物理信息,准确预测物体运动轨迹,还能识别“违反物理定律”的场景(如物体瞬移),面对物理扰动时“惊讶值”显著提升,而对物体变色等视觉扰动反应平淡。
二、技术架构:极简设计,回归JEPA本质
LeWorldModel的核心创新在于“去繁就简”,摒弃了传统JEPA架构的复杂技巧,仅通过“编码器+预测器+双损失函数”实现稳定端到端训练:
1.核心组件(仅2个)
编码器(Encoder):将输入的像素画面(如机器人视角图像)压缩为紧凑的latent特征向量,实现观测数据约200倍的缩小,提升后续预测效率;
预测器(Predictor):接收当前latent特征与用户指定的动作指令,预测下一时刻的特征向量,从而推断“动作执行后的世界状态”。
2.损失函数(仅2个)
传统JEPA需依赖多个复杂损失函数防止模型崩溃,而LeWM仅用两组损失实现稳定训练:
预测损失(Prediction Loss):采用MSE均方误差,确保预测器输出的下一时刻特征与真实特征一致,让模型学会世界的动态规律;
SIGReg正则损失:强制所有latent特征向量服从标准高斯分布,从根本上避免模型“摆烂坍塌”(即所有输入画面输出相同特征)。
总损失公式简化为:总损失=预测损失+λ×SIGReg正则损失(λ为唯一需调优的超参数),极大降低了训练门槛。
三、实验结果:性能碾压传统JEPA,比肩大模型方案
团队在4个经典机器人/控制任务(Push-T推箱子、Reacher机械臂够目标、OGBench-Cube 3D机械臂抓方块、Two-Room 2D导航)中,将LeWM与PLDM(传统端到端JEPA方法)、DINO-WM(大模型预训练世界模型)进行对比,结果表现亮眼。
此外,在物理信息预测测试中,LeWM对机器人/方块位置、方块角度、机械臂指尖坐标的预测精度接近100%,与DINO-WM水平相当,远超PLDM。通过可视化解码器,还能清晰展示模型对真实场景的还原能力与未来运动的预测准确性。
四、团队背景与开源资源
1.核心团队
项目由米兰国际关系学院(Mila)博士生Lucas Maes牵头,纽约大学博士后Quentin Le Lidec(与LeCun合作)、三星研究员Damien Scieur、布朗大学助理教授Randall Balestriero等共同参与,Yann LeCun作为核心指导者提供技术支持,团队深耕JEPA架构优化、物理理解与智能体控制领域多年。
2.开源资源
项目主页:le-wm.github.io/
GitHub代码库:github.com/lucas-maes/le-wm
论文地址:arxiv.org/pdf/2603.19312v1
五、行业意义:推动世界模型平民化与实时控制落地
LeWorldModel的开源打破了世界模型“高算力依赖”的壁垒,其核心价值体现在:
对开发者:单GPU训练+极简架构,让中小团队与个人开发者无需高额算力投入,即可搭建专属世界模型;
对应用场景:1秒级规划速度适配机器人实时控制、智能体决策等场景,推动世界模型从“实验室研究”走向工业落地;
对技术趋势:证明了“轻量化+端到端”是世界模型的可行方向,为后续机器人、自动驾驶、智能体等领域的技术迭代提供了新范式。
未来,该模型有望进一步拓展至更复杂的3D环境与多智能体协作场景,持续降低“AI理解物理世界”的技术门槛。
 AI 速览