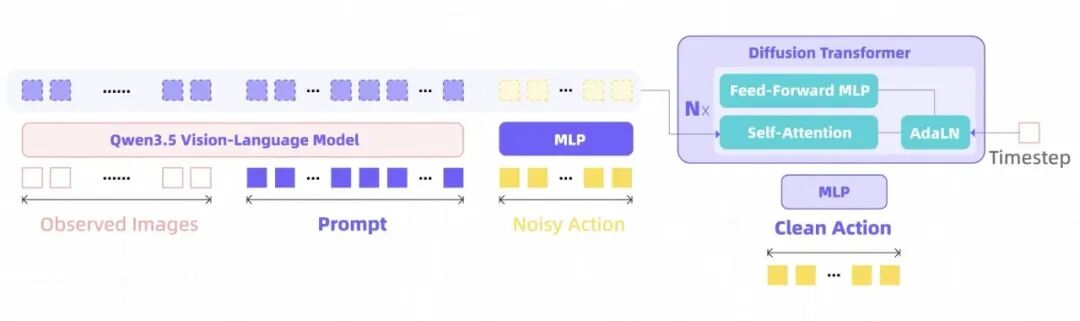
据 Qwen 团队 5 月 29 日发布的论文(arXiv:2605.30280),阿里通义千问正式开源 Qwen-VLA,一个将机械臂操作、视觉导航和轨迹预测整合进单一架构的视觉-语言-动作(VLA)模型。这是 Qwen 系列从语言和多模态理解向具身智能(embodied AI)延伸的第一步,也是国内大厂在 VLA 方向的首个完整开源方案。 技术路径:从 VLM 到 VLA,加了一个 DiT 动作解码器
Qwen-VLA 的基座是 Qwen 已有的视觉-语言模型(VLM),在感知、理解和推理能力之上,通过一个基于 DiT(Diffusion Transformer)的动作解码器,将输出空间从文本扩展到连续动作和轨迹生成。
这个架构选择有明确的对标意义。当前 VLA 领域的两条主线分别是离散动作 token 预测(以 RT-2 和 OpenVLA 为代表,将动作离散化为 256 个 bin 后用 token 自回归预测)和流匹配连续动作生成(以 Physical Intelligence 的 π₀ 为代表,用 flow matching 生成平滑的高频动作轨迹)。Qwen-VLA 走的是第二条路线的变体——用 DiT 做连续动作解码,同时通过"具身感知提示条件化"(embodiment-aware prompt conditioning)让同一个模型适配不同机器人形态,具体做法是在文本提示中加入当前机器人的本体描述和控制约定。
训练数据来源覆盖了多个异构来源:机械臂操作轨迹、人类第一人称视角演示、仿真合成数据、视觉-语言导航数据、轨迹级监督信号,以及辅助的视觉-语言数据。这种大规模联合预训练的策略,目标是让一个模型同时学会"怎么抓""怎么走"和"怎么预测别人会怎么走"。
跑分:操作、导航、真机三条线的成绩
Qwen-VLA 在论文中报告了跨任务、跨环境、跨机器人形态的评测结果。
操作类评测中,LIBERO 得分 97.9%,Simpler-WidowX 得分 73.7%,RoboTwin-Easy 和 Hard 分别为 86.1% 和 87.2%。LIBERO 是当前 VLA 社区使用最广泛的操作评测基准,UT Austin 团队设计,覆盖 4 个任务套件约 130 个任务。
导航类评测中,R2R(Room-to-Room)的 OSR 为 69.0%,RxR 的 SR 为 59.6%。这两个都是视觉-语言导航的标准评测集。值得注意的是,大多数 VLA 模型根本不做导航评测——它们只管"抓"不管"走"。Qwen-VLA 把导航纳入统一框架是它与竞品的结构性差异。
真机评测中,在 ALOHA 双臂机器人上的 OOD(分布外)平均成功率为 76.9%。DOMINO 动态操作的零样本成功率为 26.6%——这个数字看起来低,但 DOMINO 测的是模型从未见过的动态操作任务,26.6% 的零样本表现在当前 VLA 文献中算可用水平。
竞品对照:和 π₀、OpenVLA-OFT 比在哪
VLA 赛道在 2026 年已经相当拥挤。横向对照几个关键竞品:
π₀(Physical Intelligence,2024 年发布)是流匹配 VLA 的开创者,在 LIBERO 上得分 94.2%。Qwen-VLA 的 97.9% 高出 3.7 个百分点。但 π₀ 闭源且仅通过商业合作获取,无法做社区级复现。π₀.5 在真机 ALOHA 的 OOD 场景中报告了 71.6% 和 41.5% 两个数字(取决于任务类型),Qwen-VLA 的 76.9% 在同一硬件平台上有明确优势。
OpenVLA-OFT(Stanford,2025 年 2 月)通过优化微调方案把 OpenVLA 在 LIBERO 上从 76.5% 拉到 97.1%,同时实现了 26 倍的推理加速。Qwen-VLA 的 97.9% 略高 0.8 个百分点,但两者可能在误差范围内。OpenVLA-OFT 的核心优势是开源且轻量(7B 参数),微调只需 100-200 个演示。
Helix(Figure AI,2025 年)为人形机器人设计了"系统 1 / 系统 2"双架构,快速反应和慢速推理分离。SmolVLA(Hugging Face,2025 年)走极致轻量路线,约 450M 参数。这两者和 Qwen-VLA 的定位差异较大,不在同一条跑道上。
Qwen-VLA 相对于以上所有竞品的结构性差异在于:它是目前唯一在一个模型中同时覆盖操作、导航和轨迹预测三类任务的开源 VLA,而不是只做操作。这个设计选择带来了跨任务迁移的可能性,但也意味着在单一任务上可能不如专精模型的天花板高。
局限和需要关注的信息
LIBERO 评测本身正在受到质疑。2026 年多篇论文指出,在 LIBERO 上得分 95%+ 的模型,面对轻微的分布外扰动(换一个目标物体、挪一下初始位置、改一下指令措辞)后成功率可能降到接近零。LIBERO-PRO 和 libero-ood 两个扩展评测集专门测这种脆弱性。Qwen-VLA 报告的 97.9% 是标准 LIBERO 成绩,没有报告在这些鲁棒性评测上的表现。
论文共 40 位作者参与,规模很大,但目前没有公布模型参数量。据 Pandaily 报道,Qwen-VLA 构建在 Qwen 的 VLM 之上,但具体是哪个版本的 VLM 底座、总参数量多少、推理延迟多少,论文摘要和已公开信息中没有明确说明。对于实际部署来说,这些工程细节比 LIBERO 分数更关键。
DOMINO 零样本 26.6% 的成功率表明,在未见过的动态操作场景中,模型的泛化能力仍然有限。导航评测的 R2R 69.0% OSR 和 RxR 59.6% SR 也不算高分,与导航专精模型相比存在差距。"统一"的代价是在每个子任务上都不是最强。
阿里的具身 AI 布局有产业背景。据 Pandaily 报道,阿里通过阿里云(计算基础设施)、淘宝和菜鸟(电商和物流的真实世界数据)构成了潜在的部署生态。Qwen-VLA 不只是一篇学术论文,它是阿里进入具身 AI 赛道的技术起点,后续大概率会与阿里的机器人和物流业务对接。
 AI 速览