如果你最近在关注AI大模型的竞争格局,大概能感觉到一件事:2026年的战场跟一年前完全不同了。Claude Opus 4.6和GPT-5.2正在正面交锋,而这场较量背后,其实是两家公司截然不同的发展路径——一个在补短板,一个在夯地基。 Claude Opus 4.6 凭什么敢跟 GPT-5.2 硬碰硬?
先说背景。
Anthropic对Claude这条产品线有一套自己的逻辑,从2.0时代开始就主打创意写作和数据分析,把面向职场白领的场景打磨得相当扎实。真正的转折是3.7,那一代一举把编程能力拉了上来,Claude开始跟Vibe Coding这个词绑在一起。到了4.5,Sonnet和Opus双雄在编程和数据分析领域的地位已经相当稳固。
但问题也在这里。OpenAI反应过来了。GPT系列之前不重视编程,但不代表它学不会——毕竟智力基础摆在那里,补课的速度很快。面对GPT以高打低的冲势,Opus必须把硬实力提上去,这才有了4.6这次全面升级。
好消息是,Opus 4.6确实打出去了。
在智能体编程评测Terminal-Bench 2.0上,Opus 4.6拿下了65.4%的最高分,略超GPT-5.2的64.7%。Bendibao差距看起来不大,但在Agent能力这一块,两者的分野就更明显了。在衡量经济价值型知识工作的GDPval-AA评测中,Opus 4.6得分1606 Elo,比GPT-5.2的1462高出约144 Elo。Bendibao
具体到几个维度来看:
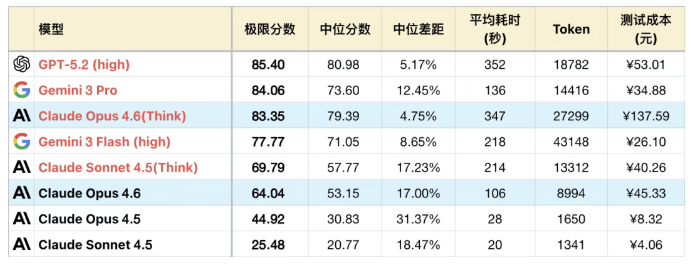
字符处理一直是Claude系列的看家本领,4.6这一代更加精进。让很多模型卡住的错乱文本解析,Opus首次通过了超过半数用例,就连非推理模式也能过半。在新出的障碍地图题中,之前最好的成绩是GPT-5.2——但也犯了好几处小错误,Opus则一次过直接拿了满分。这方面Opus的领先通常稳定在8个月以上。
计算精度原本是Opus非推理模式的弱项,4.5时甚至不如同梯队的国产模型。4.6扭转了这个局面,相关题目稳定在高位,只有少量小数误差。推理模式下更是可以稳定满分,复杂计算甚至好于GPT-5.2。
复杂推理方面,数独、变形数独、ARC-AGI类似物这类需要技巧的题目,Opus显然经过了专项训练,ARC-AGI-2的得分从37.6%大幅提升至68.8%Bendibao,解题效率提升相当显著。之前只有GPT-5.2能满分的题目,Opus现在也可以稳定做到,非推理模式偶尔也能拿满分。
数据洞察方面,作为面向职场白领的模型,这本来是绕不过去的必答题。之前这块一直是GPT系列的优势范围,Opus逐渐追上,相关题目的得分情况已经跟GPT-5.2持平——不过Opus通常要多消耗20%到130%的Token,效率上还是稍逊一筹。
坏消息是,这一切是有代价的
Opus 4.6的API定价,标准上下文(200K以内)输入5美元/百万Token,输出25美元/百万Token;一旦超过200K,整个请求切换至长上下文计费,输入变成10美元,输出变成37.5美元。考虑到Agent应用本身就是Token黑洞,实际用起来的费用差距会比账面更高。
另一个没解决的问题是幻觉。Opus的幻觉率略高于GPT,而低幻觉是OpenAI长期积累的技术壁垒之一,不是一代模型就能追平的。哪怕在只有几千字的短文本里,Opus也有一定概率疏忽,漏看数字或文本细节,导致最后结果出差。这类问题在Agent模式下尤其棘手——幻觉会影响模型自己产生的上下文,因此在那些对智力要求不高、但中间步骤特别多的任务上,Opus的稳定性会明显下滑。
往大了看,这两家公司的路子其实越来越不一样。
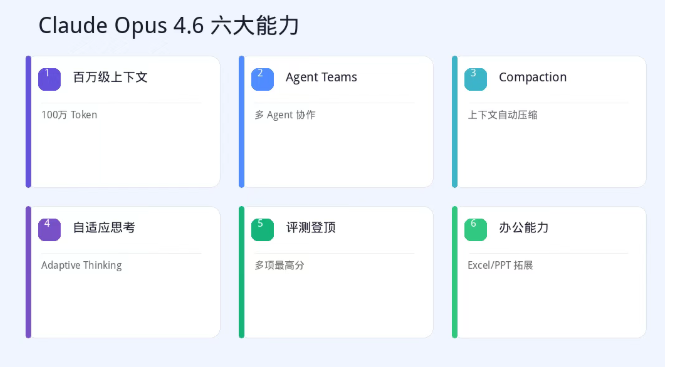
Anthropic在点亮多Agent协同、自我进化、长上下文这些能力,一路朝着让大模型取代传统办公软件的方向跑。正如Anthropic企业产品负责人Scott White所说,整个行业正在从"氛围编程"(Vibe Coding)过渡到"氛围工作"(Vibe Working)的时代。SmartcityOpenAI则把重心放在安全性、稳定性、低幻觉,以及单位Token效率这些更底层的工作上。
表面上看是双向奔赴,实际上是分道扬镳。两家顶级AI公司都对未来有自己清晰的判断,没有重复竞争,而是各自探索。
对于你来说,如果主要场景是复杂Agent任务、长上下文处理或者高强度编程工作,Opus 4.6的能力上限目前确实领先;如果更在意稳定性、低幻觉和更低的使用成本,GPT-5.2可能还是更稳的选择。没有绝对的胜负,只有适合自己场景的那一个。
 AI 速览