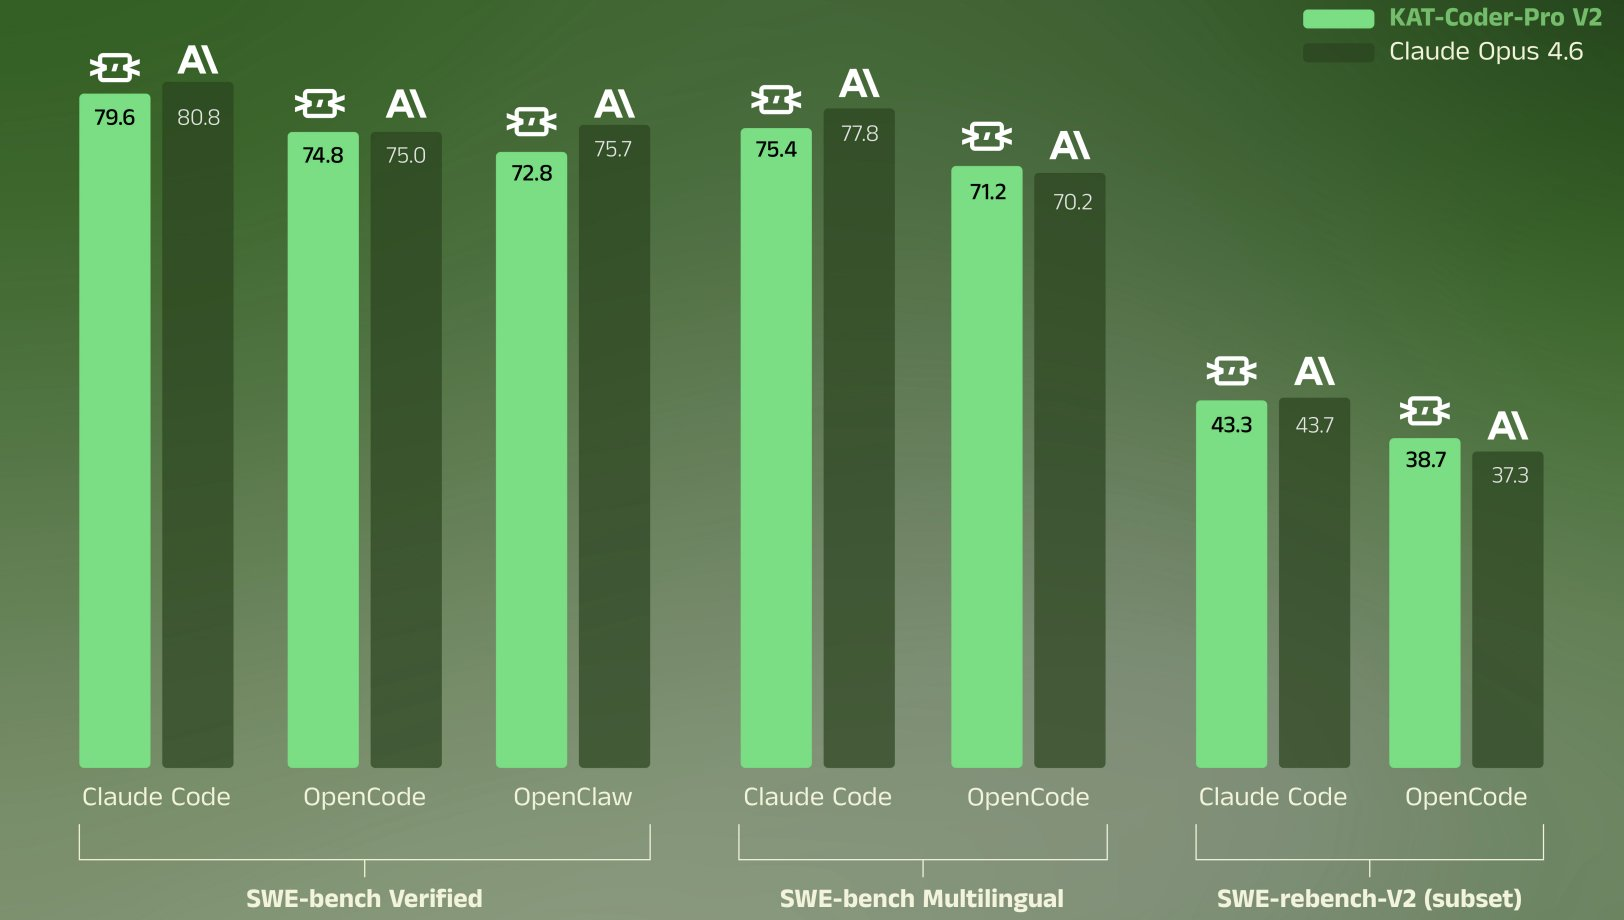
3月30日消息,快手 KwaiKAT 团队于近日正式推出 KAT-Coder-Pro V2,这是其 KAT-Coder 系列的最新旗舰智能体编码模型。根据 arXiv 技术报告,该模型在 SWE-bench Verified 上达到 79.6%,输入定价 0.30/Mtokens——约为ClaudeOpus4.6(0.30/Mtokens——约为ClaudeOpus4.6(5/M 输入)的 1/12.5,是目前 SOTA 编码模型中性价比最高的选择之一。
技术架构:"Specialize-then-Unify"训练范式
KAT-Coder-V2 的核心创新在于将智能体编码能力拆解为五大专家领域,分别独立训练后再融合为单一模型:
每个专家域独立进行 SFT + RL 训练,然后通过 On-Policy Distillation(OPD) 融合。快手自研的三项基础设施配套了这一流程:
- KwaiEnv:支持数万级并发沙箱实例的统一执行环境
- MCLA(Monte-Carlo Log-probability Averaging):降低 MoE RL 训练中的 log-probability 方差
- Tree Training:消除树状轨迹中的冗余计算,训练加速最高 6.2 倍
基准表现:多项接近或超越 Claude Opus 4.6
根据 arXiv 论文自报数据,KAT-Coder-V2 在多个基准上对标 Claude Opus 4.6:
| | | |
|---|
| | | Anthropic 官方报告 81.42%(25次平均+prompt修改) |
| | | |
| | | Artificial Analysis 独立评测记录 V2 为 49.2% |
| | | Artificial Analysis 独立评测记录 V2 为 89.5% |
| | | |
| | | |
前端美学 - Data Visualization | | | |
需要注意的是,部分基准数据存在第三方评测差异。SWE-bench Verified 在部分第三方网站(如 atlascloud.ai)记录为 73.4%,可能与评测配置或版本有关。τ²-Bench 和 Terminal-Bench 的自报数据与 Artificial Analysis 独立评测之间存在约 4 个百分点的差异,具体原因尚不明确。
多 Scaffold 原生适配,支持 10+ 编码工具
论文 Section 2.3 详细介绍了 KwaiEnv 的统一抽象层设计,使模型能够原生适配多种 AI 编码工具框架,无需调整提示词即可切换。目前已验证支持的平台包括:Claude Code、OpenClaw、OpenCode、Cline、Kilo 这一设计的意义在于,开发者无需为每个工具重新调参或重写 prompt,模型在底层统一了各 scaffold 的协议抽象。
定价与市场定位
对比 Claude Opus 4.6(5/M输入,5/M输入,15/M 输出,1M 上下文窗口),KAT-Coder-V2 的 API 定价约为其 1/12.5。虽然上下文窗口较小(256K vs 1M),但在大多数编码任务场景中已足够使用。
V1 版本(kat-coder-pro-v1-free,曾在 OpenRouter 免费可用)已于 UTC 2026年3月30日 正式下线,官方建议用户迁移至 V2。
行业背景
当前 Agentic Coding 赛道竞争白热化:
SWE-bench Verified 已进入 80%+ 时代,Top 5 模型集中在 80-82% 之间。KAT-Coder-V2 以 79.6% 的自报分数(第三方记录 73.4%)处于第二梯队领先位置,但定价远低于同级别模型。
值得关注的是,PinchBench 等新基准正在兴起,聚焦 OpenClaw 等 Agent 框架的真实任务表现,而非单一代码生成指标。前端美学评估也是 KAT-Coder-V2 的差异化方向——在 Landing Page、Slides 和数据可视化三个场景中,其自研指标均为行业报告中的最高分,但该基准尚缺乏独立第三方复现。
 AI 速览