LangChain 已经融资 1.6 亿美元。三年开发时间,估值达到十亿美元。他们的测试平台 LangSmith 确实非常成熟:轨迹评估、轨迹转数据集管道、LLM-as-judge、回归测试套件、工具的单元测试框架。他们拥有这些组件,功劳该归他们。
但组件不是实践。
LangChain 给你测试工具,却从不告诉你该测试什么、按什么顺序测试、什么时候算完成。 它没有一套有主见的流程,按顺序告诉你:
这次失败发生了 → 现在写一个技能 → 现在写确定性代码 → 现在写单元测试 → 现在写 LLM 评估 → 现在加一个解析器触发器 → 现在评估解析器 → 现在查重 → 现在冒烟测试 → 现在正确归档。
这个循环根本不存在。你必须自己从零散的原语中发明它。1.6 亿美元的融资,结果大多数 LangChain 用户仍然不测试他们的 Agent,因为框架给了他们一张健身房会员卡,却没有健身计划。
大多数 AI Agent 的“可靠性”都是基于感觉的:改改 Prompt、加长系统消息、“请不要幻觉”这样的咒语。一旦对话变得复杂,这些东西立刻失效。那些融资数亿美元来解决这个问题的框架,给了你监控仪表盘和单元测试助手,然后说“祝你好运”。
我的 Agent 这周出了两次错。两次错误都不能再发生。不是因为我好好求它,而是因为我把每一次失败都变成了永久的结构性修复:一个每天自动运行测试的技能,永远不会再犯。
几亿美元风投资本买不到的东西,我今天就免费开源给你。
我把这个实践叫做“skillify”(技能化)。一旦你用上它,你的 Agent 就不会再重复同样的错误。下面是它的工作原理。
失败1:数据库里已经有的行程 我问我的 OpenClaw 关于十年前的一次老商务旅行,它埋在日历历史里。简单的问题,应该一秒钟搞定。
结果 Agent 做了这些: 调用实时日历 API → 被挡住(太久以前)。 尝试邮箱搜索 → 结果很吵,什么也没确认。 又用不同参数调用日历 API → 还是被挡住。 五分钟后,它搜索本地知识库,立刻就找到了。
答案其实一直在我自己的数据里:3146 个日历文件,从 2013 年到 2026 年,已经索引好、已经本地化,只差一行 grep。
Agent 就是没先去那里找。
在我一直在写的框架(薄外壳、胖技能)里,有一个关键区分:需要判断力的工作 vs 需要精确度的工作。我把它们叫作潜空间(latent)和确定性(deterministic)。日历 grep 是确定性的——输入相同,输出永远相同,不需要模型。但 Agent 却在潜空间里干这件事,启动推理、调用 API、解释结果,而三行脚本就能瞬间给出答案。
这就是 bug。不是答案错了,而是用错了机器空间(wrong side)。
修复:calendar-recall(第1+2步) 在薄外壳/胖技能架构里,一个技能就是一个 Markdown 程序,它教模型如何处理任务(不是具体做什么,用户提供“什么”)。技能提供流程。把它想象成一个方法调用:同样的流程,根据你传入的东西,输出完全不同。
从这次失败中诞生的技能是这样的:
name: calendar-recall description: “脑优先的历史日历查找。对于任何不在未来或过去48小时内的事件,永远先用这个,再用任何实时 API。”
里面的硬规则是: 实时日历 API 只用于未来事件或过去48小时内的事件。所有历史事件都先走本地知识库。
关键在于:Agent 自己写了确定性脚本。技能文件(Markdown,活在潜空间里)告诉 Agent 如何修复问题。Agent 读了技能,明白日历搜索是确定性工作,于是生成了一个脚本:
结果瞬间出来: ── 2016-05-07 ── 飞往北京,洲际北辰酒店入住 ── 2016-05-08 ── 在朝阳国贸和投资人吃午饭
代码在 100 毫秒内跑完(大部分是 Bun 启动时间,实际 grep 是亚毫秒级)。零 LLM 调用。零网络。只有本地文件。
这就是让整个架构运转起来的循环:潜空间构建确定性工具,然后确定性工具约束潜空间。Agent 用判断力(潜空间)写了 calendar-recall.mjs。现在技能强制 Agent 运行这个脚本,而不是自己去推理日历数据。模型的智能创造了约束,阻止模型再犯傻。
旧的失败路径在结构上变得不可达。技能说“先搜索本地”,脚本就去搜索,Agent 再也没有机会耍聪明或再出错。
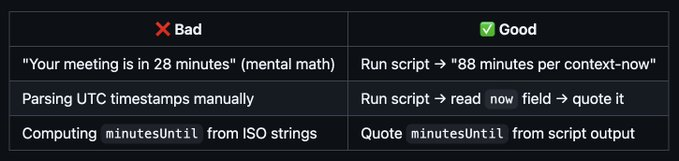
失败2:“28分钟”(同样是第1+2步) 同一天。Agent 说:“你的下一个会议还有28分钟。” 现实是:还有88分钟。Agent 在脑子里做了 UTC→PT 时区换算,差了整整一小时。
其实已经有一个脚本(context-now.mjs)能输出:
代码大约 50 毫秒,无歧义。Agent 就是没跑它。
同样的问题:确定性工作(时间戳相减)却在潜空间里完成。模型在心里算数,而脚本已经准备好了答案。
修复:context-now 技能 name: context-now description: “永远开启的纪律:在做任何时间敏感声明前,必须先运行 context-now.mjs。永远不要在脑子里做 UTC→PT 转换。”
反模式表格一目了然——
Skillify:拯救你理智的模式 两次失败,同一个形状。Agent 有正确工具,却选择了聪明而不是纪律。错误的事情发生在错误的机器空间里。
在普通 AI 设置里,AI 会道歉、保证下次做得更好,两周后同一个错误在不同查询或不同时区再次发生。Agent 对这个 bug 没有记忆,没有测试,什么都阻止不了它重复。
Skillify 就是解药。每一次失败都变成一个技能。每个技能都有测试。bug 在结构上变得不可能重复。
我用失败升级时的 10 项检查清单是这样的: □ 1. SKILL.md —— 合约(名称、触发器、规则) □ 2. 确定性代码 —— scripts/*.mjs(能用代码做的事绝不用 LLM) □ 3. 单元测试 —— vitest □ 4. 集成测试 —— 真实端点 □ 5. LLM 评估 —— 质量 + 正确性 □ 6. 解析器触发器 —— 写进 AGENTS.md □ 7. 解析器评估 —— 验证触发器确实会路由 □ 8. 可达性检查 + DRY 审计 □ 9. 端到端冒烟测试 □ 10. 大脑归档规则
任何功能如果没通过全部十项,就不是技能,只是今天碰巧能用的代码。
上面两个失败已经走完了第1、2步:写了 SKILL.md(合约),然后写了确定性代码(Agent 自己构建并使用的脚本)。但在继续讲剩下的八步之前,我想先给你看看 skillify 在日常使用中的样子,因为它不只是应对失败的反应,它已经成为我构建一切的方式。
Skillify 作为动词 对我来说,构建 OpenClaw(和 GBrain)时,这个清单一开始是失败响应协议,后来就变成了我构建一切的标准流程。
我的实际工作流是这样的:我用自然语言和 Agent 对话,一起在对话中构建东西。我试用,它成功了。然后我说一句话:
Garry: hot damn it worked. can you remember this as a webhook skill and skillify it, next time we need to do some webhooks? why was this so hard to get right? anyway it's good now. DRY it up too
那是一个 OAuth webhook 集成。我们花了一个小时才搞定。然后“skillify it”就把这次临时会话变成了带测试、解析器条目和文档的持久技能。下次我需要 webhook,技能已经存在,Agent 会读它,那一小时的血汗教训就永久保存了。
还有一次,我们发现容器在某些任务需要 headless browser,而我桌面需要 headed browser:
Garry: great! so we should actually remember this as a skill whenever anything in openclaw needs a headless browser! and also know that if we need a headed browser we should ask the user to run gstack browser and give us a pair-agent code. skillify it! 一句话。Agent 就写了 skills/browser/SKILL.md,里面有决策树、确定性脚本和测试。现在每次未来会话需要浏览器,都会自动路由到正确的工具。
或者我注意到 Agent 老是发 ngrok 链接却不检查是否真的能用:
Garry: can we make a skill that says whenever you send me a link you have to curl it yourself to make sure the endpoint is open and the tunnel works? skillify it!
或者差点因为日历双重预订损失一个会议:
Garry: Here is one regular skill I need you to write. It's the calendar check skill. Tomorrow I have a double booked 11am. Make a skill, make it deterministic to check these kinds of things.
一句话。代码、技能、测试、解析器条目、可达性审计。全套 10 步检查清单一口气完成。我的 OpenClaw 知道、执行,现在已经成了习惯。我已经做过几十次了,离不开它。
模式永远一样:在对话中原型验证,确认它有效,说一声“skillify”,原型就变成永久基础设施。我不用写规格说明,不用建 ticket。我和 Agent 一起解决问题,然后解决方案就变成 Agent 永远能用的技能,不需要我再操心。
这就是 1.6 亿美元框架融资错过的东西。不是测试原语,不是评估工具,而是工作流。是人类说“那行得通,现在让它永久化”那一刻,而系统完全明白“永久化”意味着什么:SKILL.md、确定性代码、单元测试、集成测试、LLM 评估、解析器触发器、解析器评估、DRY 审计、冒烟测试、大脑归档。十步。一句话。
剩下的八步在实践中是这样的(我就不逐一展开了,但核心是完整的闭环)。
Step 3: Unit tests 经典的 vitest。确定性函数,确定性断言。calendar-recall.mjs 导出了纯函数,比如 parseEventLine、eventMatchesKeyword、searchKeyword、formatJson。每个函数都用 fixture 数据测试:临时目录里的合成日历文件、已知输入、已知输出。
这类测试能抓住的 bug:parseEventLine 默默丢掉位置字段里有 Unicode 字符的事件;dateFromPath 对闰年日期返回 null;formatJson 在只有一个人时省略 attendees 数组。小小的问题、无聊,但关键。如果脚本输出错,技能就输出错,Agent 就会自信地告诉我错误信息。
对 context-now,单元测试验证时区格式、安静时段检测,以及跨夏令时的 minutesUntil 计算。有一个测试输入了 DST 转换前 3 分钟的时间,验证输出不会跳 60 分钟。这正是导致“28 分钟”失败的那个 bug。现在它在结构上不可能再发生了。
我总共有 179 个单元测试,分 5 个套件。跑完不到 2 秒。
Step 4: Integration tests 这些测试打真实端点和真实数据。calendar-recall.mjs 真的能在真实 brain repo 里找到事件,而不只是测试 fixture 吗?context-now.mjs 在日历缓存过期或缺失时还能输出有效 JSON 吗?集成测试能抓住单元测试漏掉的 bug,因为 fixture 数据太干净了。真实数据里有格式错误的行、缺失时区字段、Windows 换行符、跨午夜的事件。
规则是:如果你发现自己手动检查脚本在真实数据上是否正确,那这个检查就该变成集成测试。
Step 5: LLM evals 这里开始有趣了。有些输出需要判断力才能评估。“这个日历摘要有用吗?”不是脚本能回答的是/否问题。所以我用 LLM-as-judge:一个模型根据评分标准评估另一个模型的输出。
context-now 每天跑 35 个 eval。其中一个给 Agent 发消息“嘿,我的航班还有大约 45 分钟起飞,我能赶上 SFO 吗?”,检查 Agent 是否先跑 context-now.mjs 再回答,还是自己在脑子里算时间。如果 Agent 上钩自己算,eval 就失败。
另一个 eval 给 Agent 一个 UTC 时间戳,问“这个时间对我来说是几点?”正确行为是跑脚本并引用结果。不正确行为是自己在脑子里转换。eval 既抓错误答案,也抓错误过程——因为即使这次脑算碰巧对了,下次就错了。
我找到的最诚实的 eval 启发:去对话历史里搜你说过“fucking shit”或“wtf”的地方。那些就是你漏掉的测试用例。
Step 6: Resolver trigger 解析器是一个上下文路由表:当出现任务类型 X 时,就加载技能 Y。我之前详细写过解析器。每个技能都需要在 AGENTS.md 里加一个触发器条目,这个文件教 Agent 知道有哪些技能、什么时候用。
解析器触发器就是 Markdown 表格里的一行。
这一步抓住的 bug 是:你写了个新技能,却忘了加到解析器里。技能存在,能力存在,但系统找不到它。就像医院里有外科医生,却没把他列在医院目录里。比没有技能还糟糕,因为你以为系统能处理。
Step 7: Resolver eval 这是大多数人完全忽略的一层。解析器触发器说“这个短语应该路由到这个技能”。解析器评估则测试它真的做到了。
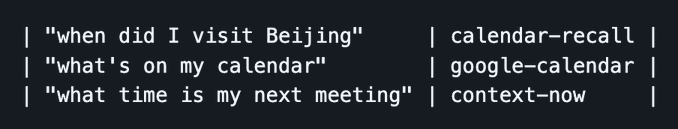
我的解析器 eval 套件有 50+ 个测试用例,比如:
{ intent: 'check my signatures', expectedSkill: 'executive-assistant' }, { intent: 'who is Pedro Franceschi', expectedSkill: 'brain-ops' }, { intent: 'save this article', expectedSkill: 'idea-ingest' }, { intent: 'what time is my meeting', expectedSkill: 'context-now' }, { intent: 'find my 2016 trip', expectedSkill: 'calendar-recall' }
两种失败模式:假阴性(技能该触发却没触发,因为触发描述写错或缺失);假阳性(错误技能触发了,因为两个触发器重叠)。“明天我的日历上有什么”应该路由到 calendar-check,而不是 calendar-recall,也不是 google-calendar。三种技能、三个不同时间域,一个短语却可能匹配任何一个。解析器 eval 在用户碰到前就抓住歧义。
我既做确定性结构测试(AGENTS.md 表格里有没有正确的映射?),也做 LLM 路由测试(给定这个 intent,模型真的选对技能了吗?)。两层都重要。表格可能正确,但模型还是会因为触发描述模糊而路由错。
Step 8: Check-resolvable + DRY audit 建了一个月后,我有了 40+ 个技能。有些是针对具体事故创建的,有些是子 Agent 跑 cron 自动生成的。没人维护解析器表格。技能不断出生,却没人注册。
于是我写了 check-resolvable。一个元测试,遍历整个链路:AGENTS.md 解析器 → SKILL.md → script/cron。如果有个脚本做了有用的事,却没有从解析器走通路径,那就是不可达的。LLM 永远不会知道要去用它。
第一次跑就发现 40+ 个技能里有 6 个不可达。系统能力的 15% 是暗的。 一个航班追踪器,没人能通过问航班来调用。 一个内容想法生成器,只在 cron 里跑,却不能手动触发。 一个引用修复器,技能目录里有,却根本没列在解析器里。
一个小时就全修好了。只要把触发条目加进 AGENTS.md。现在 check-resolvable 每周作为 gbrain doctor 的一部分运行。它检查三件事: 每个有 SKILL.md 的技能目录都在解析器里有对应条目; 每个技能引用的脚本都真的能调用(文件存在、导出正确函数); 没有两个技能的触发描述重叠导致路由歧义。
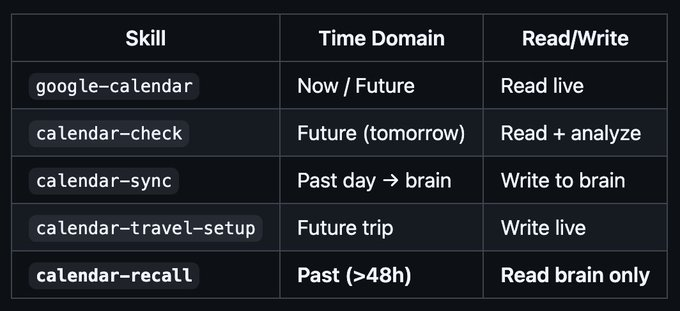
DRY 审计和它一起跑。如果你不小心,最后会有十五个技能差不多做同一件事,解析器就随便挑一个。对 calendar-recall:
(这里原文有一个表格,显示四个同域技能零重叠,每个都有自己的赛道。这个矩阵不是为这篇帖画的图,它就活在 SKILL.md 里,审计脚本会解析它。如果你建第六个日历技能踩到别人赛道,审计就会失败,技能就发不出去。)
Step 9: E2E smoke test 完整的端到端流水线。 问 Agent “我什么时候去新加坡的?”,验证它跑了 calendar-recall.mjs、得到正确答案、格式也正确。 问“我的下一个会议是几点?”,验证它跑 context-now.mjs 而不是自己脑算。
冒烟测试是最后一道防线。其他所有测试都通过,系统还是可能失败——如果各个部件没连起来。技能可能正确、脚本可能正确、解析器可能正确,但 Agent 还是可能无视一切自己即兴发挥。冒烟测试就抓住这种问题。
Step 10: Brain filing rules 每个往知识库写东西的技能,都必须知道东西该放哪里。人放 people/,公司放 companies/,政策分析放 civic/。我抓到 13 个写 brain 的技能里有 10 个放错目录,因为它们各自硬编码路径,而不是去查解析器。
归档规则文档记录了常见的错放模式。来源 vs 原文。人 vs 公司(当某人本身就是一家公司时)。技能在创建任何页面前都会先读这些规则。从此零错放。
GBrain:skillify 存在的地方,你应该从我的 GBrain Skill Pack 采用它 skillify 模式不专属于 OpenClaw 或任何特定外壳。它已经内置在 GBrain 里。
GBrain 是我开源的知识引擎,它位于你使用的任何外壳之下。它管理你的 brain repo、运行评估、强制执行让技能持久的质量关卡。前面提到的 skillify 检查清单不是建议,而是 gbrain doctor 实际检查的内容。
gbrain doctor --fix 会自动修复 DRY 违规,把重复代码块替换成约定引用,全程由 git working-tree 检查保护,什么都不会被覆盖。
为什么 Hermes Agent 单独还不够 Nous Research 的 Hermes Agent 做了一件真正伟大的事:它有一个 skill_manage 工具,让 Agent 自己根据学到的东西创建、修补、删除技能。当 Agent 完成复杂任务或从错误中恢复时,它会提议一个技能并写到磁盘上。这是 Agent 自己赚来的程序性记忆。渐进式披露(先加载技能索引,只有选中时才拉完整 SKILL.md)。有界记忆(MEMORY.md 限制在 2200 字符)。条件激活(缺少所需工具时技能自动隐藏)。设计很聪明。 但 Hermes 不测试它的技能。没有确定性代码的单元测试。没有解析器评估来验证路由。没有 check-resolvable 来找暗技能。没有 DRY 审计来抓重复。没有每天的健康检查——一旦漂移就变红。
我在任何未测试的技能系统里看到的失败模式不断积累: Agent 周一创建了 deploy-k8s,周四又从另一个对话创建了 kubernetes-deploy。两个都存在,都对类似短语触发。路由歧义,直到错误的一个在错误时间触发才被发现。 技能写的时候完美无缺。六周后上游 API 改了结构。技能默默返回垃圾,直到人类发现。 一个自动创建的技能触发器太弱,从来没匹配过。它变成孤儿,吃索引 token,永远不跑,慢慢腐烂。
这就是“没有测试,任何代码库都会腐烂”——软件工程 2005 年就解决的问题。Agent 技能也没什么不同。Hermes 把创建做得漂亮。GBrain 把验证做得漂亮。你需要两者结合。
核心理念 在一个健康的软件工程团队里,每个 bug 都配一个测试。这个测试永远存在。bug 在结构上变得不可能再发生。AI Agent 也该这样。
每一次失败都变成一个技能。每个技能都有评估。每个评估每天都跑。Agent 的判断力永久提升,不只是当前会话,不只是上下文窗口还活着的时候。
那次行程失败不会再发生。时区失败不会再发生。当下一次失败出现时(一定会,因为这是一场对抗熵和品味的对抗赛),它也会被 skillify。
一年后的 Agent,将被它过去一年犯过的每一个错误塑造。这不是锦上添花,这是整个论点的核心。
把海煮沸。让你的 Agent 先做点什么,然后 skillify 它。你每天都这么做,就会拥有一个该死的聪明 OpenClaw,它能做你想让它做的任何事。
或者你直接加载 GBrain,用我已经写好的所有代码,跳过前面的步骤,更快地拥有你自己的《钢铁侠》里的 Jarvis。
Github:github.com/garrytan/gstack
 AI 速览