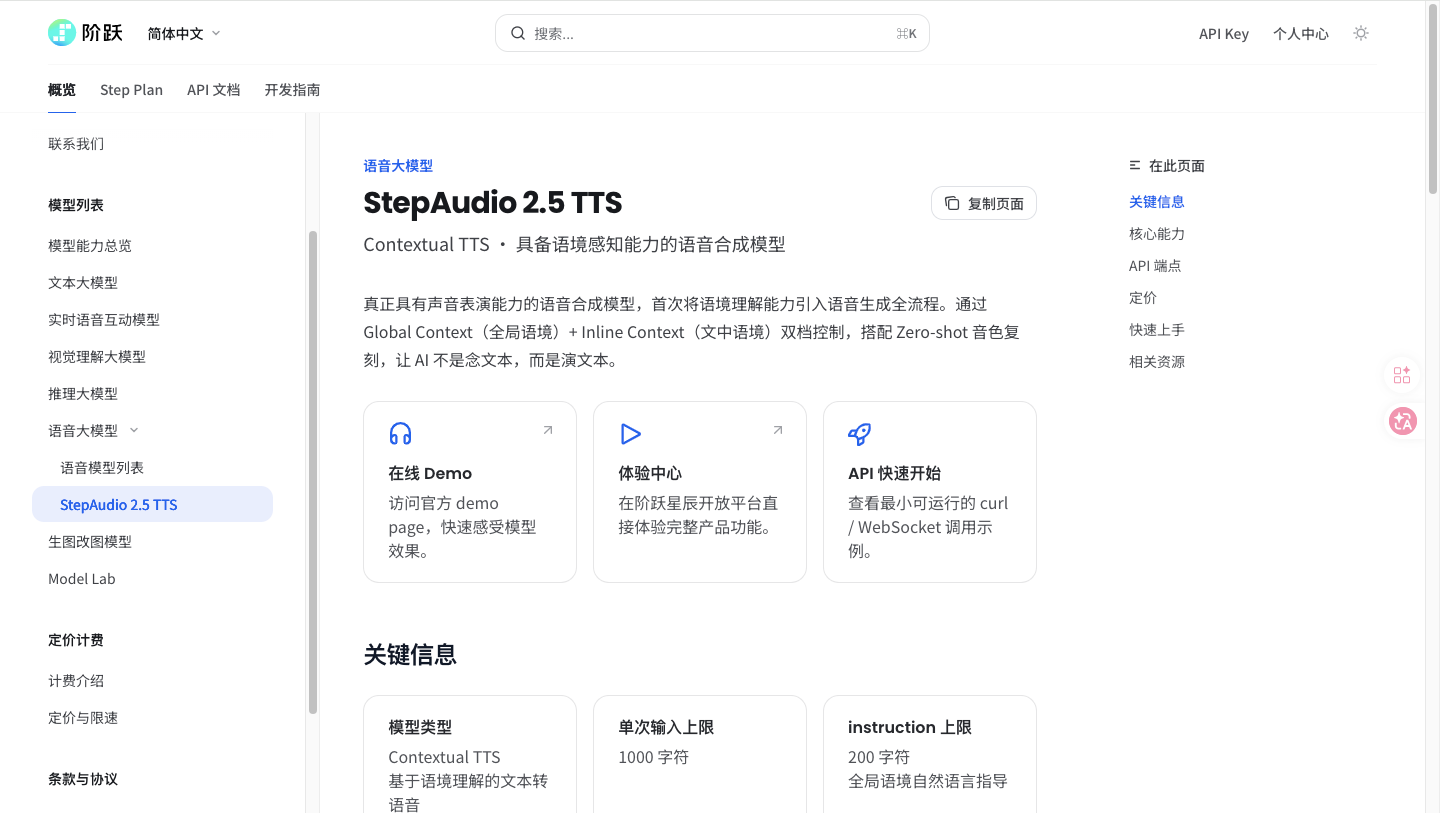
4 月 16 日消息,阶跃星辰在开放平台上线新一代语音合成模型 StepAudio 2.5 TTS,定位为 Contextual TTS——具备语境感知能力的语音合成模型。升级围绕全局语境 + 文中语境双档控制、零样本音色复刻,以及人声品质提升三项能力展开,面向角色配音、有声内容创作和智能语音交互场景。
双档语境控制:从情绪标签走向自然语言指令
StepAudio 2.5 TTS 将语境理解能力引入语音生成全流程,通过 Global Context(全局语境)与 Inline Context(文中语境)两档控制实现表现力调度。全局语境通过 instruction 参数定义整段基调,上限 200 字符;文中语境则在文本中用圆括号 () 逐句插入指令精控情绪、停顿、气息,且括号内的内容仅作为指令处理、不会被朗读。
和行业主流基于情绪枚举标签(happy / angry / sad)的控制方式不同,StepAudio 2.5 TTS 使用自然语言描述作为控制接口,官方给出的示例为"克制的悲伤,不哭腔,轻轻发颤"这类复合意图。单次输入文本上限为 1000 字符。
3 秒音色复刻与人声品质升级
复刻能力方面,StepAudio 2.5 TTS 仅需 3 秒参考音频即可完成音色复刻,并完整继承全局与文中语境控制能力——相比阶跃此前 step-tts-2、step-tts-vivid 约 10 秒的参考音频要求,样本门槛进一步降低。官方同步强调在停顿、重音、节奏、语气转折等韵律维度均做了底层升级,目标是摆脱传统 TTS 的"塑料感"。
定价与接入:5.8 元/万字符,三个端点
StepAudio 2.5 TTS 已上线阶跃开放平台,定价分两档:基于语境理解的文本转语音为 5.8 元/万字符;语音复刻按 9.9 元/音色收取,试听接口仅收合成费用,正式复刻成功即收费。接入方式提供三个端点:非流式合成(POST /v1/audio/speech)、WebSocket 流式合成(低时延对话与实时播放场景)、复刻试听预览接口(不创建正式音色资产)。
竞品对比:TTS 赛道分化出「语境理解」主线
2026 年 TTS 厂商的技术路径正在分化。MiniMax Speech 2.8 在 Turbo/HD 双档架构下将情绪模式扩展到 7 种,重点投在音色复刻相似度上;阿里 Qwen3-TTS 的声音复刻 API 需要 10~20 秒音频生成定制音色,主打 VoiceDesign 语言描述造音;阶跃自家 2025 年 11 月开源的 Step-Audio-EditX 以 3B 参数 LLM 架构专注情绪、说话风格和副语言的可迭代编辑。StepAudio 2.5 TTS 的差异化切口是"双档语境 + 自然语言指令",3 秒的复刻样本需求在主流商用 TTS 中也属较低水平。
局限与待观察
官方尚未公开 StepAudio 2.5 TTS 的模型参数规模、推理延迟数据及公开评测分数,也未披露是否会同步开源 。自然语言 instruction 在模型端的稳定解析能力、跨方言与多语种场景的表现,以及整本有声书级别跨段落情绪连贯性,仍需等待开发者实测。此外,新版本与 step-tts-2、step-tts-vivid 的共存与迁移策略,阶跃暂未说明 。
 AI 速览