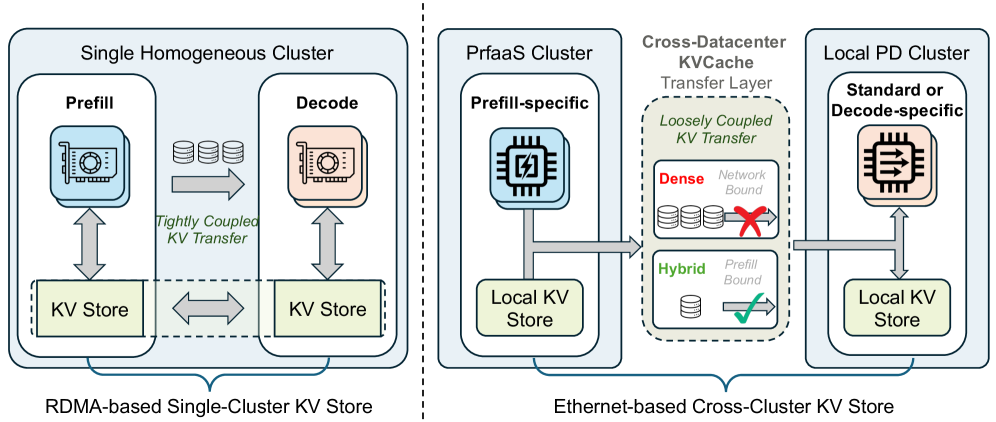
这篇论文的作者阵容延续了月之暗面此前 Mooncake 的核心班底(Ruoyu Qin、Weiran He、Mingxing Zhang 等),核心结论是:在 1T 参数混合注意力模型上,PrfaaS-PD 相比 96 卡 H20 同构 PD 基线吞吐提升 54%、P90 TTFT 降低 64%,相比 naive 异构 PD 提升 32%,而跨数据中心 egress 带宽仅占用 100 Gbps 链路的 13%。这意味着 PD 分离的部署边界首次从 RDMA 机柜扩展到跨城级 VPC/专线——而这件事之前被视为基本不可能。
PrfaaS 的价值不在于提出了新的注意力机制或训练技术,而在于重新定义了"异构 PD 部署"在工程上的可行性边界。对所有正在做大模型推理服务的团队来说,这是继 Mooncake、DistServe、Splitwise 之后一篇必须研读的系统论文。
一、为什么 PD 分离长期卡在单集群内?带宽墙的由来
PD 分离(Prefill-Decode Disaggregation)已经成为大规模 LLM 服务的事实标准架构,原因是 prefill 和 decode 的硬件诉求完全不同:prefill 是计算密集型(吃算力),decode 是内存带宽密集型(吃 HBM 带宽)。DistServe、Splitwise、Mooncake 等系统已经验证,把这两个阶段拆开部署可以同时提升吞吐和降低成本。
但"异构 PD"这一更激进的设想——让 prefill 跑在 NVIDIA Rubin CPX 这类计算密集芯片上、decode 跑在 Groq LPU 这类高带宽芯片上——却一直难以真正落地。核心症结只有一个:KVCache 传输量太大。
在传统稠密注意力(dense attention)模型中,prefill 阶段产生的 KVCache 体积随序列长度线性增长,动辄数十 GB。论文给出了关键数据:MiniMax-M2.5 这类基于 GQA 的稠密模型,在 32K token 输入下单实例产生 KVCache 的速率约为 60 Gbps(单机 egress 需求);若一个集群有 512 张 H200,那么聚合 egress 需求会直接飙到 3.8 Tbps——这种带宽需求把 PD 部署死死钉在同一个 RDMA 机柜内,一旦跨集群传输就会立刻成为新的瓶颈。
这也是 Splitwise/DistServe 等前作所处的语境:它们默认 prefill 和 decode 在同一个低延迟网络域内,所以 KVCache 传输几乎"免费"。一旦要跨 RDMA 域,前人的设计全部失效。
另一个被低估的问题是异构硬件的比例刚性:一旦把 prefill 芯片和 decode 芯片塞进同一个紧耦合集群,prefill/decode 的比例就被硬件物理布线锁死。而真实流量中请求长度分布、前缀缓存命中率时刻波动,同构集群可以把任意机器在两个角色间动态切换,异构集群做不到——这直接导致异构 PD 在生产环境中长期"理论上美好、工程上别扭"。
二、关键变量:混合注意力架构把 KVCache 体积压缩一个数量级
PrfaaS 之所以能在 2026 年被提出来,底层推动力是模型架构侧的一场静默革命。
2025 年下半年开始,一批旗舰开源模型开始把少量 full-attention 层与大量线性复杂度层(如 Kimi Delta Attention、Gated Delta Networks、Lightning Attention)或 Sliding Window Attention 交织使用,形成"混合注意力栈": 在 8×H200 + SGLang v0.5.9 环境下实测的 KV 吞吐(Gbps)差距触目惊心:
- 32K 长度下,MiMo-V2-Flash 仅 4.66 Gbps,MiniMax-M2.5 高达 59.93 Gbps,压缩比约 13×
- 同等尺度下,Qwen3.5-397B(8.25 Gbps)vs Qwen3-235B(33.35 Gbps),压缩比约 4×
- Ring-2.5-1T 上,MLA 相对 GQA 带来 4.5× 压缩,7:1 混合比例再带来约 8× 削减,整体 KV 内存节省约 36×
512 卡 H200 集群在 32K 平均长度下,Ring-2.5-1T 的聚合 egress 需求下降到约 170 Gbps;如果只把 128K 级超长请求路由进来,这个数字可以压到 100 Gbps 以下——首次进入现代跨数据中心专线的承载能力范围。
但 PrfaaS 论文极度克制地指出:"plausibility is not yet practicality"(可行不等于实用)。混合架构把带宽墙从"根本不可能"拉到"勉强可能",但真实流量有突发、长度严重偏斜、前缀缓存不均、链路抖动——如果无脑全部外置 prefill,照样会拥塞、排队、低利用率。模型侧的进步创造了窗口,真正把窗口变成方案的是系统侧设计。这也是 PrfaaS 与单纯"换个模型"方案的根本区别。
三、PrfaaS-PD 架构拆解:三大子系统 + 选择性卸载
PrfaaS-PD 系统由计算、网络、存储三大子系统构成,核心设计哲学是**"选择性外置"**而非全面分离。
计算子系统:集群分两类。
- PrfaaS 集群:同构计算密集型芯片(H200 级别,或未来的 Rubin CPX),只处理增量长度 l > t 的长上下文 prefill,完成后把 KVCache 通过商用以太网流式传输到 PD 集群
- 本地 PD 集群:同构带宽优化型芯片(H20 级别),跑常规 PD 分离服务,独立处理短请求的全流程(prefill + decode)
网络子系统:两层结构。集群内部使用 RDMA 承载延迟敏感的集合通信和 PD KVCache 传输;集群之间依靠 VPC peering 或专线承载跨数据中心 KVCache 传输——后者只需要商用以太网级别的带宽。
存储子系统:每个集群内部构建分布式混合前缀缓存池(Hybrid Prefix Cache Pool)。这是整篇论文一个容易被忽视但工程上至关重要的创新:混合注意力模型的两种状态必须分开管理——
- 线性层的循环状态:request-level,体积固定、与长度无关,只能整请求复用(精确命中)
- Full-attention 层的 KVCache:block-level,体积随长度线性增长,支持前缀部分命中
论文在 vLLM 的 hybrid KVCache manager 基础上,让两种 cache group 使用对齐的 block size 从共享池里独立分配/回收。在共享池之上再把 block 进一步分为两类:prefix-cache block(必须完整写满才能跨请求复用,只在集群内流通)和 transfer-cache block(承载 prefill 尾部 KVCache,传输完成后即丢弃,用于跨集群传输)。这种设计让跨集群传输与本地复用在存储层完全解耦。
选择性卸载的路由规则极其简洁:设 l 为请求的增量 prefill 长度(扣除前缀缓存命中部分),t 为路由阈值。
- l > t:请求路由到 PrfaaS 集群,prefill 完成后 KVCache 跨集群传输到 decode 节点
这一刀切得非常关键——短请求本身是 memory/communication bound,算力利用率低,硬塞进 PrfaaS 反而浪费高算力芯片、白占跨集群带宽。选择性卸载让 PrfaaS 专注于它最擅长的场景:长上下文、低前缀命中率、计算受限的 prefill。
传输层的工程实现同样值得借鉴:layer-wise prefill pipelining(层级流水线,重叠 KVCache 生成与传输)+ 多连接 TCP(跑满以太网带宽)+ 拥塞监控与调度器联动(检测丢包/重传信号提前干预)。这三招是商用以太网承载 KVCache 传输的工程前提。
四、双时间尺度调度:短期动态路由 + 长期资源再分配
如果说架构设计回答了"怎么拆",调度设计回答的则是"怎么动态适配"。PrfaaS 的调度器拆成两个时间尺度运行。
短期:带宽与缓存感知路由。调度器持续监控 PrfaaS egress 利用率与请求队列深度。利用率接近阈值或排队激增时,立即触发路由策略调整。对有前缀缓存命中的请求,路由决策要同时考虑缓存亲和性与带宽可用性:
- 带宽紧张时:各集群的前缀缓存独立评估。若 l_total - l_pd ≤ t,本地 prefill;否则卸载到 PrfaaS。不做跨集群缓存传输
- 带宽充裕时:算力成为稀缺资源,此时可以跨集群传输缓存以减少重复计算。取 l_prefix = max(l_prfaas, l_pd),若 l_total - l_prefix ≤ t,在 PD-P prefill;否则在 PrfaaS。若最优缓存所在集群与计算集群不一致,执行一次跨集群 cache 迁移
长期:流量驱动的分配再优化。在更长时间尺度上,流量波动会造成 pipeline 各阶段持续性失衡。调度器通过对比 Θ_prfaas + Θ_pd-p 与 Θ_pd-d 判定瓶颈侧,周期性重新评估负载并在 PD 集群内部把节点在 prefill 与 decode 角色间转换,调整 Np 和 Nd 恢复最优平衡,同时重新优化路由阈值 t。
论文给出了严格的解析吞吐模型:
- Prfaas 集群吞吐 Θ_prfaas = min(N_prfaas/T_prefill(l_long), B_out/S_kv(l_long))——取算力和带宽的较小值
- PD-P 吞吐 Θ_pd-p = N_p/T_prefill(l_short)
- PD-D 吞吐 Θ_pd-d = N_d·BS_max/(T_decode·L_out)
- 端到端吞吐 Λ_max = min(Θ_prfaas/p, Θ_pd-p/(1-p), Θ_pd-d)
最优配置满足两个方程:Θ_prfaas/p = Θ_pd-p/(1-p)(两个 prefill 通路饱和)和 Θ_prfaas + Θ_pd-p = Θ_pd-d(总 prefill 供应等于 decode 消费)。这两个方程约束 t 和 Np/Nd 两个未知数,可通过二维网格搜索求解。这个建模的价值在于——它把"异构 PD 部署"从经验调参问题转化成了显式优化问题。
五、1T 模型 Case Study:54% 吞吐提升与 13 Gbps 带宽的完整拆解
论文用内部 1T 参数混合模型(Kimi Linear 架构,KDA:MLA = 3:1)做了完整的部署实证。
硬件配置:
- PrfaaS 集群:32 张 H200(计算密集)
- 本地 PD 集群:64 张 H20(带宽优化,节点内 800 Gbps RDMA)
工作负载:请求输入长度服从截断对数正态分布(μ=9.90, σ=1.00, 截断到 [128, 128K]),均值约 27K token,接近真实长上下文业务形态。输出长度固定 1024,SLO 40 tokens/s。
关键求解结果:
几个值得拎出来的结论:
1. 跨数据中心带宽消耗极低。阈值 t=19.4K 下 49.6% 请求路由到 PrfaaS,这部分请求平均增量长度约 44K token,聚合 egress 负载仅 13 Gbps,占 100 Gbps 链路的 13%。作为对比,同等规模的 MiniMax-M2.5 稠密模型需要 3.8 Tbps——混合架构与 PrfaaS 调度的组合直接把带宽需求压缩了两个量级。
2. 54% 吞吐提升的来源可拆解。PrfaaS 集群的高算力让 H200 扛下了绝大部分长上下文 prefill,本地 PD 集群省下 2 个 prefill 实例位置用于扩容 decode(3+5 vs 同构的 9+3),pipeline 各环节更平衡。论文也诚实指出,同等成本下(H200 价格更高)吞吐增益约 15%——54% 是吞吐绝对值对比,15% 是成本效率对比,采购决策时要看清楚。
3. 比 naive 异构 PD 高 32% 的差距说明调度不可省。naive 方案里所有 prefill 都去 H200、所有 decode 都去 H20,没有长度路由也没有负载均衡,结果 prefill/decode 吞吐严重失衡(2.45 vs 6.25),只能跑到 1.16× 于同构基线。换句话说——光换异构硬件不做调度,70% 以上的潜在收益会被浪费。
4. PrfaaS 侧带宽仍有巨大余量。13% 链路利用率意味着 PrfaaS 集群目前是算力瓶颈而非带宽瓶颈,扩 PrfaaS 规模可以继续线性提升吞吐。论文估算 IDC 级(数千张 PrfaaS GPU)部署聚合 egress 约 1 Tbps,仍在现代数据中心 fabric 能力范围内。
六、风险与局限:PrfaaS 不是万能药
尽管结果亮眼,PrfaaS-PD 有几个必须正视的前置条件和局限,否则照搬会翻车。
强绑定混合注意力架构。整篇论文的带宽可行性完全建立在混合模型 KVCache 体积比稠密模型小一个数量级的前提上。如果继续服务纯 GQA/MLA 稠密模型(如 Qwen3-235B、MiniMax-M2.5),KVCache 吞吐仍在 30-60 Gbps/instance 量级,跨数据中心部署完全不可行。没有混合架构的"模型侧基础设施",就没有 PrfaaS 的"系统侧上层建筑"。
对请求长度分布敏感。论文假设输入服从截断对数正态(均值 27K),PrfaaS 在"长尾占比高"的场景收益最大。如果业务以短上下文聊天为主(平均长度几 K),PrfaaS 适用的请求比例会骤降,高算力芯片的投资回报会大幅恶化。PrfaaS 本质上是给长上下文 agentic 场景量身定做的——代码生成、长文档分析、多轮工具调用,越长越受益。
跨集群带宽稳定性是隐性依赖。VPC 网络 100 Gbps 只是标称值,真实链路有抖动、丢包、突发。PrfaaS 的 TCP 多连接、拥塞监控、带宽感知路由都在应对这个问题,但跨城/跨运营商专线的长尾延迟仍可能吃掉收益。论文在公网 VPC 环境下的表现并未给出数据。
调度器自身是复杂度源头。双时间尺度调度、三变量优化(Θ_prfaas、Θ_pd-p、Θ_pd-d)、混合前缀缓存池的元数据一致性——任何一个环节实现走样,性能都会直接塌陷。这类系统的工程门槛远高于普通 PD 分离,没有 Mooncake 级别经验积累的团队直接照抄风险很大。
硬件搭配的议价权问题。论文选择 H200 + H20 是因为月之暗面能拿到这个组合。对大多数中小云厂商和自建团队而言,"计算密集+带宽密集"的异构 GPU 组合在采购、机房、运维层面都有额外成本——PrfaaS 的"硬件选型自由"在论文里是优势,在现实里可能是采购难题。
与主流框架的集成度待验证。论文基于 vLLM 自研 fork 实现,SGLang/Dynamo 等框架的原生支持尚未公开。对于重度依赖开源推理栈的团队,短期内需要自己补上胶水代码。
七、行业影响与选型建议
PrfaaS 的真正价值不止于一个 54% 的吞吐数字,而是提出了一个推理基础设施的新范式:当模型架构把 KVCache 从"必须 RDMA 级"降到"以太网可承载"级别时,整个推理服务的部署边界会从机柜/集群扩展到 region 级甚至跨城级。这对行业的几个影响值得提前布局:
对大模型服务商:如果你已经在服务 Kimi Linear、Qwen3.5、Ring-2.5-1T、MiMo-V2-Flash 这类混合模型,PrfaaS 就是你下一阶段的基础设施升级方向。优先评估三件事——长上下文请求占比(建议 >30%)、现有机房是否有异构硬件闲置(可用于搭建 PrfaaS 集群)、跨集群专线带宽(100 Gbps+ 为宜)。Mooncake 用户几乎可以无缝演进,因为 KVCache-centric 的设计哲学一脉相承。
对混合架构模型方:PrfaaS 变相印证了"混合注意力"在生产部署中的带宽红利——这件事 Moonshot(Kimi Linear)、小米(MiMo-V2-Flash)、阿里(Qwen3.5)、蚂蚁 inclusionAI(Ring-2.5-1T)、NVIDIA(Nemotron 3 Nano)已经在做。没跟上的模型团队要认真评估:一个不友好于跨集群部署的稠密模型,在 agentic 长上下文时代的商业化路径会越走越窄。
对 AI 芯片厂商:PrfaaS 移除了"异构芯片必须共享低延迟 RDMA"这个约束后,prefill 专用芯片(Rubin CPX 方向)和 decode 专用芯片(Groq LPU、Taalas HC1 方向)可以各自独立发展规模,不再被迫打包销售。"按阶段专业化"的芯片路线图从理论假设变成了可部署路径。
对中小团队:先别急着复刻 PrfaaS。如果你的业务还在解决"PD 分离 + 单集群调优"这个阶段(绝大多数团队的现状),精力应该放在 Mooncake/DistServe 级别的基础 PD 架构上。PrfaaS 是金字塔顶的优化——它的前置条件是你已经把单集群 PD 榨干。盲目超前没有意义。
对观察者:关注接下来几个月 vLLM、SGLang、Dynamo 是否会把 PrfaaS 相关能力(混合 KVCache 管理、跨集群传输、双时间尺度调度)纳入主线。一旦被三大主流推理框架之一原生支持,这套范式将从 Moonshot 的内部实践变成行业标准——时间窗口大概率在 2026 年底之前。
PrfaaS 是月之暗面把自己踩过的坑系统化为可复用工程蓝图的一次开源。对所有认真做大模型推理的团队,这份蓝图的工程密度远高于多数同类论文——值得打印出来反复读。
 AI 速览