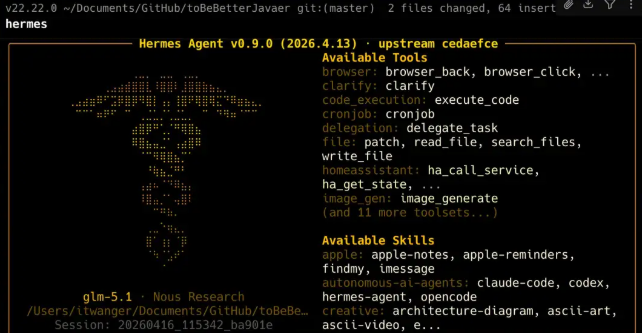
这两天在折腾Hermes Agent的新版本,发现它在上下文管理上的改进确实挺有意思。特别是在求职面试时,这些细节都能成为不错的话题。Hermes的上下文压缩、Memory机制、插件架构这些,都是面试官可能会问到的东西,今天咱们就好好聊聊这些机制怎么运作的。 两层防线的上下文管理
你可能遇到过这种情况——跟AI聊着聊着,突然报错说上下文超了。Hermes现在用了两层防线来解决这个问题。
第一层在Gateway那边,它设定的阈值是上下文窗口的85%。这层就是简单粗暴的保险——防止请求直接被API拒绝。它不干什么精细活,只是确保你的请求能送出去。
第二层才是真正干活的角色,叫ContextCompressor,默认在你用到50%上下文时就激活。举个例子,你用的是Claude的200K上下文,那么大概用到100K token的时候,它就开始工作了。不过它聪明的地方在于会预留20K token来保护你最近的对话,确保你和Hermes的最新互动不会被无情地删掉。 压缩的整个过程分四个阶段。第一阶段直接砍工具输出,那些超过200个字符的工具返回结果就替换成占位符,这步不需要调模型,纯文本处理,速度贼快。
第二阶段划定保护区。系统保护最前面3条消息(通常是系统提示词和开场对话)和最后20条消息(你最近的交互),中间的部分标记为待压缩区。这里有个细节做得还不错——tool_call和tool_result的配对不会被拆散,不会出现只有调用没有结果的鬼情况。
第三阶段是生成结构化摘要,这是核心。以前就是直接删,现在会调个辅助模型来生成摘要。摘要不是简单的"之前聊了啥",而是按照固定模板,涵盖目标、进度、关键决策、涉及的文件、下一步计划这五个维度。摘要的token预算是动态的,按被压缩内容的20%来分配,范围在2K到12K之间。
第四阶段拼装消息,把头部保护区、生成的摘要、尾部保护区重新组合,同时清理那些因为压缩产生的孤儿工具调用。
最关键的进步是后续压缩会更新已有摘要,而不是重新生成。这样信息就不会因为多次压缩导致细节越来越多地丢失。
你可以主动控制压缩了
新版加了个实用功能叫/compress命令。以前压缩全是系统自动触发,你根本没权利控制。现在可以主动压缩,还能指定焦点主题。
比如你跟Hermes聊了很长一段关于数据库优化的内容,中间穿插了些闲聊和其他任务,你就可以输入/compress数据库优化,它就会在压缩时重点保留数据库优化相关的上下文,那些不相关的内容优先压缩掉。
这个设计挺聪明的,等于给了你"选择性遗忘"的能力——你告诉Hermes什么重要,它就记什么。
可插拔的上下文引擎
v0.9.0把上下文管理做成了一个可插拔的插件槽,你可以通过hermes plugins来切换不同的上下文引擎,甚至自己写一个。
默认用的是内置的ContextCompressor,但如果你有特殊场景——比如做法律文档分析,需要保留所有的条款引用不被压缩——你可以写个自定义上下文引擎,只压缩非条款内容。
插件放在plugins/context_engine/<name>/目录下,需要继承ContextEngine这个抽象基类。这对企业级应用挺有价值的。做客服系统可能希望永远保留订单信息不被压缩,做代码审查可能希望保留所有文件变更记录。不同场景对"什么该压缩什么不该压缩"的需求完全不一样。
怎么安装和配置
如果你之前装过Hermes,更新到v0.9.0很简单,在Codex里输入hermes update就行,它会自动拉最新代码和处理依赖。
全新安装的话,运行这条命令:
安装脚本会自动检测你的系统,把Python 3.11、Node.js、Git这些依赖全搞定。装好后跑hermes step进入配置向导,如果之前装过OpenClaw,配置可以直接迁移。
配置文件在~/.hermes/目录下。网关类型一般选local就行,跑在本地。如果要查看服务状态,在配置文件里加上API_SERVER_ENABLED=true,然后就能通过http://127.0.0.1:8642/health查看。
如果用的是GLM或其他模型,改好配置文件里的API Key。这里有个坑要注意——API Key过期的话Hermes的报错信息不够清晰,容易排查半天,最后才发现是密钥问题。
记忆系统怎么玩
Hermes的记忆分两层,这对AI Agent岗位求职挺重要的。
内置记忆默认开启,就两个文件:MEMORY.md存你的环境信息、项目经验、工具使用记录,USER.md存你的个人偏好和沟通习惯。每次开新会话,这两个文件会被注入到系统提示词里。这个设计跟Claude Code的CLAUDE.md很像,但Hermes是自动维护的,你不用手动编辑。用着用着它就越来越了解你了。 外部记忆是可选的增强层,同一时间只能启一个provider,支持honcho、mem0、hindsight这些。大部分场景下内置记忆就够用,除非你有跨多个项目、跨多台机器的记忆共享需求,否则别折腾外部记忆,配置复杂收益不大。
飞书接入要注意的坑
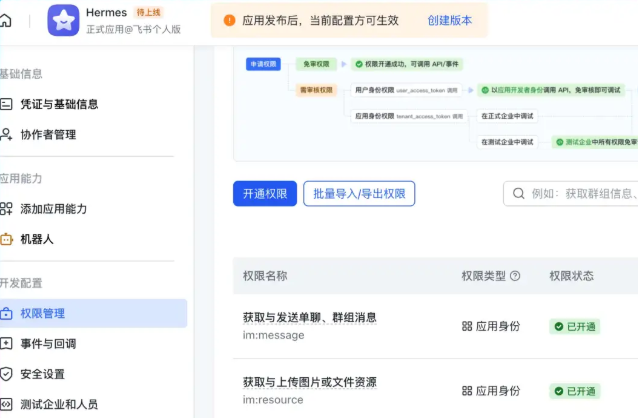
首先确认Gateway开着,运行hermes gateway status查看。去飞书开放平台创建应用,添加机器人能力,权限至少加im:message和im:resource。
在.env文件里配置飞书应用的ID和Secret,然后重启Gateway。在飞书控制台验证连接状态,事件订阅开通im.message.receive_v1,回调配置开通card.action.trigger。
有两个坑要踩过一次才知道:第一,.env里必须加GATEWAY_ALLOW_ALL_USERS=true,否则机器人收到消息不会响应。第二,飞书权限里"读取用户发给机器人的单聊消息"这个选项一定要勾上,不然就是发了消息没回音的情况。
新版本还新增了WeChat和企业微信的支持,后续可以接入。
实际效果怎么样
v0.9.0确实在上下文压缩上有明显改进,用起来不再像之前那样容易出现上下文爆炸的问题。不过新的问题有时候也会冒出来,比如terminal里的输出信息有时候不够清晰。
Hermes相比OpenClaw的优势在于自主进化能力和上下文管理。它会把你的操作习惯、常用流程沉淀成Skill,越用越顺手。新版还新增了本地Web Dashboard,现在可以在浏览器里管理Hermes的配置,不用每次都去命令行改文件,这对不太熟悉终端操作的人来说确实是个福音。
上下文压缩这个问题其实困扰着整个Agent生态,不止是Hermes。本质上,这是大模型有限上下文窗口和用户无限对话需求之间的矛盾。Hermes的四阶段压缩方案虽然不算完美,但方向是对的,相信后续还会继续进化。
对于想进AI Agent岗位的人来说,理解这些上下文管理的思路,比单纯学习模型参数有用得多。企业级Agent应用最终考的就是这种工程落地能力。
 AI 速览