8月3日消息,通义千问发布旗舰模型 Qwen3.8-Max,官方称其为 Qwen 家族迄今能力最强的模型。模型基于 Qwen 3.5 架构,总参数 2.4 万亿、激活参数 95B,支持 100 万上下文 Tokens,即日起可通过 Qwen Studio 与 API 使用。开放权重将于下周发布,届时 Qwen3.8-27B 也会一并公开。 2.4T 总参数、95B 激活,即日起开放使用
通义千问把 Qwen3.8-Max 定位为编程与协作方向的旗舰模型,官方称其以 2.4 万亿参数"树立编程与协作新标杆"。官方公布的架构细节包括:基于 Qwen 3.5 架构,激活参数 95B,支持 100 万上下文 Tokens。官方称,模型在编程、办公、科研与长周期任务上全面提升。模型即日起开放,用户可以在 Qwen Studio(chat.qwen.ai)直接对话,也可以通过千问 AI 平台的 API
从 16 天自主编程到量化策略
官方公布的能力描述里,自主编程的分量最重。GitHub 上公开的 oh-my-cli 项目轨迹显示:截至 7 月 30 日,模型完全自主运行约 16 天,从空文件夹到生产环境全程无需人工干预。仓库累计留下 265 次提交、127 个 PR 和 151 个 issues(github.com/qwen-code-dev-bot/oh-my-cli)。另一个案例是论文复现:官方称模型连续独立工作约 5 天,从零搭起训练与评测流水线,复现了一篇研究论文的六项主要结论,并在竞赛级数学基准 AIME24 上比原方法提升 2.7 分。
办公与专业工作是官方列出的另一条主赛道。在覆盖数百种职业的压力测试里,官方给出企业合规律师、结构工程师、体育数据分析师等案例。原本需要数天到一周的交付,被压缩到一小时或数十分钟。量化策略是其中规模最大的演示。官方称,模型调度约 330 个子智能体并行研究,完成约 6,000 次历史回测;交付的 ETF 轮动策略 Sharpe 达到 0.64–1.48。
长程任务与多模态
长周期任务方面,官方给出两个案例。芯片设计:模型在无参考设计、无人干预的条件下,单次不间断运行约 500 轮交互,把 GCD/RSA 密码硬件加速器从 8,298 门优化到 678 门。官方称,这是参评模型中的最优表现。电商经营:在模拟 365 天经营的 E-Commerce Bench 基准上,模型以 ¥100,000 启动资金运营多家网店,期末总现金相当于启动资金的 4.16 倍。官方称,这一成绩比第二名 GLM 5.2 高出 38%,比上一代 Qwen3.7-Max 提升 152%。
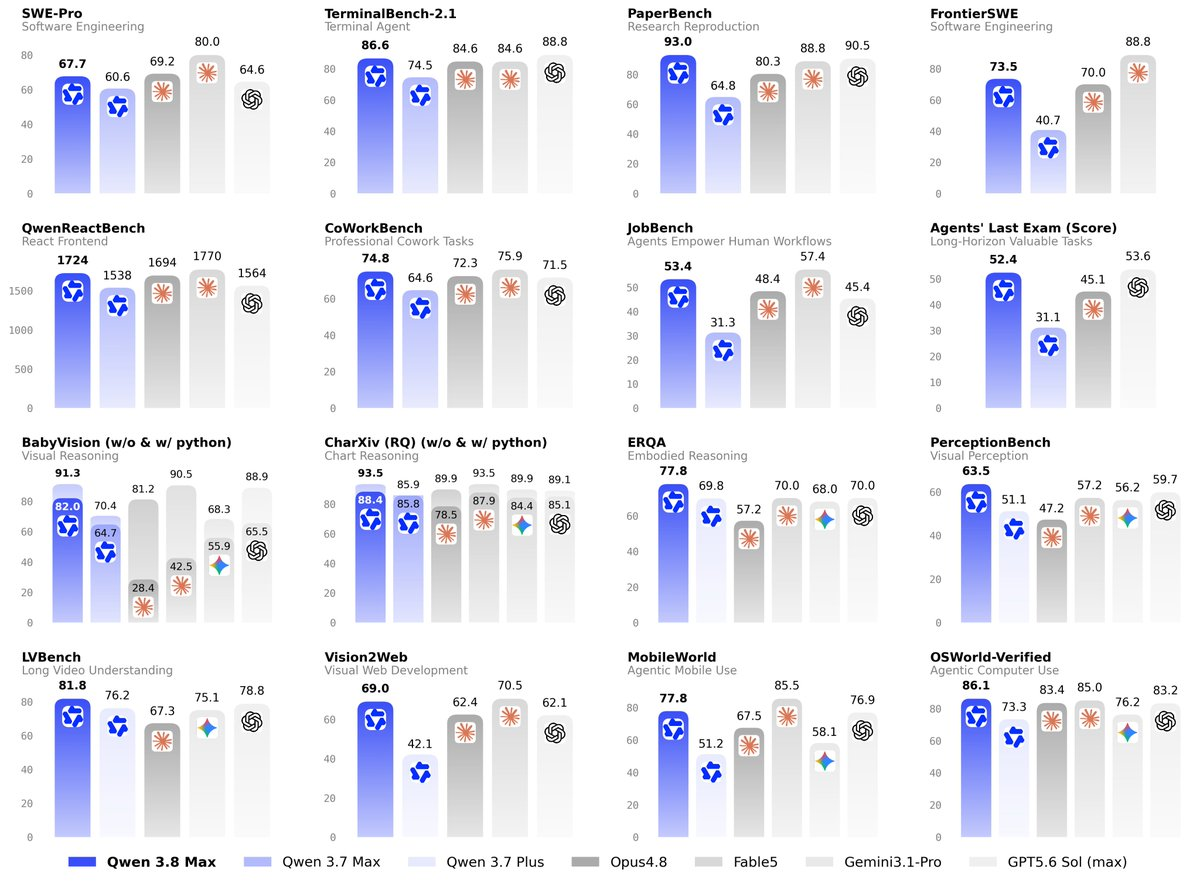
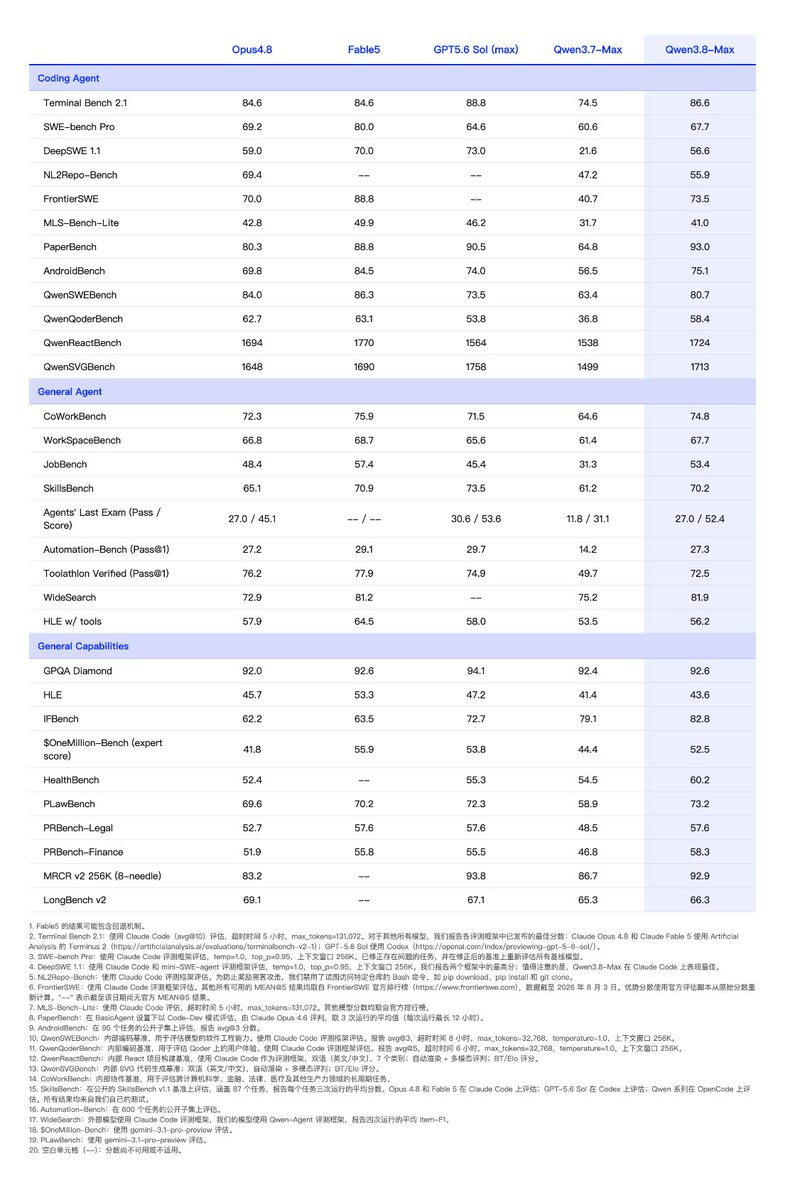
多模态部分,官方强调"混合智能体"概念:编程与 GUI 操作结合,模型边做边看、自我纠错。官方为此构建了 RecreationBench 基准,并推出即插即用的多模态扩展库 Qwen-MM-Plugins。性能参照上,官方引用的 Arena 榜单显示,Qwen3.8-Max 在 Text Arena、CodeArena、VisionArena 上分别位列第 2、第 3、第 2。官方还发布了语言与视觉性能对比。
开放权重下周发布,国内海外双定价
对开发者来说,本次发布最确定的节点是下周的开放权重:Qwen3.8-Max 与 Qwen3.8-27B 将一并公开,届时这套模型不再只能通过官方服务使用,可以自行部署、按自己的流程微调。27B 规格为算力有限的团队提供了更轻量的部署选项。
定价按国内与海外分两套:国内每百万 Tokens 输入 12 元、输出 36 元,隐式缓存命中 1.5 元;海外每百万 Tokens 输入 2、输出2、输出6,隐式缓存命中 $0.25。官方称,与海外相近智能的前沿模型相比,这个价格有更高性价比。
能力叙事从单次任务转向长周期闭环
这次发布最明显的差别在时间维度:衡量能力的单位,从一轮回答的表现变成了持续运行的时长与轮数。16 天的编程、约 500 轮的芯片设计、365 天的电商经营,都是按天和轮计算的数字;330 个子智能体并行、6,000 次回测,则是规模维度的数字。官方标题里的另一个关键词是协作:Cowork 被描述成"任何角色"都能参与的构建方式,与编程并列为新标杆。
另一处不同在展示方式:几乎每项能力主张都配了可核验的落点,从项目仓库的提交与 PR 数,到回测次数、芯片门数、期末现金回报,再到三大 Arena 榜单的引用。对开发者与需要自动化交付的企业用户,这是好消息:旗舰模型多了一个选择,开放权重意味着可以按自己的流程部署。这些数字目前全部是官方口径,一家公司发布的模型能说明的只有这家公司,实际水平要等社区拿到权重之后判断。
 AI 速览