月之暗面在4月20日正式发布并开源了 Kimi K2.6,代码能力和 Agent 能力都有明显提升。官方数据确实挺亮眼:13小时不间断编码、超过4000行代码修改、多项基准测试达到国际一流水准。拿到内测资格用了有一段时间了,现在正式版出来,把这套 Kimi K2.6 + Hermes + Obsidian 的用法完整分享出来,希望对你有用。 先说怎么上手Kimi K2.6
这套组合现在已经可以实际用了。不只是搭知识库,看技术视频做笔记、读行业报告提取关键信息、听播客整理要点、开会记录,都能用同一套方法跑通。
如果你想快速试起来,部署 Hermes 大概15分钟,初始化知识库5分钟,处理第一个视频10分钟。每一步的具体命令、截图和踩坑记录都在教程文档里,新手照着走半小时基本能跑通。
发现一:它真的在"看"视频,不是在"听"
最常用的场景就是丢一个B站视频链接给 Hermes,过一阵,一篇结构化笔记就落到 Obsidian 里了。
打开笔记的时候注意到一个细节:K2.6 不只是把音频转成文字,而是结合视频画面一起理解,生成的笔记里既有讲解内容,也有对画面元素的补充说明。这和单纯做语音转录的工具体验差距很明显。
整个流程 Hermes 会自动拆成几步:下载视频、转录成文稿、基于视频和文稿生成结构化笔记,最后按目录归位。生成的笔记不是流水账,而是按"核心观点、关键要点、行动建议"这种方式组织的,拿到手基本能直接用。
发现二:连续干活不掉链子
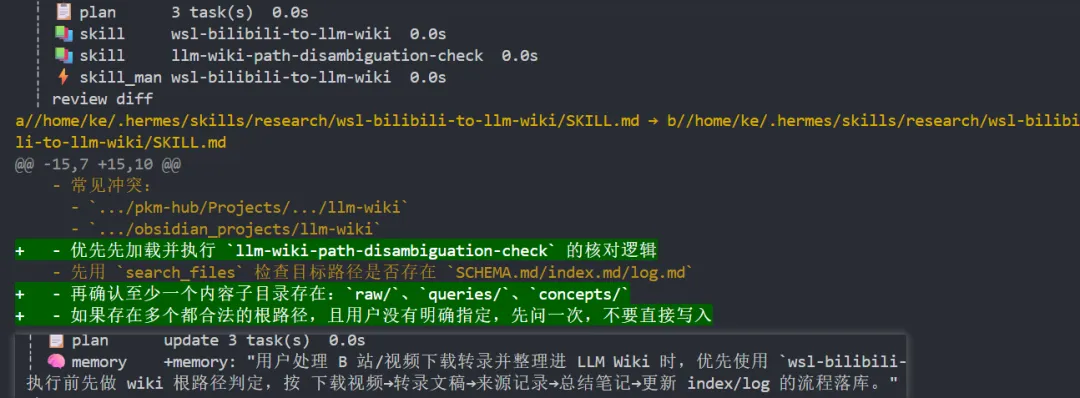
第一个视频跑通后,Hermes 会自动把整个流程沉淀成一个 Skill。下次处理新视频,只需要一句话:"用那个 Skill 处理这个视频。"
这是很多人第一次看 Hermes 会觉得惊讶的地方。它能自己总结经验封装成可复用流程,相当于越跑越顺手的自进化工具。
但 Skill 沉淀这件事对底层模型要求不低。需要模型准确理解每一步在做什么、哪些是通用步骤、哪些是当次特有的,然后抽象成可复用的流程。如果长程推理不够稳,要么抽象得太浅,下次还得重新写;要么太死板,换个视频就跑不通。
K2.6 官方展示的案例里,有一个场景是对一个运行了8年的开源金融撮合引擎进行性能优化——13小时、1000多次工具调用、修改超过4000行代码,最终实现吞吐量中位数提升185%。这种长程稳定执行的能力,在知识管理场景里同样能感受到:一条完整链路跑下来,上下文始终连贯,结构化输出也没有跑偏。
发现三:知识库在自己进化
处理完几个素材之后,知识库有了一定规模。这时候一般人整理笔记会遇到的问题:新内容进来不知道放哪,旧笔记和新笔记讲的是同一件事却互相打架,最后堆成大杂烩。
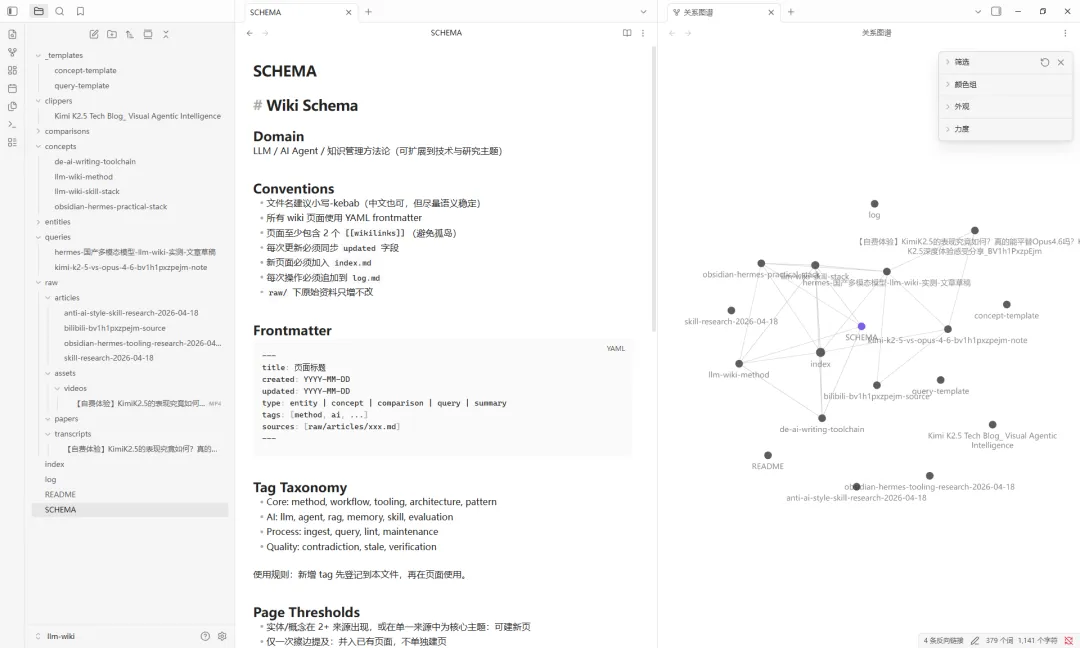
但在 LLM Wiki 里,看到的是相反的现象:相关概念自动关联,重复信息自动合并,冲突观点并列记录。
这套机制依赖 SCHEMA.md 里定义的规则:什么时候新建页面、什么时候并入已有页面、遇到不同视频对同一概念有不同解释时怎么处理。规则定好之后,K2.6 每次处理新素材都照着执行。半年前看的一篇文章,今天看到另一个视频讲同一件事,它能自己把两者关联起来。
判断正不正确,底层模型很关键。SCHEMA.md 把规则写死只是第一步,真正难的是模型每次读内容时要同时做判断:该归到 entities 还是 concepts?该新建页面还是并入已有的?元数据填没填全?内部链接语法对不对?K2.6 的长程推理能力在这里体现得比较明显:结构化输出稳定按 SCHEMA 来,跑多少次格式都没乱过。
K2.6 能干的远不止这些
知识库只是一部分。官方还给出了一个 Agent 集群的案例:针对全球100个半导体标的设计并执行量化策略,K2.6 调度最多300个子 Agent、执行超过4000步协同操作完成交付。
这种规模的任务,单个 Agent 根本搞不定。K2.6 会自动拆解任务、创建不同角色的子 Agent 并行工作,最后汇总结果。
当然也有短板。文笔相比 K2.5 退步了一些,输出经常中英文混着来,做中文知识库时需要人工再顺一遍。上下文窗口256K,对于跑超长链路任务时,Hermes 需要频繁压缩 memory,偶尔会丢掉一些早期的上下文细节。
Kimi K2.6 现在可以通过 Kimi Code 免费试用。如果你手头有一堆视频、文章没时间消化,或者笔记越整越乱,不妨选个主题,把现有内容扔进去,让 K2.6 帮你把散落的信息变成真正属于自己的知识资产。
 AI 速览