2026 年 5 月,阿里通义千问正式推出Qwen3.7-Max旗舰大模型,凭借超强 Agent 长任务能力、全维度拔尖评测成绩以及超高性价比,引爆海外开发者圈层,成为国产面向 Agent 时代的标杆级模型,综合实力可对标并超越 Claude、GPT、Gemini 等国际顶尖模型。 一、市场定位突出,性价比碾压国际竞品
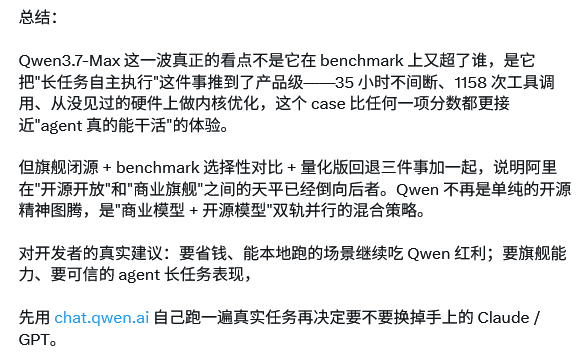
Qwen3.7-Max 标志着阿里调整模型布局,采用商业旗舰 + 开源模型双轨并行策略,重心向商业闭源旗舰倾斜,不再是单纯的开源精神图腾。
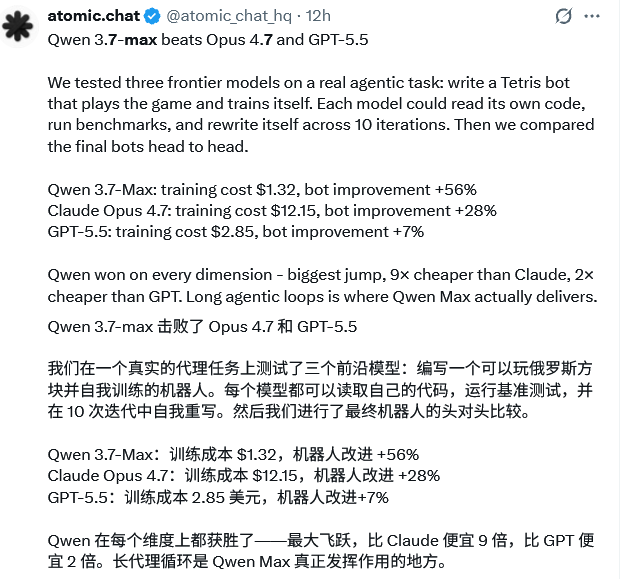
在市场对比中,该模型展现极强优势:实测性能击败 Claude Opus 4.7、GPT-5.5,价格比 Claude 便宜 9 倍,比 GPT 便宜 2 倍;
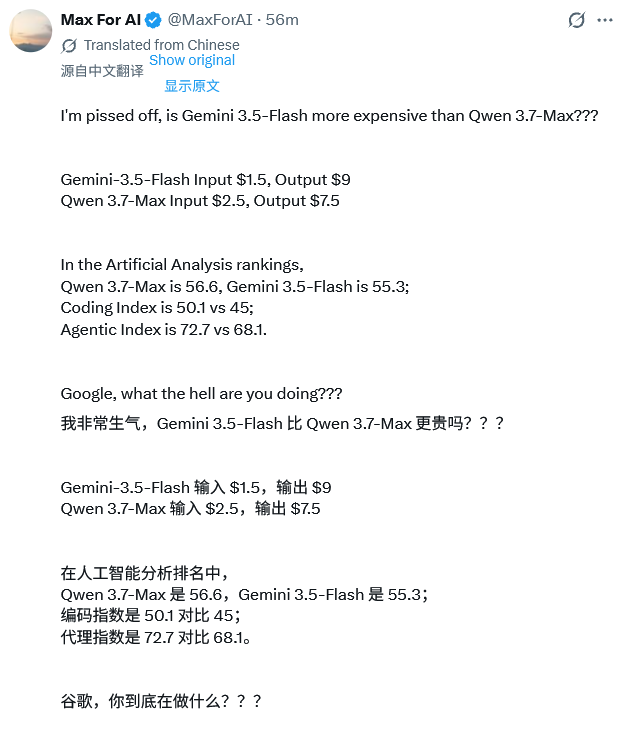
与 Gemini 3.5-Flash 对比后,不少开发者对谷歌模型表现倍感失望。
同时 Qwen3.7-Max 登顶 Artificial Analysis Intelligence Index 全球第五,前沿闭源模型面临强劲竞争压力。开发者建议,追求本地部署可选传统开源 Qwen,刚需旗舰 Agent 长任务能力,可实测替换 Claude、GPT。
二、全维度评测领跑,多项成绩位居全场第一
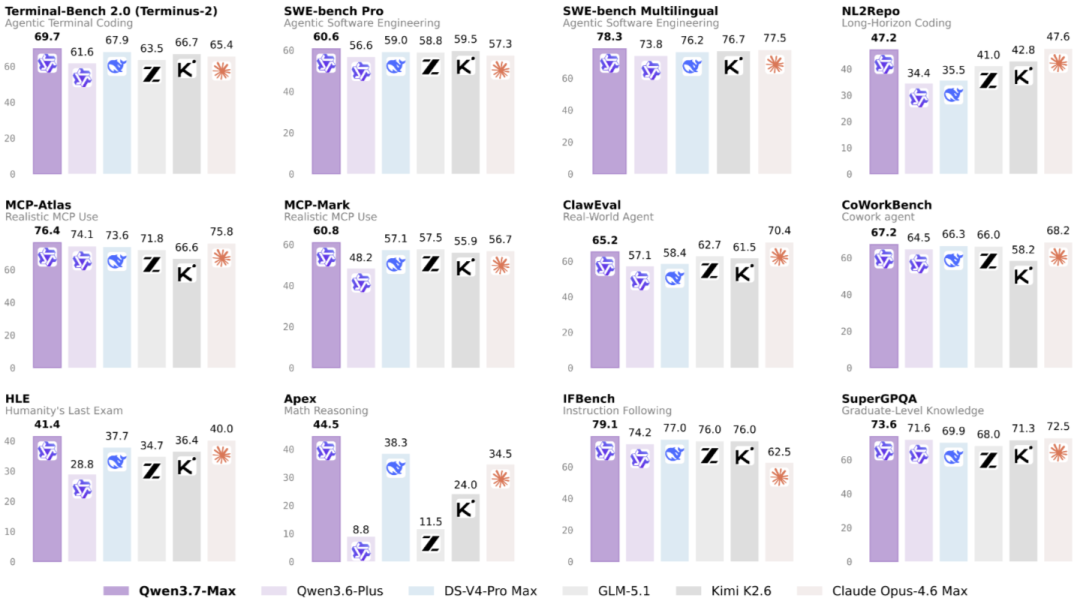
Qwen3.7-Max 与 Opus-4.6 Max、GLM-5.1 Thinking 等顶尖模型同台竞技,覆盖编程、通用 Agent、数理推理、多语言长上下文四大领域,跑分表现亮眼。
编程 Agent 领域,Terminal Bench 2.0 得分 69.7、SWE-Pro 60.6 全场最高;通用 Agent 方面,MCP-Atlas、Skillsbench 等基准超越 GLM、K2.6;
数理推理上,GPQA Diamond 92.4 分反超 Opus-4.6,数学竞赛类基准多项登顶;
长上下文 128k 检索得分 90.4,远超上一代模型。
此外模型不绑定单一框架,适配 Claude Code、Qwen Code 等各类 Agent 脚手架,通用性极强。 三、核心技术突破,环境扩展实现能力泛化
承袭 Qwen3.5 环境扩展理念,Qwen3.7-Max 进一步升级技术路径,遵循扩展律逻辑,让 Agent 模型从多样化训练环境中自主泛化能力。
随着训练环境质量与多样性提升,模型综合排名稳步逼近 Claude-4.6-Opus-Max,性能增益具备可预测性。创新将训练实例拆解为任务、脚手架、验证器三大正交组件,可自由重组搭配,迫使模型学习通用解题逻辑。
实测中更换各类 Agent 评估框架,模型表现始终稳定,真正实现换框架不用换模型。
四、超长任务自主落地,展现超强长程规划能力
长任务自主执行是 Qwen3.7-Max 最大亮点,直接将该能力推至产品级水准。
在陌生 T-Head ZW-M890 PPU 硬件平台内核优化实验中,模型不间断运行 35 小时,完成 1158 次工具调用、432 个内核版本评估,全程无人工干预,最终实现 10.0 倍几何平均加速比,远超 GLM、Kimi、DeepSeek 等竞品。 除此之外,80 小时 RL 自我监管实验中,完成万次工具调用,自主挖掘作弊案例并演化 13 条规则;YC 年度创业模拟基准里,营收达 208 万美元,是前代模型近 2 倍,长链决策中无上下文腐化、指令漂移问题。
五、全场景落地适配,开发者接入便捷
Qwen3.7-Max 覆盖办公、前端开发、游戏制作、机器人操控等多元场景,可自动修复论文格式、生成 3D 网页动画、一键制作 3D 赛车游戏,还能依托脚手架实现机器狗物理环境决策。
模型已上线阿里云 Model Studio,兼容 OpenAI、Anthropic API 协议,可无缝接入主流 Agent 框架,独有 preserve_thinking 特性,能保留多轮任务思考内容,大幅提升长链推理任务稳定性,成为开发者替代国际顶级大模型的优质国产选择。
 AI 速览