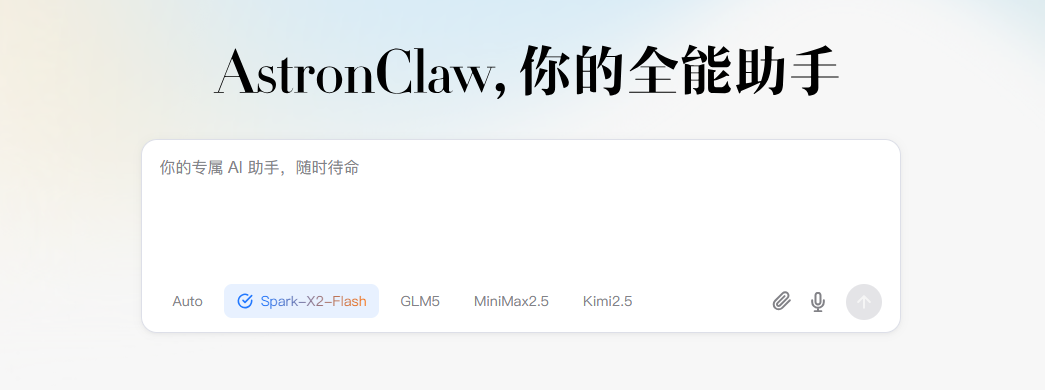
4 月 29 日消息,科大讯飞今日发布星火 X2-Flash 并同步开放 API。该模型采用 MoE 架构,总参数 30B,最大支持 256K 上下文,基于华为昇腾 910B 集群训练完成。讯飞 Agent 平台 AstronClaw 与 Loomy 已率先接入,官方称在 Agent 任务上效果接近万亿级参数模型,相同工作流下整体 token 消耗不到当前主流大尺寸模型的三分之一。
从 X2 到 X2-Flash:同一国产算力栈下的轻量分支
讯飞星火 X2 主模型在 2 月 11 日发布,采用 293B MoE 稀疏架构,对标深度推理与多语言能力,量化后单台昇腾服务器即可运行。两个半月后推出的 X2-Flash 把方向收窄,专门面向 Agent 工作流。30B 的参数体量、256K 上下文、Flash 命名,共同指向"性能旗舰+轻量调用"的双轨结构。 讯飞同时强调,X2-Flash 已实现 OpenClaw、Claude Code 等主流 Agent 框架的兼容,定位是在国产算力栈上把代码与工具调用能力以更低成本喂给智能体。 实测数据:AstronClaw 上跑长链路任务的成本
讯飞官方给出的实测来自自家 Agent 平台 AstronClaw。在深度研究报告、Skill 管理与调用、系统控制与执行等几类高频任务上,X2-Flash 效果被描述为"接近业界万亿级参数模型",同一工作流下 token 消耗不到当前主流大尺寸模型的三分之一。
官方演示中以"创建一个视频生成 Skill"为例,X2-Flash 在拿到详细需求后输出了完整的技能结构、核心功能与使用案例。Agent 工作流的 token 消耗通常被四件事拉爆:需求拆解、长上下文读取、工具调用与多轮修正。X2-Flash 的成本压缩,落点在于把这条长链路的单次调用成本压低,而不是单次回答的质量天花板。
训练侧:DSA + MTP 让长文本在 910B 上跑得动
X2-Flash 在国产算力上的两个工程数字值得单独拎出来。讯飞称,该模型率先在国产算力上把 DSA(稀疏注意力)与 MTP(多 token 预测)结合用于长文本训练,上下文拓展到 256K。配合亲和昇腾的算子与分布式策略,训练效率相比同规模 A800 集群从 20% 提升到 90%——同样训长上下文,910B 此前吞吐只有英伟达 A800 的两成,优化后追到九成。
强化学习侧的另一个数字是采样效率。Agent 长交互场景下,RL 训练长期受制于 910B 采样过慢,X2-Flash 把采样解码效率相对非 DSA 结构最高提升 2 倍以上,讯飞称这"为后续大规模 RL 对齐训练扫清算力障碍"。
数据侧,X2-Flash 依赖于一套讯飞自建的智能体数据自动合成平台,由 Agent 自主搭建环境、检测结果准确性,形成可验证的数据闭环。这是 Agent 类模型这一年普遍走的路径,讯飞这次把它放在了国产算力栈上跑。
Flash 赛道的位置
把 X2-Flash 放进 4 月底的 Flash 类模型对比里看会更清楚:DeepSeek V4-Flash 总参 284B、激活 13B、1M 上下文,4 月 24 日发布;阿里 Qwen3-Flash、混元 Hy3 等也都把"小尺寸 + 高效推理"作为今年主线。X2-Flash 30B 的参数量明显小于 V4-Flash 的 284B,256K 上下文也短于 V4 的 1M,但它的差异化卡位是国产全栈——中国主流大模型中,讯飞星火是唯一基于全国产算力训练的通用大模型,Flash 这一档此前并无国产算力对标项。 对于在本地长跑 Agent 工作流的开发者(包括 OpenClaw 这类"龙虾"用户)来说,X2-Flash 提供了一个新的选项:不必为单次任务调用一个万亿级别的远端模型,把复杂工作流拆给 30B 级别的 Flash 模型跑,成本曲线的形状会不一样。
未确认项
几项关键信息本次发布材料未披露。X2-Flash 的具体激活参数、专家数、AIME/SWE-Bench/Tau2-bench 等通用标尺的完整跑分均未给出。"接近万亿级参数模型"的对照对象、"主流大尺寸模型"的具体型号未明确。
API 价格方面,讯飞开放平台、星辰 MaaS 平台已上线 X2-Flash,星辰 Coding Plan 同步支持模型切换,但本次未公开 X2-Flash 的输入/输出 token 单价,无法直接与 V4-Flash(输入 1 元、输出 2 元/百万 token)等对手做账面对比。模型权重是否开源也未提及。
 AI 速览