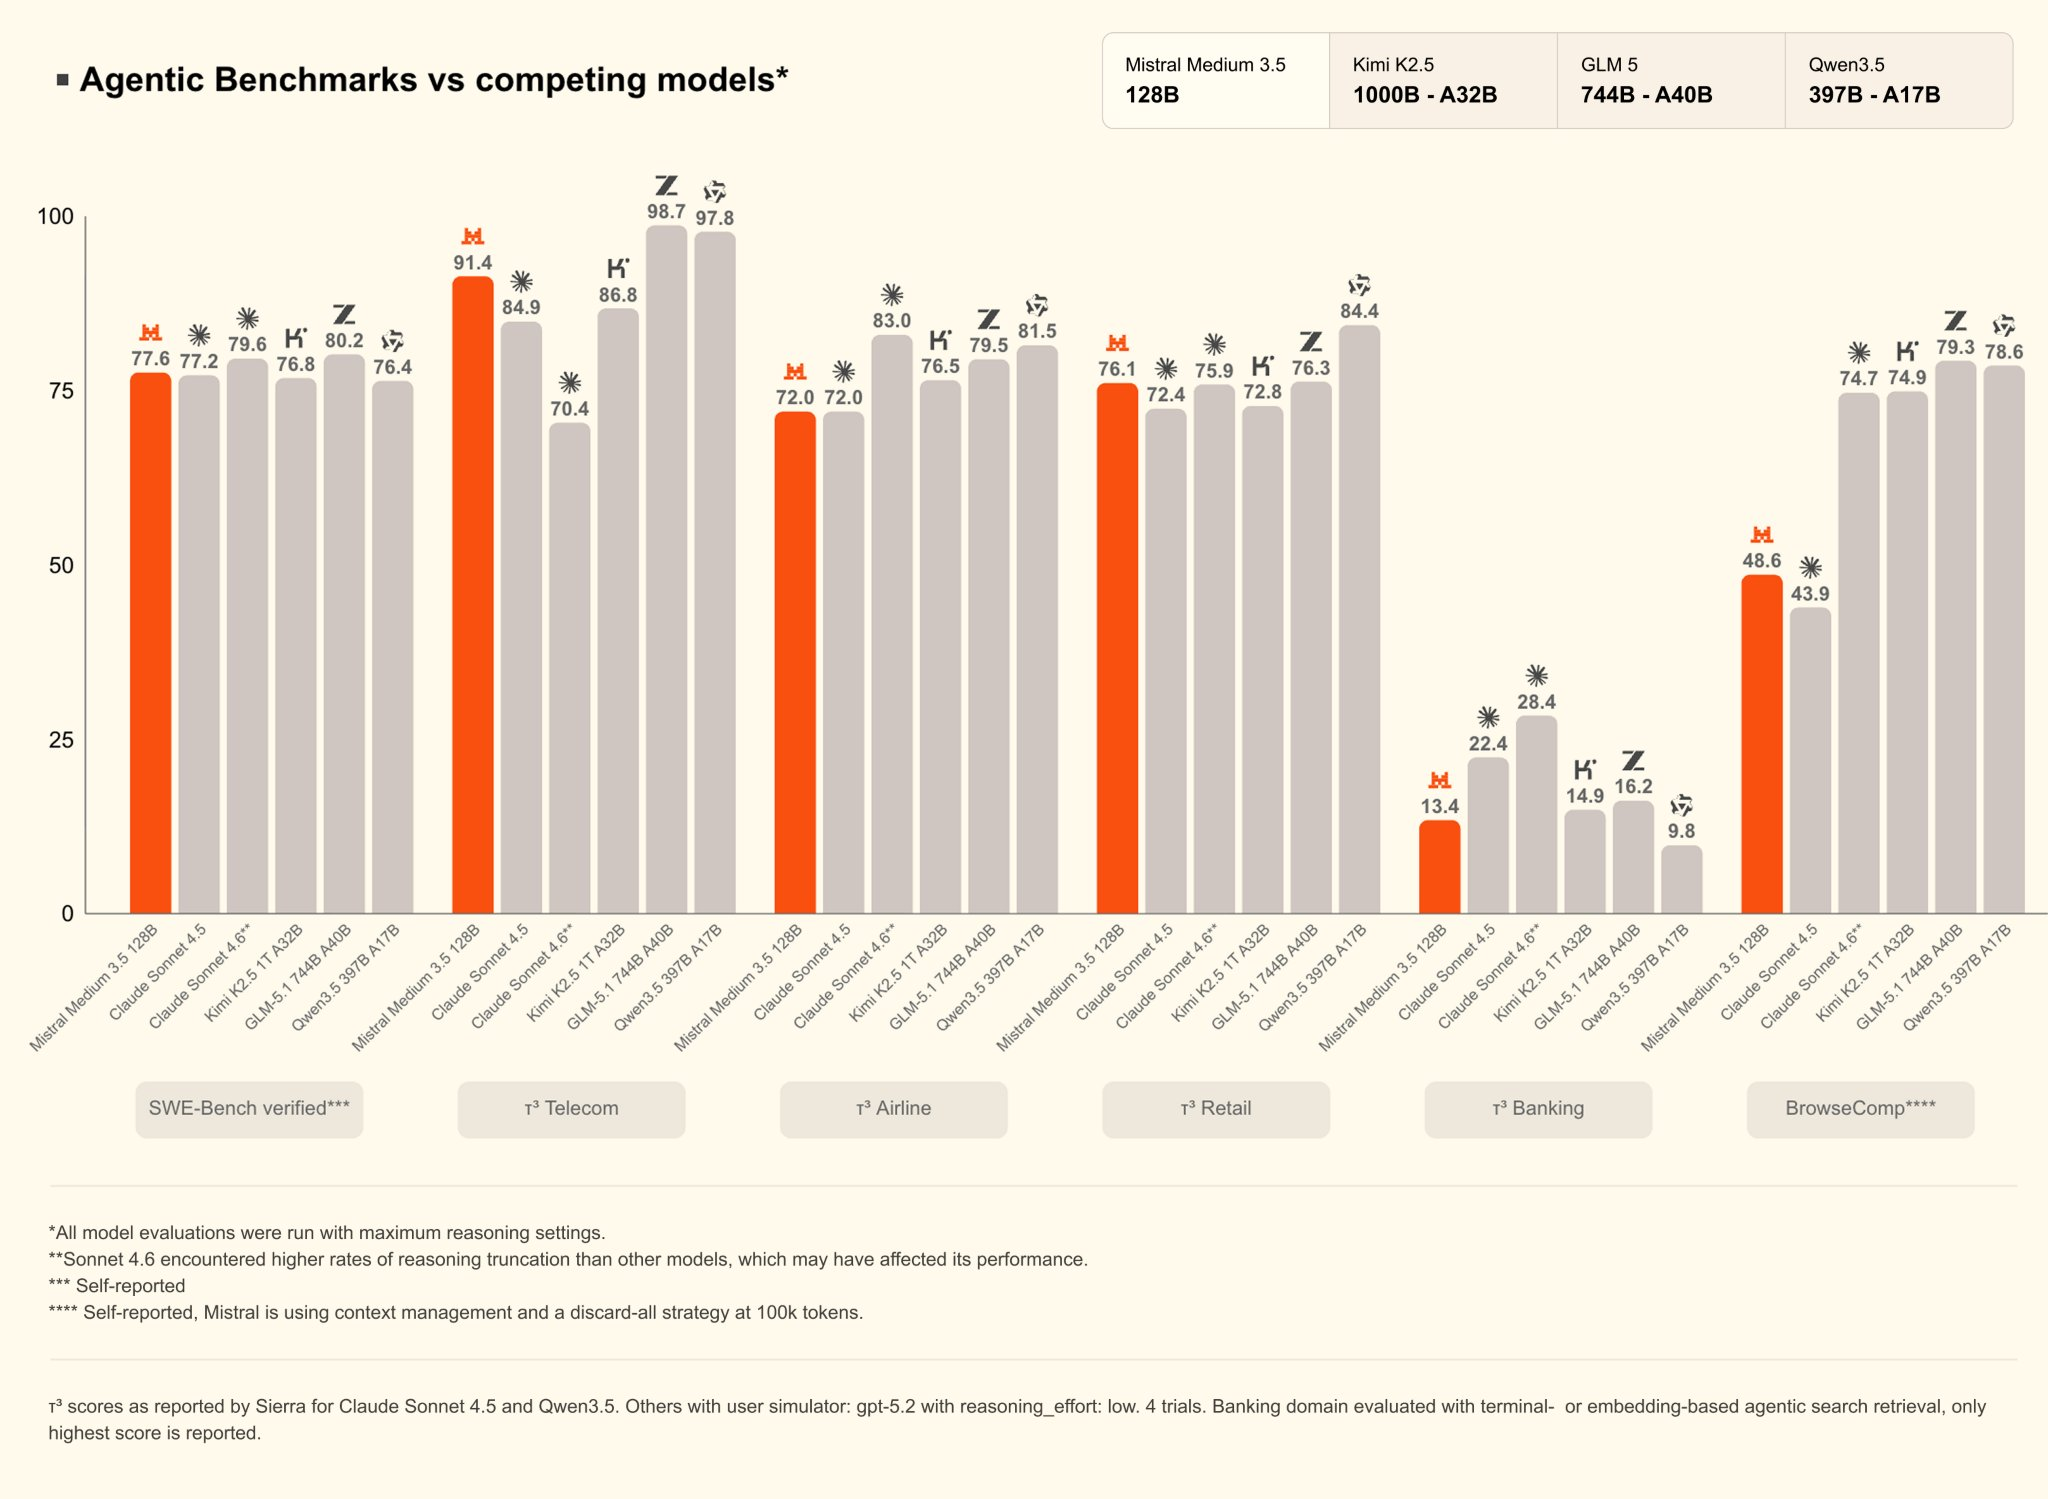
4月30日消息,Mistral AI正式发布Mistral Medium 3.5,这是该公司首款"merged"旗舰模型,单一权重同时承载指令跟随、推理与编码三类能力,并以开放权重形式登陆Hugging Face,License为Modified MIT。这次发布同时刷新了Mistral的产品矩阵——Le Chat的底层模型由Mistral Medium 3.1和Magistral切换为3.5,编码代理Vibe的底层从Devstral 2迁移过来,Le Chat的Work mode和远程代理同步上线。
架构:128B稠密+256k上下文+融合权重
Mistral Medium 3.5是一款128B参数的稠密模型,这与近期主流厂商纷纷转向MoE稀疏架构(DeepSeek V3、Qwen3-Max、Llama 4)的方向相反。256k上下文窗口,支持文本和图像输入、文本输出,覆盖24种语言。视觉编码器由Mistral从头训练,处理可变图像尺寸与宽高比。 这款模型最值得关注的设计是"merged"——指令、推理、编码三种能力压缩进同一组权重,而非维持独立的Magistral(推理)和Devstral(编码)两条产品线。每次请求可通过reasoning_effort参数在none和high之间切换:轻量对话走low cost路径,复杂代理任务调用reasoning。这种"按需推理"的形态与Anthropic的Claude Sonnet/Opus 4系列、xAI的Grok 4思考模式属于同一思路,但Mistral用单模型而非双模型实现。 底模发布同时,Mistral释出了配套的EAGLE模型用于speculative decoding加速,推荐用vLLM或SGLang部署。Hugging Face仓库中给出了fp8量化版本,部署文档明确支持Hopper(H100/H200)与Blackwell(B200/B300)双代GPU。
benchmark与定价:正面挤压闭源中端
按官方数据,Mistral Medium 3.5在SWE-Bench Verified上得到77.6%,τ³-Telecom达到91.4%,在编码维度全面超越前代Devstral。这两个分数与近期Claude Sonnet 4.5(SWE-Bench Verified约78%)和GPT-5系列处于同一水平区间。
API定价是$1.5/百万input tokens、$7.5/百万output tokens,这是这次发布最具压力的一组数字。同等定位的Claude Sonnet 4.6报价约$3/$15,GPT-5系列在$2.5/$10附近,Gemini 2.5 Pro在$1.25/$10。Mistral把开源权重和与闭源旗舰对位的API同时摆出来,等于把"自托管"和"开箱即用"两条路一并占住。 自托管门槛方面,官方称在4块GPU上即可运行。Unsloth提供的Dynamic 4-bit GGUF版本进一步把硬件需求拉低到64GB内存级别,llama.cpp可跑。这个门槛仍然高于Llama 3.3 70B的家用消费级路径,但低于DeepSeek V3 671B这类需要多机集群的MoE大模型。
Le Chat的Work mode与Vibe远程代理
Mistral Medium 3.5不仅是模型层更新,也带动了Le Chat的产品形态调整。Le Chat新增Work mode,基于3.5搭载多步骤任务代理,可在单次请求中并行调用工具直至任务完成。Vibe编码代理引入远程代理:云端会话可由CLI或Le Chat触发,本地CLI会话也能"传送"到云端继续运行,这与Cursor、Devin的cloud agent路径方向一致。
局限与未明事项
公开材料中,Mistral尚未释出与Llama 3.3 70B Instruct、Qwen3-235B、DeepSeek V3的横向对比,也未在LMArena等第三方榜单显示成绩。Modified MIT License对高营收企业设有例外条款,具体收入门槛未在Hugging Face页面写明,大型B端用户使用前仍需走商业谈判。
中文能力是另一个需独立验证的维度。Mistral声称24语种支持,但前几代Mistral模型在中文长上下文和复杂指令上常被Qwen系列压制,这次合并后的中文表现需要等待社区测试。fp8量化版本对国内主流推理框架(vLLM、SGLang)有版本要求,transformers需≥5.4.0,Ollama的视觉GGUF暂不可用,本地多模态部署仍有不少坑要填。
整体看,Mistral Medium 3.5的开源策略对开发者利好——把过去分散在三条产品线的能力压进一个128B稠密模型,搭配可观的API价格,直接卡在Llama 3.3和Claude Sonnet 4.6之间的市场空隙。代价是稠密架构在显存和推理成本上不如同规模MoE灵活,这也将成为它和DeepSeek V3、Qwen3-Max正面竞争时的主要变量。
 AI 速览