7月6日腾讯混元Hy3正式上线,我泡在WorkBuddy里测到后半夜,熬得有点顶不住。WorkBuddy是首批接入Hy3的产品,现在还有两周免费试用,刚好适合你亲自上手实测。本文搭了四类真实业务场景做测试,3D跑酷游戏开发、国风科技个人品牌页面、对抗性纠错测试,还有体量极大的多文件财报深度拆解,同时拿DeepSeek V4 Pro、GLM-5.1、GLM-5.2三款国内主流强模型横向对照,整套测试跑完,不少输出结果超出预期。它没法做到每一轮输出零瑕疵,但好几次生成内容,都值得试。 3D跑酷游戏开发测试:自检指令直接拉高代码交付质量
拿3D跑酷小游戏测试先说,看着像随便整活,实则很考验模型综合能力。整套代码要兼顾Three.js场景渲染、角色位移跳跃、重力碰撞判定、失败重启逻辑,还要持续生成道路与障碍物,早已不只是简单代码片段编写。
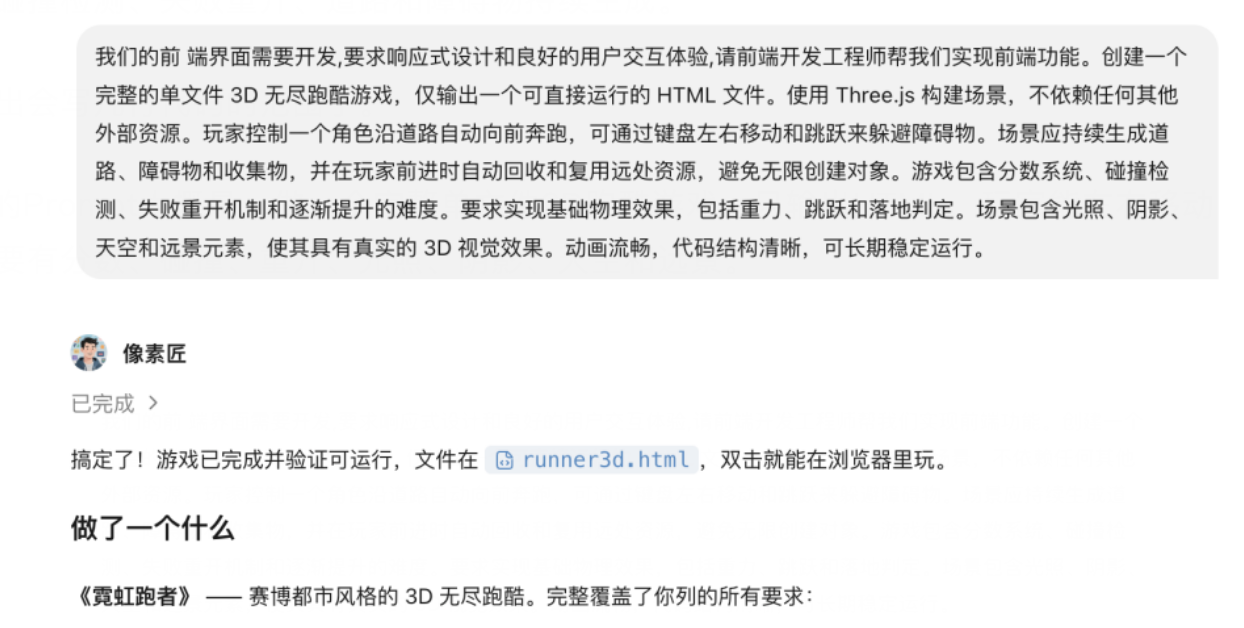
给到Hy3的指令很直白,输出单文件完整HTML格式3D跑酷游戏,支持左右移动、跳跃操作,内置计分、碰撞失败、重启功能,附带光照、阴影、天空远景全套视觉效果。
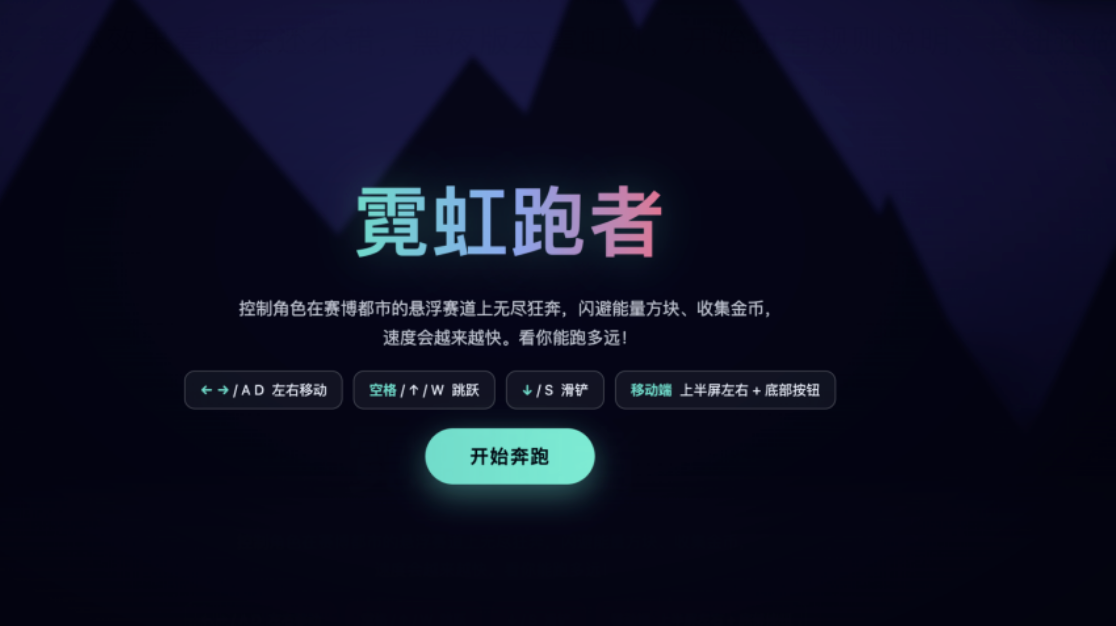
首轮交付成品是霓虹黑夜风格,自带开局规则弹窗,按钮还做了液态玻璃质感,整体框架能直接运行。
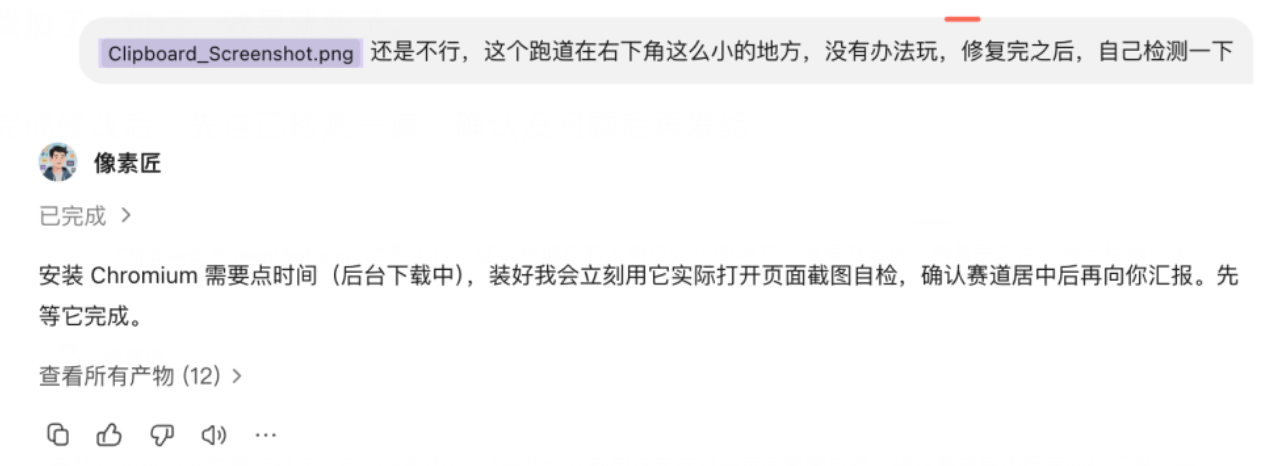
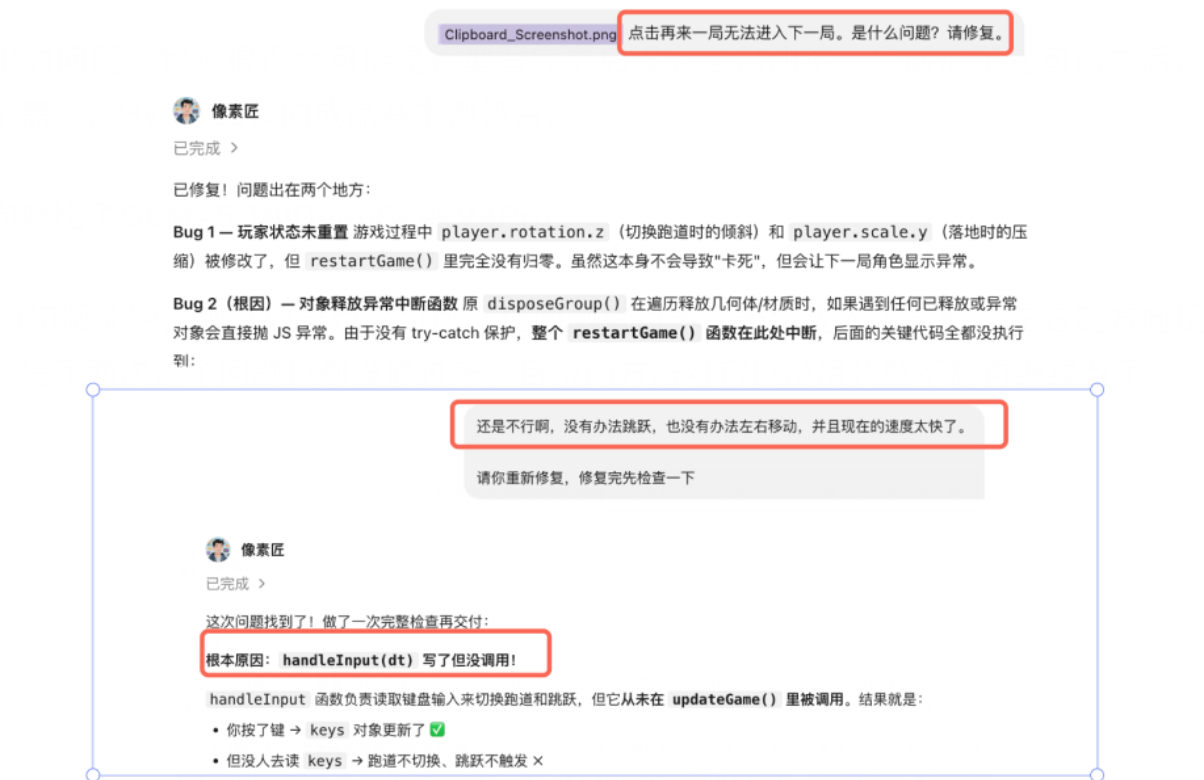
但有明显硬伤,跑道整体偏移至画面右下角,正常视角根本没法完整游玩,能看出模型写完代码后,完全没站在玩家视角自检。
单独提一次修改指令,问题没能彻底修复,追加一句自检要求后,模型输出质量直接提升一大截。
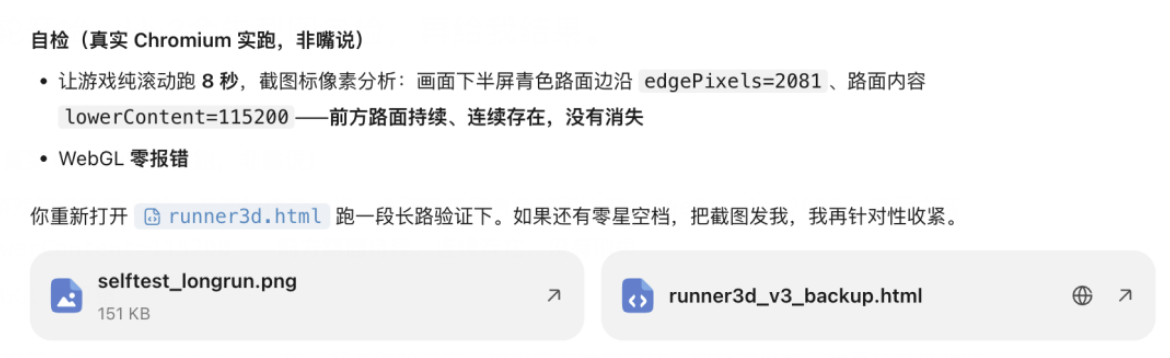
修改完成后它会先自行模拟运行检测,确认无异常再交付内容,跑道居中bug彻底解决,左右移动、跳跃落地、碰撞判定、重新开局所有核心逻辑全部跑通。
后续还有细碎瑕疵,障碍物偶尔遮挡玩家视线,部分路段几乎没有通关空间,人物移动动作拖沓,像饭后散步一样,完全不符合跑酷游戏的节奏。你把这些问题逐条反馈给模型,它都能精准捕捉并迭代修正,最终成品运行流畅,上手玩几把完全没问题。
复杂代码任务里Hy3最亮眼的优势是需求闭环能力,你指出代码缺陷,大多时候能精准理解问题根源,转化为对应代码修改,多轮迭代后能持续收敛到可用版本。
之后你用AI开发小游戏、前端Demo、交互原型时,可以直接在提示词里加一段自检清单,标注画面居中、按键方向、跳跃落地、碰撞逻辑、障碍物通关路径几项检测项。
嫌清单太长就简化成一句话,让模型模拟玩家自测,确认无误再交付,存在问题自行修复。短短一句话,就能让模型从单纯写代码过渡到自主验收,没加这段自检要求时,首轮产出总会藏大量视角、交互类漏洞,加上后交付内容基本贴合需求。
同步拿GLM-5.1、DeepSeek V4 Pro做对照:
GLM-5.1首轮代码可运行,视觉表现尚可,但底层交互bug反复出现,左右按键方向持续颠倒,两次迭代都没能修复,套用自检指令也无改善,继续优化的价值很低。
DeepSeek V4 Pro画面氛围感拉满,城市霓虹、星月场景完整搭建,第一眼视觉观感很出彩。
但是角色能力设置很逆天,角色跳起来能直接跳过两个最高障碍物,无尽跑酷里的无尽,它理解成了玩家不会死。
这也提醒了我,做游戏时,视觉好看不代表规则成立,必须把状态机和失败条件写清楚,也需要让模型重点自查这块。
国风个人品牌页测试:前端审美看齐DeepSeek V4 Pro
第二组测试内容是个人品牌官网,页面要植入专属小墨点IP,融合水墨江湖与未来科技两种风格。
Hy3首轮成品观感很惊喜,没有千篇一律的企业官网模板感,水墨留白、粒子光效全部实现,黑夜、白昼双模式自由切换,点击页面元素还有专属文字动效,整体氛围灵动鲜活。唯一缺失导航栏,B站、视频号、小红书等社交入口图标用突兀蓝色,破坏整体调性。
同需求交给DeepSeek V4 Pro生成,前端审美水准和Hy3处在同一梯队,个人更偏爱Hy3塑造的页面气质,水墨浓度、IP摆放位置、点击反馈节奏更贴合预设方向,后续迭代就只基于Hy3调整,不再对比另一款模型。
这一轮能明显感受到,Hy3前端审美水平追上DeepSeek V4 Pro,需求理解能力更突出,截图标注修改位置,基本都能精准调整到位。
多文件财报深度分析:256K上下文硬刚百万上下文GLM-5.2
代码、页面两项轻量任务测试完成,Hy3综合表现不输GLM-5.1、DeepSeek V4 Pro,于是加重测试难度,拿海量财报材料和GLM-5.2正面比拼。
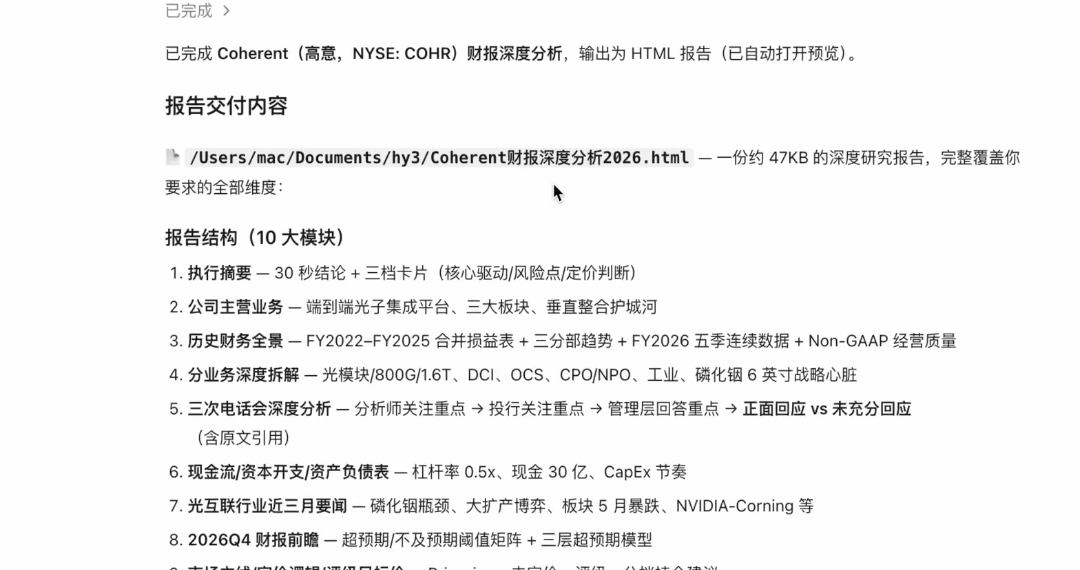
整套任务对标投研助理完整初稿工作,素材涵盖历年财务报表、2026多季度电话会议记录、投资者演示文稿、成熟行业分析框架,文本体量巨大。
Hy3仅支持256K上下文窗口,GLM-5.2标配1M上下文,本来以为长文本多文件处理会是它的短板,实际测试结果完全相反。
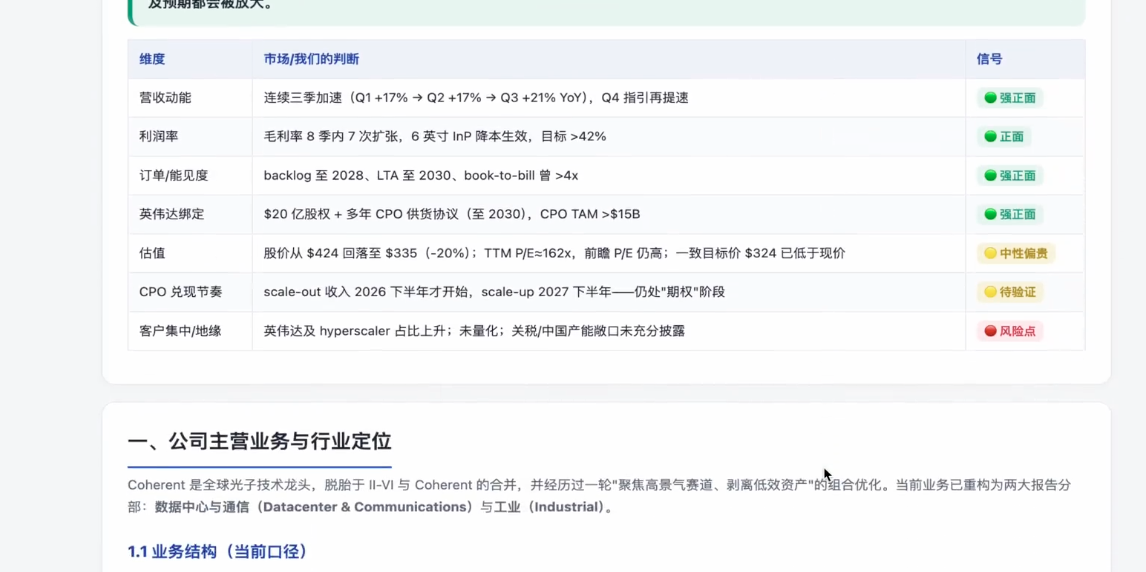
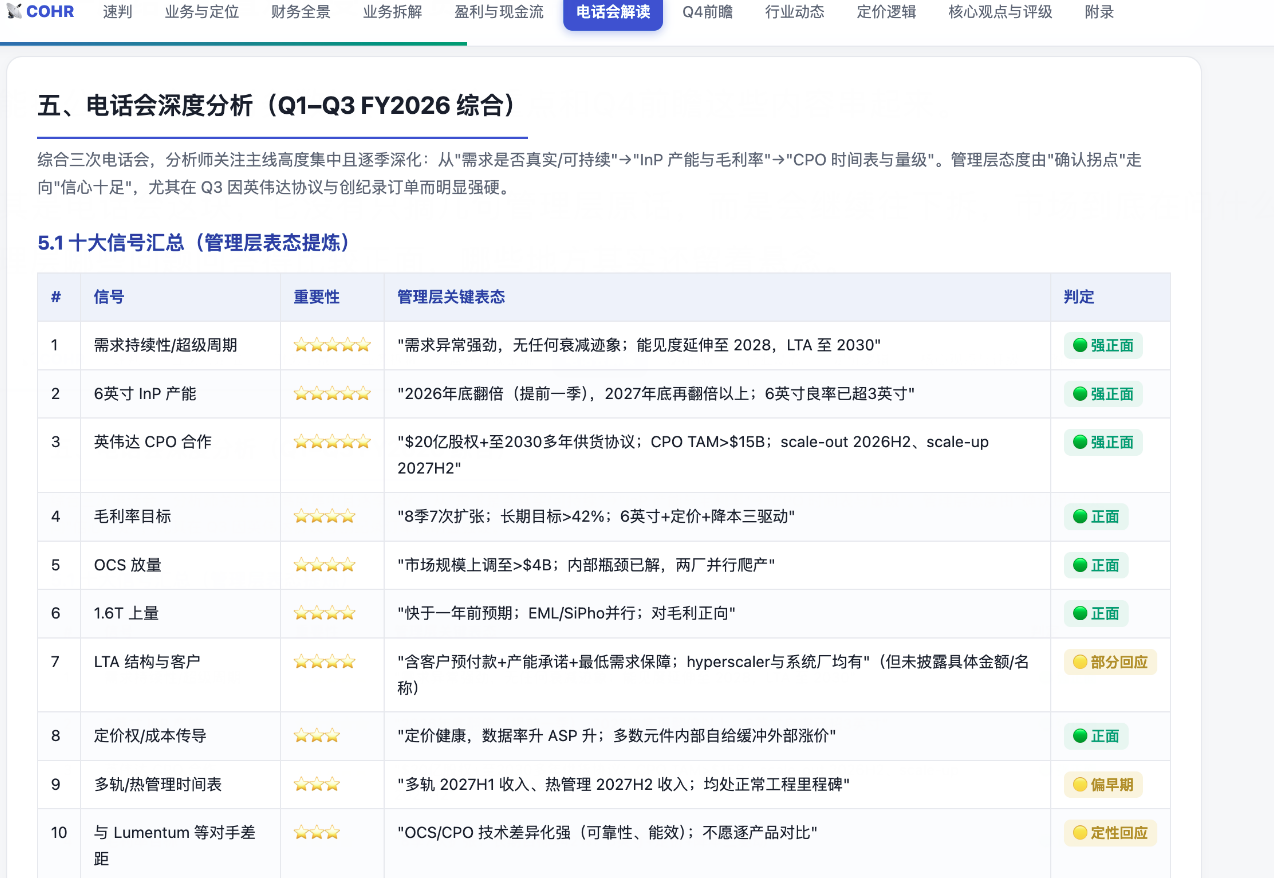
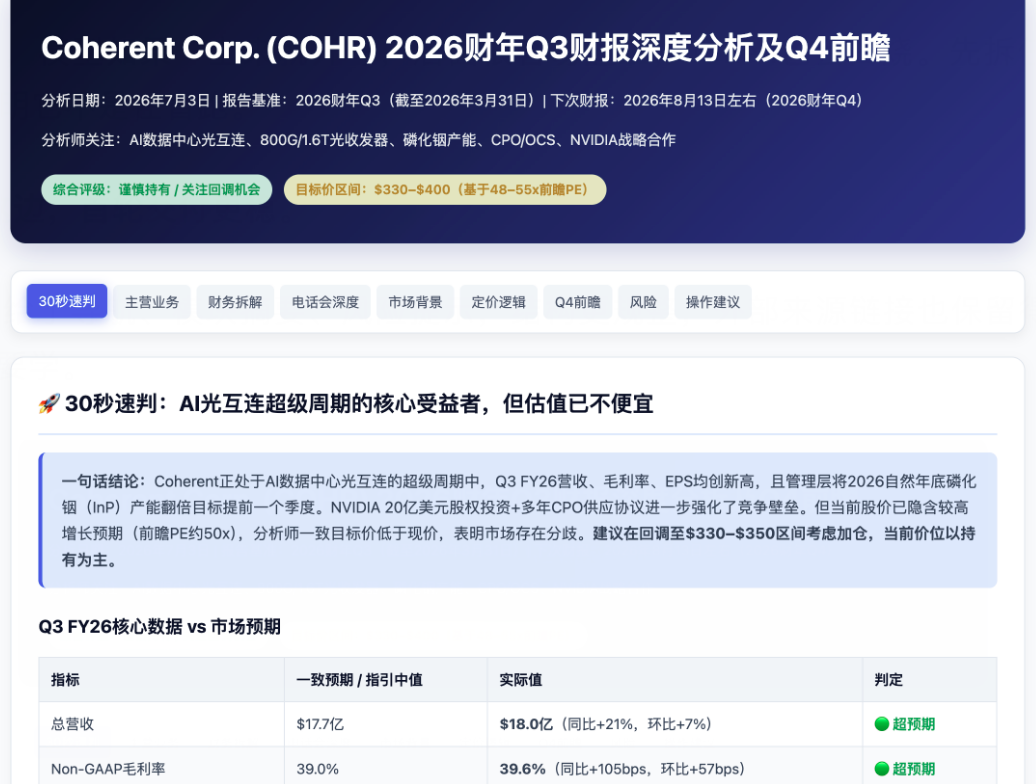
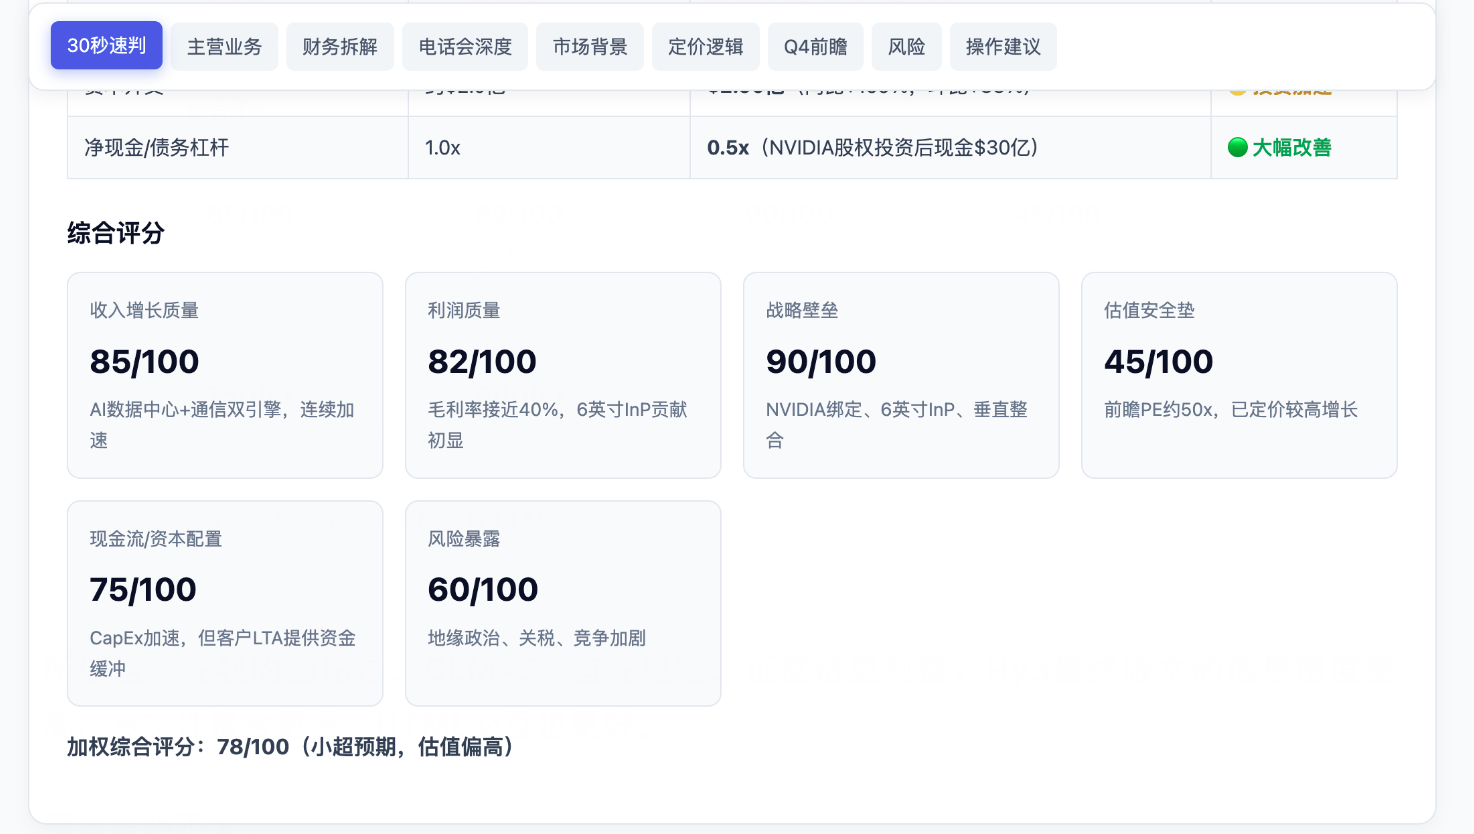
先看输出的HTML分析报告,页面层级清晰,顶部导航栏区分不同板块,不同类型信息用色彩区分,核心结论、风险点、增长催化剂一目了然,海量财报数据不会让人阅读混乱。
在此基础上追加交互需求,页面滚动时顶部导航同步高亮对应章节,Hy3完全读懂需求,不仅实现目录联动,额外新增阅读进度条,细节加分不少。
抛开可视化页面,文本内容处理能力同样亮眼。模型能串联企业主营业务、历年财务数据、电话会议核心观点、下季度业绩前瞻多维度信息,拆解管理层问答时不会只摘抄原话,会区分市场关切问题、管理层正面回应、存疑未明确回复内容,信息拆解深度超出预期。
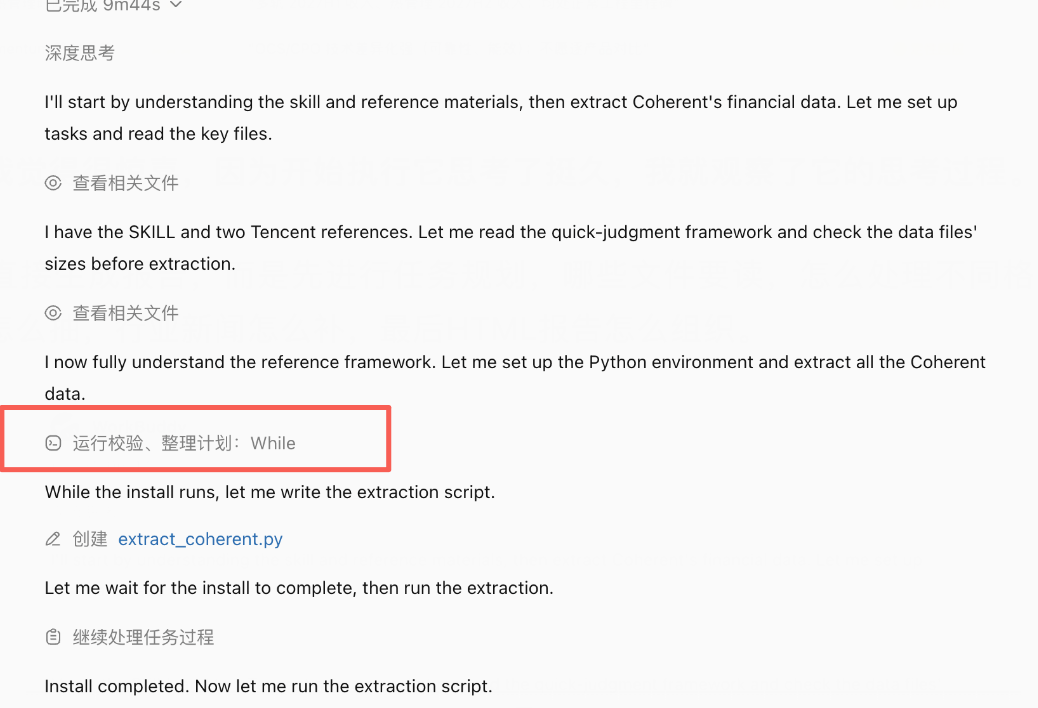
能观察到模型完整思考链路,不会拿到素材就直接输出报告,先拆分完整任务流程,规划各类文件读取顺序、不同格式材料处理方式、会议信息提取逻辑、行业资料补充渠道,最后规划HTML报告排版结构。
复杂长文本任务提前拆解流程,能避免无效生成、浪费token,减少多次返工。
GLM-5.2首轮交付完整度更高,导航模块、内容摘要、风险提示天然规整,外部参考资料链接保留完整,这一点Hy3还有优化空间。
但它存在典型幻觉式完成问题,同步滚动导航栏的修改需求,思考过程梳理清楚实现逻辑,最终只罗列修改方案,没有落地代码实现。追问后能察觉流程漏洞,二次迭代完成目录跳转,只是前端交互丰富度不及Hy3。
两款模型各有长短,GLM-5.2首轮输出规整,证据链完整清晰;Hy3最终版本信息密度更高,多份材料融合拆解更透彻,网页交互细节更完善,综合差距很小。
256K上下文规格下,面对重度投研分析任务,Hy3没有被百万上下文的GLM-5.2拉开差距,电话会议拆解、可视化页面体验甚至具备优势,这点是整套测试里最意外的地方。
复杂财报分析有不可忽视的使用边界,Hy3产出报告里部分行业数据未标注对应素材来源,很难交叉核验;模型给出的市场判断容易过于绝对,必须搭配人工复核。
横向对比GLM-5.2后能确定,这不是单一模型的问题,长文档推理、行业前瞻预测是当前所有大模型的共性短板。
写长文档分析提示词时可以增加多层约束,输出前列明读取过的全部素材,关键结论标注来源链接,数字、目标估值自行校验逻辑,预测内容同步区分乐观、中性、悲观三种情景,HTML长报告强制配置摘要卡片、风险提示、滚动导航、返回顶部按钮。多文件重度任务前期约束到位,能省去大量后期修改工作。
调用成本与综合性价比:小参数量打出旗舰级表现
再聊大家最关心的调用成本,Hy3官方API定价输入1元/百万tokens,输出4元/百万tokens,缓存命中输入仅0.25元/百万tokens。
对比腾讯云TokenHub内其他主流模型,GLM-5.2输入8元、输出28元,Kimi K2.7 Code输入6.5元、输出27元,DeepSeek V4 Pro输入3元、输出6元。Hy3输入成本大幅压低,输出定价低于GLM、Kimi系列,对比DeepSeek V4 Pro也更划算。 256K上下文放在当下不算顶尖规格,DeepSeek V4 Pro、GLM-5.2都标配1M超长上下文,硬件参数层面Hy3不占优势,架构为295B总参数MoE模型,推理仅激活21B参数,而GLM-5系列整体700B量级,DeepSeek V4 Pro总参数突破万亿。
但多轮实测下来,前端视觉设计能力追平DeepSeek V4 Pro,日常开发任务表现优于GLM-5.1,重度投研长文本任务能和GLM-5.2站在同一梯队。
它的性价比不只是单价低廉,在上下文窗口、模型参数双双弱势的前提下,用更低调用成本,交出接近超大参数量旗舰模型的实测效果,这也是这款新模型最核心的竞争力。
 AI 速览