2026 年 8 月 3 日,阿里巴巴发布新一代基座大模型 Qwen3.8-Max,总参数量达 2.4 万亿,在编程、长程任务、专业工作、多模态智能体等核心场景实现能力跃升。
权威榜单显示其综合表现已跻身全球第一梯队,直逼海外顶级闭源模型,同时定价仅为头部竞品的两到四成,真正实现了高性能与低成本的兼顾,为大模型规模化落地提供了全新的高性价比选项。
一、榜单验证:综合能力入全球第一梯队,编程表现领跑
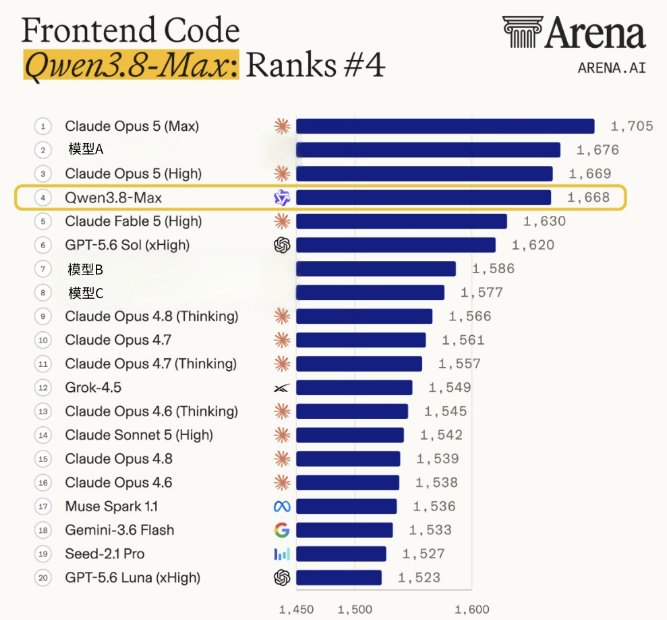
第三方权威评测 Arena 最新榜单显示,Qwen3.8-Max 已冲入全球大模型第一梯队,文本综合能力直逼 Anthropic Claude 系列。 其中前端编程能力表现尤为突出,超过了 Claude Opus 5 与 Fable 5 的 High 版本,成为国产大模型在代码领域的又一标杆。
从能力定位来看,2.4 万亿参数的架构并非单纯的参数堆叠,而是针对性强化了真实生产场景的落地能力:编程端到端交付、长线程任务自主规划、专业文档批量处理、多模态长内容消化四大维度均实现质的提升,跳出了单纯刷基准跑分的迭代逻辑,更贴近真实工作流的实际需求。
二、实测验证:全场景端到端交付,复杂任务自主闭环
实测验证显示,Qwen3.8-Max 已具备完整的自主任务执行能力,而非单纯的内容生成工具。在编程开发场景,模型可实现从需求到成品的全流程自主交付。
官方极端测试中,它可从空文件夹出发,在无人干预的情况下持续推进十几天,最终交付完整可用的项目。
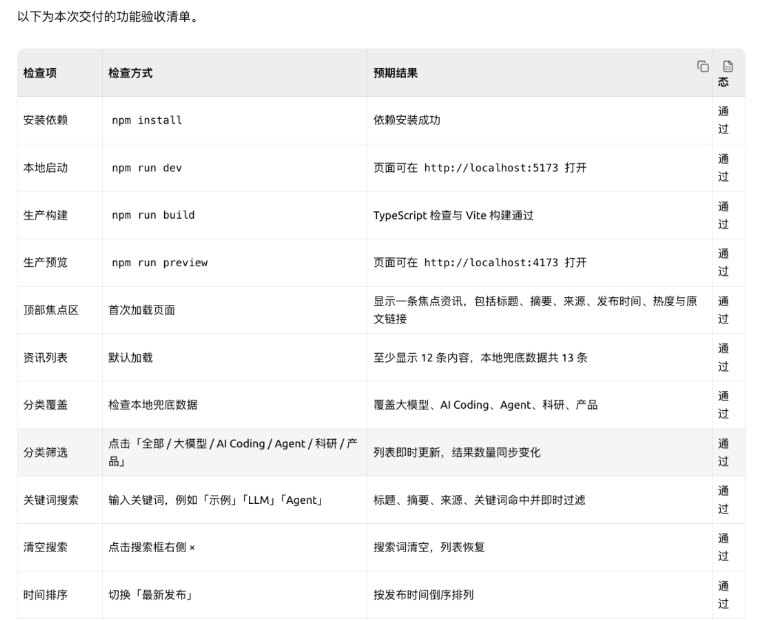
实测中,面对一整页包含功能、技术、验收标准的复杂产品需求,模型仅用 5 分钟便输出了可直接运行的资讯网页项目,全程自主完成需求拆解、技术选型、报错排查、功能验收,甚至附带了完整的问题解决记录与验收清单。
在长文档分析场景,它可完成跨章节、跨介质的深度交叉分析。针对几十页包含正文、表格、附录的学术论文,模型仅用 33 秒便精准回答了需结合多处数据对比的复杂问题,并同步生成带原文证据的结构化分析报告。
在多模态场景,它可高效处理长时长音视频内容。针对近 70 分钟的播客内容,模型快速梳理出完整叙事结构,生成带精准时间戳的主题观点轴,支持直接定位对应原始片段,大幅提升长内容的信息提取效率。
三、定价优势:成本仅为头部竞品两成,撬动规模化落地
性能对标顶级闭源模型的同时,Qwen3.8-Max 的定价极具竞争力。
国内市场每百万 Token 输入定价 12 元、输出 36 元,隐式缓存命中仅需 1.5 元;国际市场输入、输出价格分别仅为 Claude Opus 5 的 40% 与 24%。
这种 “高性能 + 低价格” 的组合,直接拉低了高 Token 消耗场景的落地门槛。长程 Agent 开发、批量法律文档标注、大规模内容处理等此前因算力成本难以规模化的业务,如今可实现常态化落地,企业无需再为控制预算牺牲任务复杂度与完成质量。
四、生态打底:持续迭代的开源体系支撑长期演进
Qwen3.8-Max 的能力跃迁并非孤立产品更新,背后是成熟的开源生态体系支撑。
自 2023 年开源至今,阿里 Qwen 系列已累计开源 400 余款模型,衍生模型超 20 万个,累计下载量突破 10 亿次,是全球规模最大、覆盖最广的开源大模型家族。从 Qwen3 到 Qwen3.5 再到 Qwen3.8,系列模型保持高频稳定迭代,能力边界从基础推理逐步延伸至编程、专业工作、长程 Agent、端到端交付等复杂场景。持续的技术积累与社区生态,也为模型后续的场景优化与垂直落地提供了充足后劲。
 AI 速览