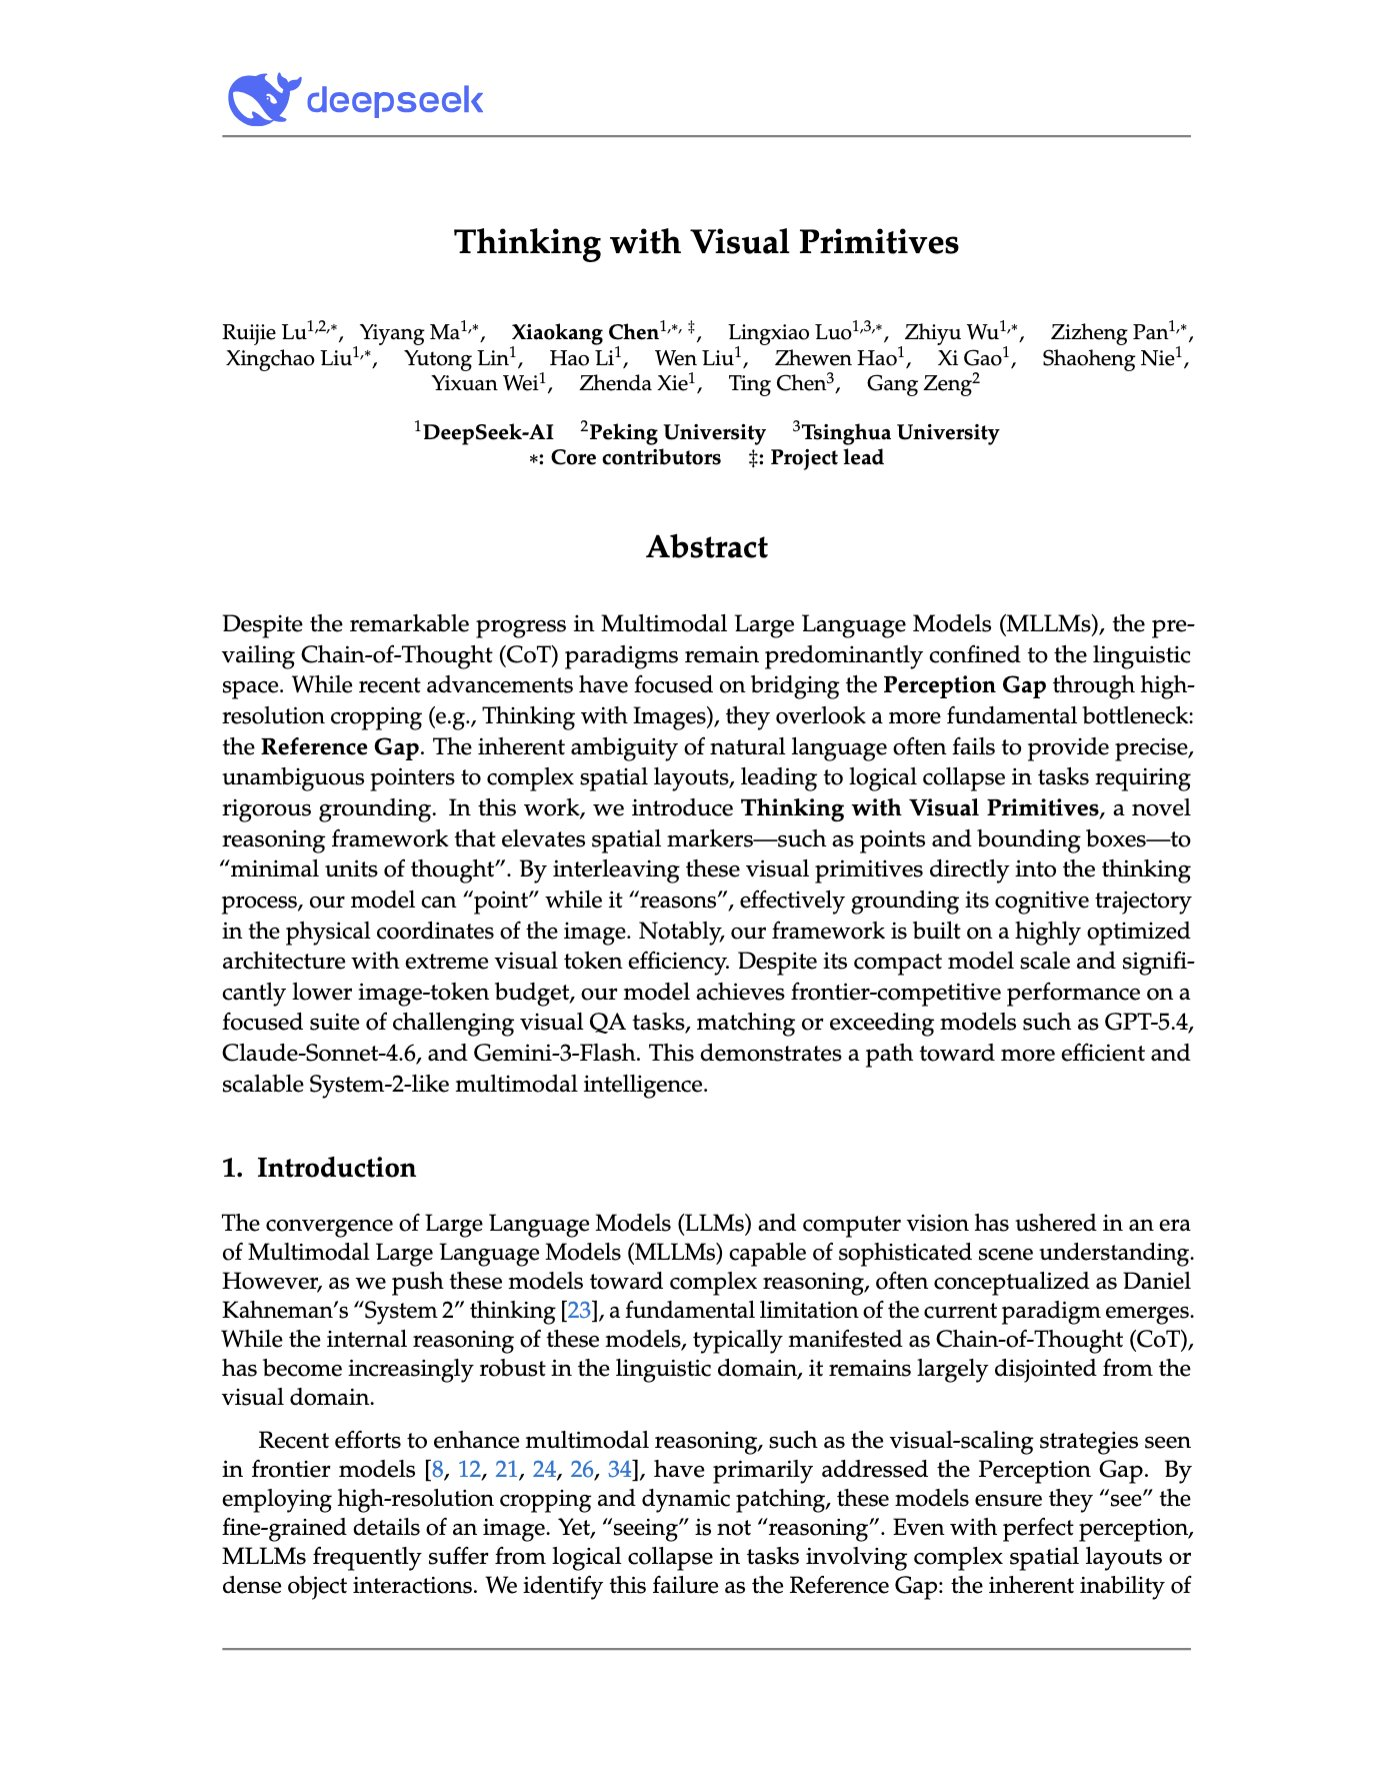
5月1日消息,DeepSeek研究员陈小康在X发布推文,配图是DeepSeek鲸鱼logo摘下眼罩露出眼睛,并附上一篇此前从未公开的多模态技术论文《Thinking with Visual Primitives》(用视觉原语思考)。论文由DeepSeek联合北京大学、清华大学撰写,是该公司首次系统披露视觉推理能力的技术报告。但发布数小时后,论文与GitHub仓库(deepseek-ai/Thinking-with-Visual-Primitives)双双被悄悄撤下,官方未给出任何解释,第三方留存的PDF文件成为外界研究这套方案的唯一渠道。 把坐标点和边界框塞进思维链
论文的核心做法可以用一句话概括:把空间标记——坐标点(point)和边界框(bounding box)——提升为模型思维链中的"最小思考单元",与文字交织出现。以前的多模态模型把坐标当作最终答案输出("目标在这里"),DeepSeek这套方法则把坐标变成草稿纸上的标记,嵌入推理过程本身。
模型底座是DeepSeek-V4-Flash,MoE架构,总参数284B,推理时仅激活13B。视觉编码部分采用自研DeepSeek-ViT,支持任意分辨率输入,先以14×14的patch切分图像,再在ViT输出端做3×3空间token压缩,并配合KV Cache 4倍压缩,三级压缩后800×800的图像只需保留约90个KV cache条目,token效率显著高于堆分辨率、堆图像token的主流路线。
论文区分了两个常被混用的概念:感知鸿沟(Perception Gap)和引用鸿沟(Reference Gap)。过去两年OpenAI、Google、Anthropic的改进集中在让模型"看得更清楚"——高分辨率裁切、动态分块、把图片放大塞进去,本质都在弥合感知鸿沟。DeepSeek则认为,看清楚不等于能精确说出指代的对象,纯文字描述容易产生歧义和幻觉,把坐标和框作为"认知锚点"嵌入推理步骤,才能模拟人类"边指边想"的协同机制。
11项benchmark均分77.2%,迷宫导航领先约16个百分点
论文在7项公开基准和4项自建基准上做了横评,模型平均得分77.2%,为所有被测模型中最高,在计数、空间推理、拓扑推理等维度上达到或超过GPT-5.4、Claude-Sonnet-4.6、Gemini-3-Flash的表现。 最显著的差距出现在拓扑推理:迷宫导航任务上DeepSeek该模型取得66.9%准确率,路径追踪任务上取得56.7%,而其他被测前沿模型在迷宫导航上均未超过51%,Claude-Sonnet-4.6在路径追踪上仅30.6%。差距的来源是评分机制设计——对走迷宫这类任务,DeepSeek把过程也算进分数:每一步合法探索给分,穿墙扣分,搜索覆盖率算分,让模型没有"偷懒直接说走不通"的动力。
实际任务中,视觉原语模式呈现出与传统CoT不同的工作流。计数时先用边界框逐个圈出对象,再按颜色、位置等条件筛选,最后统计;空间关系判断时先框出涉及的物体,再判定"和左边灰色金属物体一样大"这类多跳关系;拓扑推理时用点和路径做深度优先搜索,并配合正反向验证。论文同时给出了一个跨模态推理的例子:给一张金门大桥照片问"附近有NBA球队吗?"模型先框出金门大桥,推理出这是旧金山,然后回答金州勇士队,全程未调用联网。
训练数据这块,团队从9.7万数据源筛出3.1万高质量样本,再构造出4000万条训练数据,并优先扩展边界框标注(而非点)——因为框对物体的圈定相对确定,标注一致性更高。
三类局限与"闪电撤稿"
论文自己列出了三类局限。一是受输入分辨率限制,细粒度场景下视觉原语输出偶有偏差,目标过小、细节过密或边界模糊时点和框本身就标得不准——视觉原语能改善指代,但不能替代感知,模型先得看清楚才谈得上指得准。二是拓扑推理泛化能力有限,在训练过的迷宫类型上效果好,换一种新的空间结构就可能掉链子,陈小康在已删推文里也承认"复杂拓扑推理任务的泛化还不完善"。三是视觉原语模式目前依赖显式触发词激活,模型还不能自主判断哪类问题该"伸手指来做",需要有人提醒。
被外界讨论更多的,是论文和仓库为何在发布数小时内被撤下。DeepSeek未给出任何官方说明,目前没有公开信息佐证具体原因。从时间线推测,论文发布正值DeepSeek视觉能力灰度测试阶段,X上少量获得灰度的用户已反馈出"网页原型还原度高""能把图片信息和世界知识联系起来"等差异化体验,这套技术方案与产品功能高度耦合,不排除战略节奏调整的可能。也有研究者注意到,过去DeepSeek发布的Engram(条件记忆)、mHC等论文都正常留存,"闪电发布又闪电下架"在该公司历史上较为罕见。
目前部分独立研究者已开始尝试复现关键实验。但官方原版论文和GitHub仓库尚未恢复,是否会以正式版重新发布、与多模态产品功能正式上线如何配合,DeepSeek均未给出时间表。
 AI 速览